智能体跳过工具,结构化输出为何失效
作者为基于 LangChain 的课程助手设计了 12 个用例,同时校验工具调用顺序、计算结果、引用页码和输出格式,最终通过 10 个。一个越界问题让模型自行跳过汇总工具并直接返回纯文本,暴露了输出约束对工具调用的依赖。
AI 深度解读
一个用 LangChain 搭的课程笔记 Agent 跑了 12 个测试,通过 10 个,通过率是 83.3%。两条失败记录指向不同的问题:一次是 Agent 跳过了规定的输出步骤,一次是测试把正确的错误处理判成了失败。
对做 AI 应用的程序员来说,这篇最实用的地方是作者怎么查失败。把工具调用轨迹和断言放在一起看,才能决定该修应用,还是该修测试。
一条用例要检查哪些结果才算过?
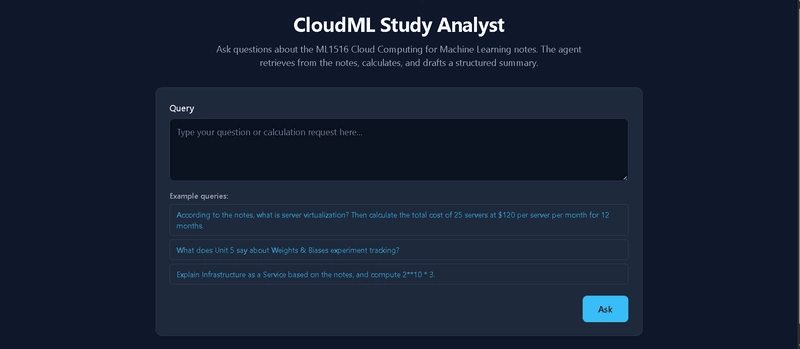
作者在 Valentius Kryptix 实习时做了 CloudML Study Analyst,用来回答机器学习课程笔记里的问题。比如,用户可以先让它解释服务器虚拟化,再算 25 台服务器以每台每月 120 美元运行一年的成本。前半段要去 ChromaDB 找笔记依据,后半段要调用安全计算器,最后用结构化摘要交付结果并标出引用页码。这个 Agent 有 3 个工具和自定义角色设定,每一步都会记录调用了什么工具、为什么调用。
12 条用例覆盖了多步任务、数据缺失、超范围问题和错误处理。每条用例预先写好预期工具和结果值,再逐项核对工具是否调用、顺序是否正确、格式是否合规、计算值和引用页码是否匹配。只要有一项不符,整条就算失败。这样,即使回答读起来没毛病,下游拿不到约定的数据结构,测试也能发现。
同样亮红灯,为什么一条修 Agent,一条修测试?
作者问「法国的首都是什么?」Agent 判断可以直接回答,于是跳过摘要工具,回了一段纯文本。对人来说,这段文字可能足够。对依赖结构化字段的调用方来说,这次响应已经违约。摘要工具由模型决定是否调用,输出格式也就跟着模型的判断走了。
另一条测试给了非法表达式 5 +* 3。Agent 返回 N/A (Invalid syntax),说明它识别出了语法无效。检查器却只找 error 这个词,于是把符合预期的错误处理判成了失败。这里该修的是断言:检查有没有拒绝无效计算,以及有没有给出预期的错误状态。
工具轨迹在这两条用例里回答了两个具体问题:摘要步骤有没有执行,非法输入有没有被正确处理。只看通过率,两条失败没有区别。
我的判断
最该保留的是作者对失败逐条归因的做法。83.3% 是这 12 条用例按原检查器跑出的分数,其中包含一条误判。原文没给修正断言后的复跑结果,也没给重复运行或其他方案的对照数据。它能说明这轮测试找到了什么问题,至于这些问题出现得有多频繁,原文还答不了。
工具顺序要不要写进断言,取决于它是不是业务要求。需要先查笔记再引用时,顺序值得检查。两条检索路径都能拿到正确依据时,锁死步骤会让正常改动也触发失败。相比只看最终答案,轨迹更适合定位过程问题。相比要求模型主动调用摘要工具,固定的响应出口更适合承接前端依赖的字段。这些是从案例推出来的工程取舍,作者没有实测比较。
能拿来做什么
- 给直接回答、超范围和工具报错各留一条用例。如果前端按固定字段渲染,就在 Node 响应出口统一校验结构,覆盖模型跳过工具的分支。
- 给非法计算定义可检查的错误状态。需要稳定状态码时就在接口里约定,用户提示文案可以独立调整。
- 在用例报告旁保留每次工具调用及其理由。断言失败时,结合轨迹检查问题出在调用、返回值还是检查器。
- 给工具循环设上限,并在执行前校验输入。笔记里缺少每 GB 单价时,直接返回缺失项,并把这种情况放进回归用例。