DeepSeek 全栈 API 经兼容网关接入实测
作者实测一个 OpenAI 兼容网关,语音转文字可直接使用,文字转语音需更换模型 ID。网页搜索和 URL 读取只返回工具调用,需自行执行,官方文档中的模型 ID 在该网关返回 404。
AI 深度解读
DeepSeek 在 2026 年 11 月 13 日推出「全栈 API」,把网页搜索、URL 阅读、OCR、语音转文字和文字转语音做成可调用的能力。已经接了 OpenAI 兼容网关的团队,能不能沿用现有 SDK,把这些功能直接打开?
作者用 Crazyrouter 做了五项检查。语音转文字直接可用,文字转语音和聊天模型各要换一个模型 ID,搜索和读网页则要自己补执行环节。最容易误判的是搜索,接口返回 HTTP 200,模型也给出了像样的查询词,但网页压根没被搜回来。
先确认网关认得哪个模型名
作者在 2026 年 11 月 17 日测试了 Crazyrouter 的 /v1/chat/completions,11 月 20 日复测 URL 阅读。网关把官方文档里的 deepseek-flash 拒了,返回 404,错误是 model_not_found: Model deepseek-flash is not provided by Crazyrouter。换成网关目录里的 deepseek-v4.1-flash,请求就通了。按作者当时的记录,搜索只在 flash 档开放,换模型名时也得核对目标档位是否支持工具调用。
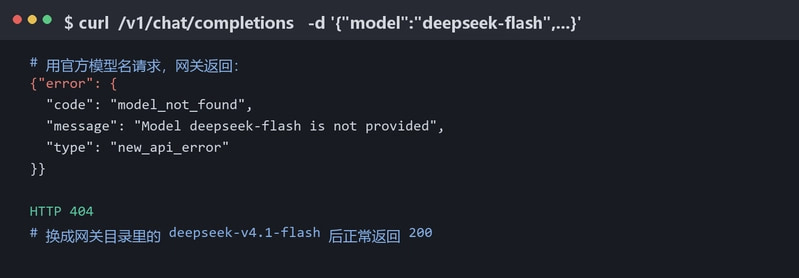
这里的五项检查包括一次模型名验证。发布时列出的 OCR 没进实测,深度思考搜索、文件输入和安全检查也在测试范围之外。作者的记录覆盖的是这个网关的具体接入情况。
语音能直接用到什么程度
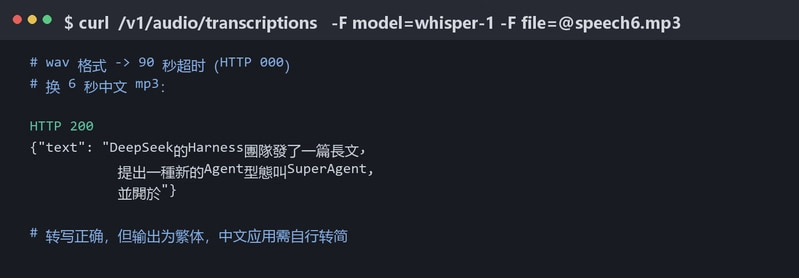
语音转文字(STT)是最顺的一项。作者用 whisper-1 转录一段 6 秒的中文音频,MP3 很快返回 HTTP 200,转录准确。同一项测试里,WAV 等了 90 秒仍超时,工具显示 HTTP 000。还有一个产品细节,转录结果是繁体中文。如果界面和后续处理统一用简体,应用侧得安排一次转换。
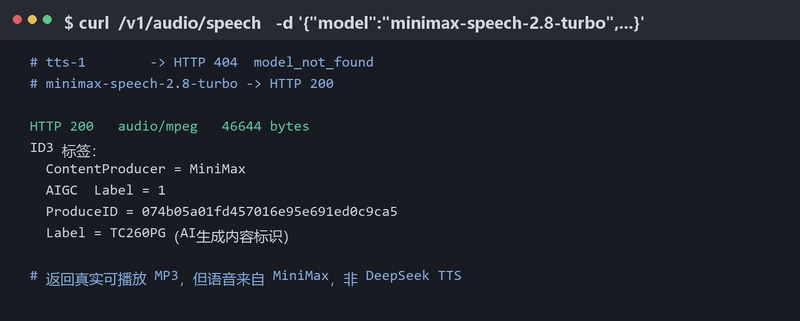
文字转语音(TTS)也能用,但文档里的 tts-1 在网关返回 404。改用 minimax-speech-2.8-turbo 后,作者拿到了能播放的 46 KB MP3,ID3 标签里有 ContentProducer=MiniMax 和 AIGC 标记。网关也列出了 minimax-speech-2.8-hd,原文给出实测结果的是 turbo。对产品文档来说,供应商应标成 MiniMax,这份音频由网关接入的 MiniMax 模型生成。
搜索返回了 tool_calls,谁去搜网页
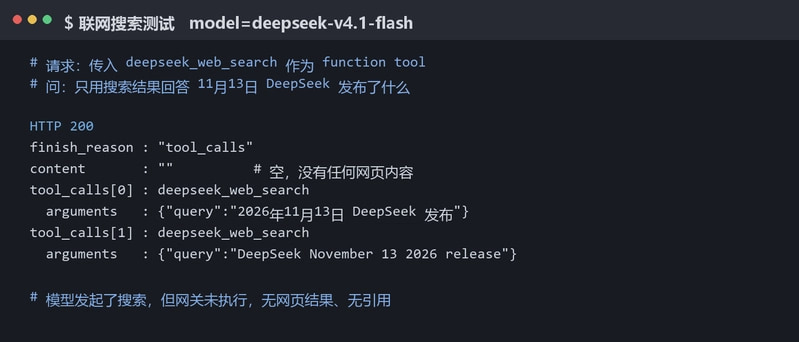
作者把 deepseek_web_search 声明为函数工具,问 DeepSeek 在 11 月 13 日发布了什么,并要求模型别靠记忆回答。网关返回 HTTP 200,finish_reason = tool_calls,两个调用的 arguments 里都有实际查询词。但 content 是空的。tool_calls 在这里相当于模型交给应用的一张待办单,应用接下来得调用搜索服务,把结果放进 tool 消息,再发第二次请求,让模型据此作答。
读网页走的是同一条路。作者把官方公告 URL 交给 deepseek_read_url,拿到了 tool_calls 和一句表示要读网页的话,页面正文一字也没回来。直接传内置的 type: web_search 会收到 400 invalid_request_params,内置 read_url 同样返回 400 参数错误。按原文对官方私有协议的描述,搜索和上下文拼接由 DeepSeek 服务端完成。沿用这次测试中的兼容接口,这段工作就落到了应用侧。
自己接工具,维护成本花在哪
原文把直接实测和资料中的经验分开了。时效问题来自他人的记录,一次询问「今天」发布了什么,模型找回的是 2 月的新闻。官方做法是每次请求都在用户消息前紧挨着插入固定格式的 latest_reminder,提供当日日期。有开发者加了这条消息后,命中正确日期所需的搜索次数从 12 次降到 3 次。这是单个案例,能说明为什么该把日期传进去。
另外两项取决于具体协议。按原文引用的资料,声明内置搜索、URL 阅读或安全检查时,服务端会忽略 temperature、top_p 和 thinking.budget_tokens。官方读页结果还会带加密的 signature 字段,多轮对话要原样回传。框架如果在整理历史消息时丢掉这个字段,请求仍可能成功,模型却接不上先前读过的页面。费用也要叠加算,搜索按次,语音按字符数或时长,另外还有 token 成本。原文引述的一份估算称,最低价搜索与最高价长文阅读的单次费用相差约一个数量级,文中没有给出可用于预算的具体费率。
我的判断
我认同作者把工具执行和最终结果分开验收。前端只看状态码,很容易在搜索还没执行时就显示「搜索完成」。验收时拿一个需要查证的真问题,确认服务实际取回了页面内容,再核对回答里的来源能否对应到这些内容,比单看 finish_reason 有用。
方案选择仍要看团队已经有什么。如果产品高度依赖搜索和读页,原文把官方 API api.deepseek.com 列为省接线的选项。已有多供应商网关、主要做聊天和语音的团队,则可以先在需要搜索的流程里接独立 Search 端点,或自己完成工具调用往返。原文没有给出官方 API 和网关的同题对照,也没有测结构化输出、批量转录或不同音频编码。官方路径能省多少时间、WAV 超时能否复现,都还需要结合自己的链路验证。
能拿来做什么
- 如果 Node 服务已经用 OpenAI 兼容 SDK,把网关配置和模型 ID 一起管理。用一条实际请求确认
deepseek-v4.1-flash能用,再验证目标档位的工具调用。 - 如果要做带搜索的 AI 助手,让后端处理从
tool_calls到tool消息的往返。前端分别展示正在检索和生成答案,验收时检查页面内容与引用是否对应。 - 如果要上线中文语音输入,用产品实际录制的格式试传。可以先拿 MP3 验证链路,同时用一段真实中文录音确认转录和繁简转换符合界面预期。
- 如果同一条流程既依赖采样参数或结构化输出,又要查网页,可以先独立检索,再把结果交给生成请求,并用同一个问题验证最终输出。