小团队何时该给数据仓库加一层
文章建议小团队先保留原始数据、可追溯历史的数据模型,以及编码智能体能读取的书面定义。跨系统口径初期可用映射表统一,等映射增多或出现需求不同的第二个下游再加层。
AI 深度解读
一家还没有数据专岗的创业公司,要不要一开始就搭 Bronze、Silver、Gold 三层数仓?作者建议先把钱和精力花在三件事上:留住原始数据,记录关键字段的历史,把指标口径写进仓库。两套系统需要对账时,可以从一张映射表和一个视图做起。
这个取舍和写支付回调、维护客户表、让 AI 写报表 SQL 都有关。表可以等需求稳定后再拆,但被覆盖的套餐、没留下的订单事件,等到财务来问时就很难补了。
两套系统要对账,一张映射表够吗?
奖牌架构(medallion architecture)把数据处理分成三段。Bronze 保存进入系统的数据,Silver 清洗并统一不同来源的记录,Gold 把数据整理成报表需要的形状。让这个模式流行起来的 Databricks 将它列为推荐实践,团队可以按需要采用。
假设公司在 3 月把支付从 PayPal 迁到 Stripe。同一个客户在两边各有一个 ID,同一档套餐也可能有两种写法。算全年收入时,你得知道哪些记录属于同一个客户。应用和 CRM 各自维护客户名单时,也会遇到同样的问题。Silver 承担的就是这类工作。
如果眼下只需要统一客户身份,作者建议用 customer_map 存下来源、来源 ID 和应用内客户 ID,再用一个视图把关联逻辑集中起来。下面这段 SQL 建好映射表,并找出有 Stripe 账单事件却尚未匹配的客户。
create table customer_map (
  source      text not null,          -- 'paypal', 'stripe', 'crm'
  source_id   text not null,          -- your app's id
  customer_id int  not null,          -- your app's id
  primary key (source, source_id)
);

-- Billing customers no one has matched yet. Should be zero, or shrinking.
select payload->>'customer' as stripe_customer, count(*)
from raw_arrivals r
where source = 'billing'
  and not exists (select 1 from customer_map m
                  where m.source = 'stripe' and m.source_id = r.payload->>'customer')
group by 1;
primary key (source, source_id) 把来源也纳入键,避免不同系统碰巧用了同一个 ID。查询里的 count(*) 统计的是每个未匹配客户对应的事件条数。想看还有多少客户待匹配,就数查询返回了多少组。
哪三样数据要从第一天留住?
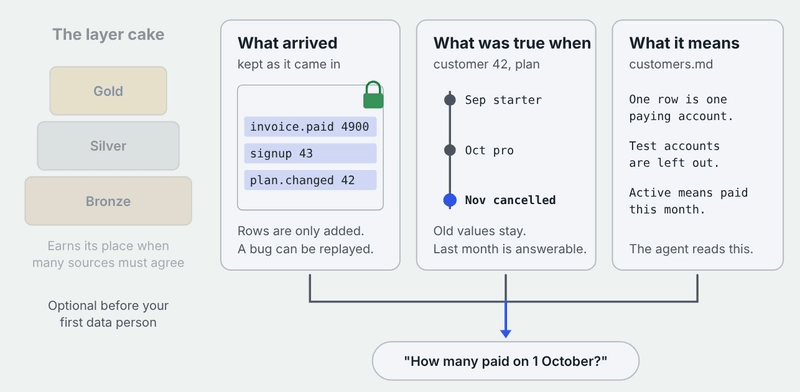
这张图是示意图。作者在 PostgreSQL 16 上跑过文中的 SQL,实验用的是一个小型测试库。
第一样是收到时的原始记录。支付或注册事件先按原样写入只追加的落地表 raw_arrivals,同时记下 received_at 和 source,再交给业务代码转换。表由管理员创建,示例给应用角色 app_writer 授予 INSERT、SELECT 和 ID 序列的 USAGE。他们用应用账号尝试修改原始记录,数据库返回 permission denied。在一次虚构数据实验中,把分当成美元的代码算出了 6,800 美元,修复后从原始事件重建,才得到正确的 68 美元。如果这个单位错误持续两个月,只存转换结果就会失去可靠的重算依据。
第二样是关键字段在什么时候是什么值。套餐、价格或状态一变,就保留旧版本的生效区间,这叫二型缓慢变化维(type 2 slowly changing dimension)。原文通过 customers_history 的 valid_from 和 valid_to 保存区间,valid_to 为 null 代表当前版本。触发器 customers_history_trg 在新增、更新或删除 customers 时调用 keep_customer_history(),用 SECURITY DEFINER 让函数以所有者权限写历史。脚本直接修改客户表时也会触发记录。删除会留下 deleted 标记,过去的版本仍可按日期查询。上线时要执行一次初始写入,给现有客户建立起点。
作者在 2026 年 11 月 20 日做的测试里,当前表显示付费客户为 0,按历史表查 2026-10-01 则有 2 位。示例用 not deleted 和 plan <> 'cancelled' 筛选。触发器每次变更会写入一条新版本,更新和删除还会关闭旧版本。作者建议把它用在客户、套餐这类低频变更的表上,避开每秒变更数千次的表。
第三样是写清指标口径。可以从 data/definitions/customers.md 的三行定义开始,说明一行代表一个付费账户还是一个人,哪些账户应排除,以及「活跃」和「付费」怎么计数。再让编码代理的指令文件指向这个目录。验收时先问「有多少活跃客户」,再追问它用了什么条件,把回答逐条和文件核对。
哪些信号说明该加一层了?
作者把判断依据放在数据由谁消费、重算要花多少钱上。映射表越来越多,每张报表都在重复同一组 JOIN,可以把统一后的数据集中起来。财务要每月结账后固定数字,产品要看今天的变化,两边就有理由各自使用按需求整理的数据。某项计算每小时重复执行,存结果比重算便宜,也值得物化。审计人员需要从报表追溯到原始记录时,明确的处理阶段能帮助他们逐步核对。
2026 年 8 月,做数仓自动化的 WhereScape 在一份从业者圆桌回顾里,把奖牌架构称为团队共用的词汇,具体实现由团队决定。沿着这个思路,作者建议上线前留原始数据、套餐和状态历史,给表补一句行定义。有首批付费客户后,把报表用到的定义补齐。账单客户与应用客户对不上的数量大于 0 且继续增长时,开始建映射表。等到每天或每周反复有人问同样的问题,再由首位数据专岗判断哪些结果应该存下来。只有一方使用、也没有定时重建需求时,可以先保留视图或按需查询。
我的判断
作者说服力最强的地方,是把建表的成本和补历史的成本分开了。以后加 Gold 表,通常还有原始数据可供重算。今天覆盖掉客户原来的套餐,明天就得靠账单或别的记录碰运气。原始事件和有效期模型因此值得提前想清楚。至于「招第一个数据专岗之前,一张映射表和一个视图通常够用」,原文没有团队间的对照数据,也没有查询成本或维护工时的比较,这是经验之谈。两组小库实验展示了重算和历史查询怎么工作。
常见的替代做法是 Node 应用在更新 customers 的同一个事务里写历史,业务语义可以写得更直接,比如标记是续费、降级还是客服调整。数据库触发器的优势是能覆盖在应用之外直接写表的脚本。两种做法都得考虑首次回填的时点。原文的初始写入用 now() 建立起点,从启用日才开始记历史。如果要回答启用前某天的套餐,需要找到当时留下的账单、事件或快照。查询里的 plan <> 'cancelled' 也只是示例口径,有免费档和试用档的团队应先定义哪些状态算付费。
能拿来做什么
- 花 10 分钟走一遍 Node 里的支付和注册事件处理链路,确认转换前的数据落在哪。用应用实际使用的数据库角色验证可写入、可读取,并确认
UPDATE和DELETE会被拒绝。 - 从
plan或status选一个字段,问一次「这个客户上个月某天是什么状态」。如果决定加历史表,就明确记录从何时开始,再用一次套餐变更和一次历史查询做验收。 - 给前端仪表盘或 AI 生成的报表写一份共用口径,明确一行代表什么、排除哪些账户、活跃和付费各怎么算。让编码代理给出计数 SQL,再对照文件检查过滤条件。
- 如果刚做过 PayPal 到 Stripe 的迁移,用映射表跟踪未匹配客户数,并把已经确认的关联收进同一个视图。观察哪些关联或报表查询开始重复,再决定是否存储中间结果。