构建元数据图,追踪数据变更影响
将数据集、字段、任务、运行记录、仪表盘和负责人建模为节点与关系,整合散落在编排、仓库及 BI 工具中的依赖信息。指南涵盖建模、元数据来源、五步构建流程及持续维护方法。
AI 深度解读
AI 能帮忙改数据管道,却不会自动告诉你:改完这一列,哪些报表、同步任务和业务指标会受影响。这篇指南讨论的元数据图,就是把散落在调度器、数仓、转换工具和 BI 里的依赖关系连起来,让变更评审有据可查。
它最有用的判断是:先统一资产命名、记录关系来源和历史,再考虑存储引擎。文章也介绍了 Datameer 的产品方案,但没有提供落地效果的对照实验,需要把工程方法与产品宣传分开看。
测试通过,为什么还要查下游
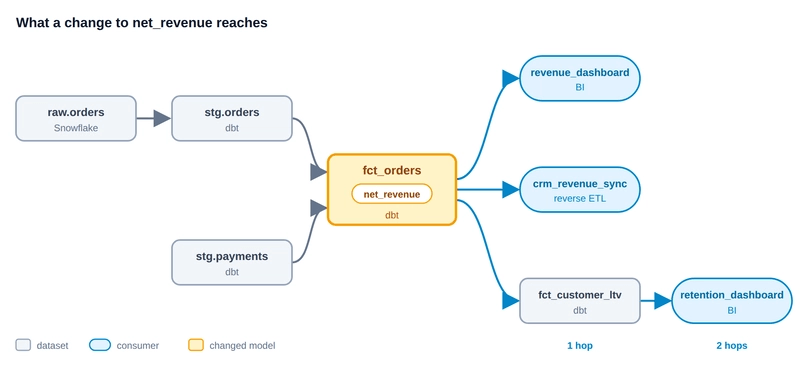
原文用一个零售分析场景解释问题:团队使用 Snowflake、dbt、Airflow、BI 工具,以及向 CRM 推送收入数据的 reverse-ETL 任务。工程师借助 AI 修改 fct_orders 模型中 net_revenue 的计算方式,测试全部通过。
但这张表还连接着收入看板、CRM 同步和客户终身价值模型,后者又连接留存看板。共四个下游资产,其中三个位于 dbt 项目之外。
测试验证了已写进断言的行为,跨工具的业务影响还需要另一份证据。
元数据图把表、列、任务、单次运行、看板和负责人作为节点,把读取、写入、列派生、运行归属、消费和所有权作为边。任务描述「要做什么」,运行描述「某次实际执行」,包含起止时间、状态和运行指标。
资产目录通常按条目展示描述、标签和负责人;图则把连接保存为可查询的数据,支持向上追来源、向下找消费者。两者并不互斥,带有血缘能力的目录也可能实现这些功能。
原文引用 dbt Labs 的 2025 年分析工程报告:56% 的受访者认为数据质量是问题,80% 在工作流中使用某种 AI。这能说明议题的重要性,却不能证明 AI 导致了质量问题,也不能证明元数据图能降低多少事故率。
关系从哪里来,哪些关系可以相信
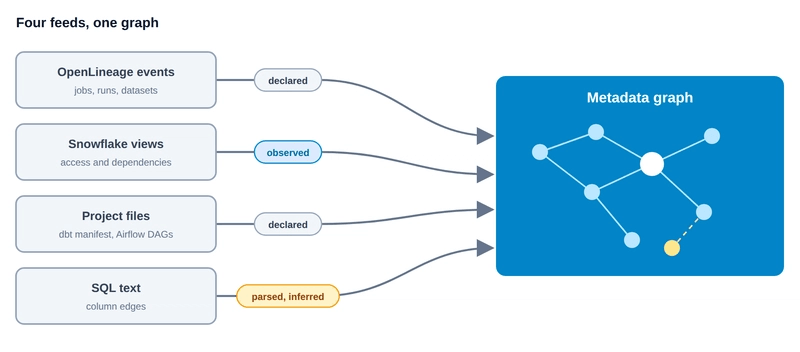
指南建议合并三类来源,因为每一类都有盲区。
第一类是 OpenLineage 事件。它定义 job、run、dataset 三个核心实体。每次运行的 runId 由客户端生成,同一次运行更新时保持不变,推荐使用 UUIDv7;常见起止状态是 START 和 COMPLETE。Facets 是附加描述,例如 schema facet 保存列结构,SQL facet 保存查询文本。
列血缘还要区分输入如何影响输出。DIRECT 表示输入参与输出值,细分为 IDENTITY、TRANSFORMATION、AGGREGATION;INDIRECT 表示输入影响结果,却不直接构成输出值,例如 JOIN、GROUP_BY、FILTER、SORT。金额列参与求和,与状态列负责筛选订单,不能记成同一种依赖。
第二类是数仓实际执行记录。Snowflake 的 ACCOUNT_USAGE.ACCESS_HISTORY 记录查询访问和修改的对象,objects_modified 中的 directSources、baseSources 可用于追踪来源,其中 baseSources 支持列血缘分析。它要求 Enterprise Edition 或更高版本,最长延迟 180 分钟,可回查 365 天。OBJECT_DEPENDENCIES 补充视图、动态表等结构关系,范围限于 Snowflake 对象。
Snowsight 也为 Enterprise Edition 账户提供血缘图,追踪 CTAS、INSERT、MERGE 等语句,保留一年对象及列血缘。但原文明确列出限制:功能于 2024 年 11 月引入,之前的数据移动不可查;彼此分离的查询造成的数据移动无法追踪;共享数据库和 SNOWFLAKE 数据库中的对象被排除。
第三类是解析 SQL,反推输出列来自哪些输入列。解析器必须理解数仓方言;遇到动态 SQL、缺少 schema 的 SELECT *,或仅凭同名列匹配,结果就可能不完整。需要猜测的边应标为 inferred。
图中没有依赖边,只能说明当前没有记录,不能直接证明没有消费者。
先让一条管道查得通,再扩大范围
原文给出的五步,可以用普通关系表实现。
第一步,统一标识。OpenLineage 用 namespace 和 name 标识 dataset,例如数仓账户与 database.schema.table 路径。若数仓里的 PROD.MARTS.FCT_ORDERS 与调度器里的 prod.marts.fct_orders 被建成两个节点,依赖链就断了。大小写和引用规则必须先统一。
第二步,接入事件与快照。通过 HTTP 接收 OpenLineage 运行事件,另设采集任务读取数仓元数据。同时记录查询发生时间和数据入库时间,避免把最多延迟 180 分钟的记录当成实时状态。
第三步,解析 SQL 生成列关系,沿用 DIRECT、INDIRECT 分类,并标记推断结果。
第四步,保存历史。为边增加 valid_from、valid_to,记录有效时间范围。这样才能回答「上周二部署前,这一列被谁使用」,而不只是展示今天的关系。
第五步,提供遍历查询。下面这段原文 SQL 从 edges(src, dst) 查找 fct_orders 的所有下游,并计算跳数:
WITH RECURSIVE downstream(node, depth) AS (
  SELECT dst, 1 FROM edges WHERE src = 'marts.fct_orders'
  UNION
  SELECT e.dst, d.depth + 1
  FROM edges e JOIN downstream d ON e.src = d.node
  WHERE d.depth < 10
)
SELECT node, MIN(depth) AS hops
FROM downstream
GROUP BY node
ORDER BY hops, node;
要留意 WHERE d.depth < 10:它限制递归深度,避免环造成无限遍历,但也截断了超过十跳的路径。按时间点查询,还需要增加有效期过滤。
在零售示例中,收入看板、客户终身价值模型、CRM 同步位于一跳,留存看板位于两跳。这是示例结果,不是生产环境的实测报告。
上线后还要维护三件事:边最后何时被确认、由哪个来源确认;它属于声明、观察、解析还是推断;哪些已知系统尚未接入。一个月前的 manifest 与三小时前的数仓记录,时效不同,证据性质也不同。
我的判断
我认同这篇指南把重点放在命名、历史、来源和覆盖范围上。图查得再快,如果把同一张表拆成两个节点,或者把推断关系当成确定事实,评审仍然会被误导。
对起步团队,普通边表加递归查询是合理选择。原文建议等遍历足够深、足够频繁,查询时间成为问题后,再考虑图数据库。但它没有给出规模、延迟或成本对照,因此这是工程经验,不能当成选型基准。
另一处取舍是列级血缘。它比表级依赖更精确,能减少无关消费者进入评审范围,代价是需要更完整的 schema、更可靠的 SQL 解析,以及持续维护。不能默认接入工具后就覆盖了所有动态行为。
文章后半段有明确的 Datameer 产品导向。按原文描述,它会在 GitHub pull request 中发布影响报告,比较 duration、result rows、result bytes、bytes scanned、records read;也支持通过 PR 线程、Slack、web chat 或 CLI,结合目录、历史元数据和 Datadog 等日志调查问题。
这些是产品能力描述,文中没有展示实施成本、解析准确率或效果对照。「新版本扫描字节数变成四倍」同样是假设场景,并非基准测试;扫描量也不能直接等同于账单增幅。
能拿来做什么
- 负责数据接口或分析管道的全栈团队,可以先选一条存在外部消费者的链路,连通源表、转换任务和看板或 CRM 同步,验证能否双向查询,再增加节点类型。
- 用 AI 修改 dbt 模型或 SQL 时,可以把受影响列及其下游清单放进 PR。测试结果与影响范围一起看,才方便评审者判断需要通知谁、补哪些验证。
- 自建采集服务时,可以先用关系表保存边,同时记录来源、最后确认时间、有效期和
inferred标记,并列出尚未接入的系统,让查询结果带着证据边界。 - 已经采集运行指标的团队,可以在评审中比较同一任务两个版本的耗时、结果行数和扫描字节数;对指标口径是否可比,原文没有展开,需要团队自行约定。