按小时租 GPU 跑大模型的操作清单
教程按显存需求介绍 RunPod GPU 选择,并给出用 Ollama、vLLM 启动模型及检查 GPU 状态的命令。提醒结束实验后停止实例,并考虑独立收取的磁盘费用。
AI 深度解读
想试一个大模型,不一定先买显卡。作者给出了一条 RunPod 按小时租 GPU 的操作路径:按显存选机器,启动后检查 GPU,再用 Ollama 跑模型,或者用 vLLM 提供 API,最后停掉实例并检查存储费用。
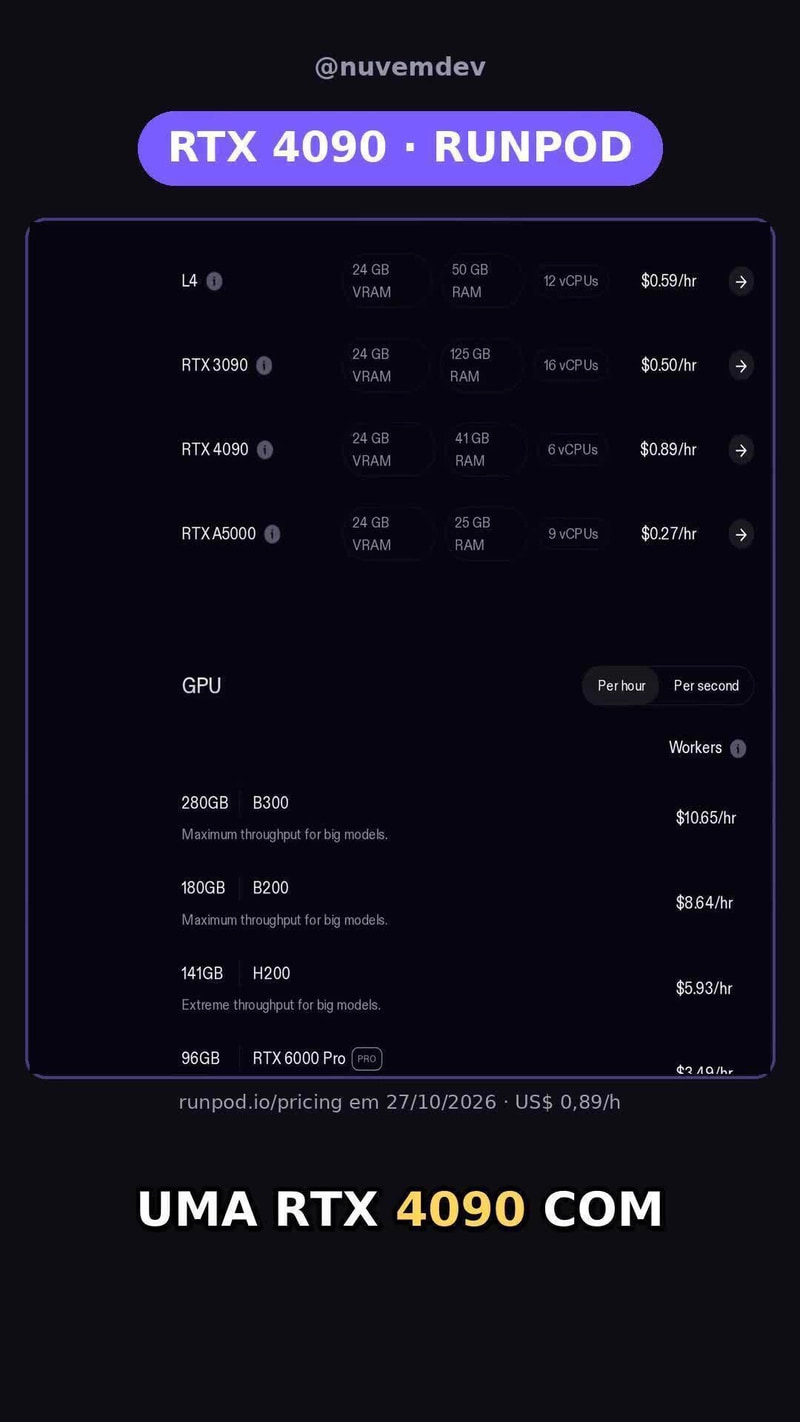
它的价值是把一次临时实验串起来,但不能当成完整的选型报告。原文给了显存经验值和启动命令,没有性能实测,也没有列出 GPU 的小时价格。读的时候,要把「能启动」和「能满足业务需求」分开看。
选 GPU,先看模型能不能装进显存
作者建议先看显存(VRAM),也就是 GPU 用来存放模型和计算数据的内存。原文给出的经验值是:量化后的 7B 到 13B 模型可以放进 24 GB 显存;量化后的 70B 模型需要更多显存,例如 80 GB。
量化可以理解为降低模型参数的存储精度,以减少内存占用。但原文没有说明量化位数、上下文长度和并发数,所以这些数字适合初筛,不能直接当容量保证。
显存装得下模型,只是实验的起点。
Pod 启动后,作者先运行 nvidia-smi,确认显卡名称和空闲显存。这里的 Pod 指租到的计算实例。先检查资源是否符合预期,再下载模型,能减少排错时的干扰。
Ollama 用来快速试跑,vLLM 用来接 API
如果目的只是下载模型、输入问题、看看输出,作者给出的 Ollama 路径很短:
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b
ollama run llama3.1:8b "Explique o que é VRAM em duas frases"
要看清第二行的 llama3.1:8b,第三行运行的是同一个模型。最后的葡萄牙语提示词要求模型用两句话解释 VRAM。
运行期间,可以在另一个终端执行 watch -n 1 nvidia-smi,每隔 1 秒查看一次 GPU 状态。这能帮助确认显卡是否在工作,但不能代替响应时间、吞吐量等性能测试。
如果要把模型接进应用,作者提供了另一条路径:用 vLLM 启动兼容 OpenAI 的 API。
pip install vllm
vllm serve Qwen/Qwen2.5-7B-Instruct --port 8000
curl http://localhost:8000/v1/models
重点是第二行:模型换成了 Qwen/Qwen2.5-7B-Instruct,服务端口指定为 8000。最后一行查询模型列表,只能验证这一接口能否访问,还没有验证完整的生成请求。
对前端和 Node 开发者,这条路径更接近日常应用联调。不过,原文没有提供客户端接入、远程访问、鉴权或依赖版本说明,不能把这三行命令理解为完整部署方案。
停掉计算实例,还要检查存储账单
按小时租 GPU 的优势,在于只为需要的计算时段付费。作者反复强调:不用了就停止 Pod。
但停机并不代表账单归零。原文称,RunPod 的闲置卷费用为 US$ 0.20/GB/月,即使 Pod 停止,卷仍单独计费。这个价格是作者标注于 2026 年 10 月 27 日核对的记录,并且会变化。
因此,实验收尾应分成两步:停止计算实例,再检查保留了哪些卷,以及是否还需要它们。只关终端窗口不构成完整的费用检查。
作者还提出一个用途划分:全天运行的聊天机器人或自动化,可以考虑费用更可预测的 VPS;短时间测试、训练或运行大模型,可以考虑按小时 GPU。原文同时指出,没有 GPU 的 VPS 只能运行小模型,但没有进一步给出配置、速度和费用对照。
我的判断
这份清单适合第一次租 GPU 做推理实验,操作顺序也合理:先确认硬件,再跑模型,最后处理资源和费用。它把容易漏掉的存储收费单独拎出来,尤其有用。
需要保留判断的是显存选型和 VPS 对比。作者没有给出具体 GPU 型号、量化配置、生成速度或同任务成本,因此这些建议属于经验之谈。两组启动命令也没有附运行结果,不能据此认定作者完成了可复现的性能验证。
原文提到训练,却只展示了推理命令,训练任务不能直接照搬。文末还有联盟营销链接,涉及服务选型时更应该结合自己的负载核算,不能仅凭「按小时」或「费用可预测」做决定。
能拿来做什么
- 第一次试跑模型时,可以从原文的
llama3.1:8b入手,先用nvidia-smi确认资源,再观察运行时的 GPU 状态,把环境问题和模型效果问题分开排查。 - 给前端或 Node 应用接自托管模型时,可以用 vLLM 建立临时联调环境;模型列表接口通过后,继续验证实际生成请求和应用需要的接口行为。
- 租机器前,先记录模型规模、量化方式、上下文长度和预期并发,把 24 GB、80 GB 当作候选范围,再验证是否够用。
- 实验结束后,把停止 Pod 和检查存储卷设为固定步骤;若准备长期运行,再根据实际使用时长比较方案费用。