用沙箱脚本压缩MCP调用上下文
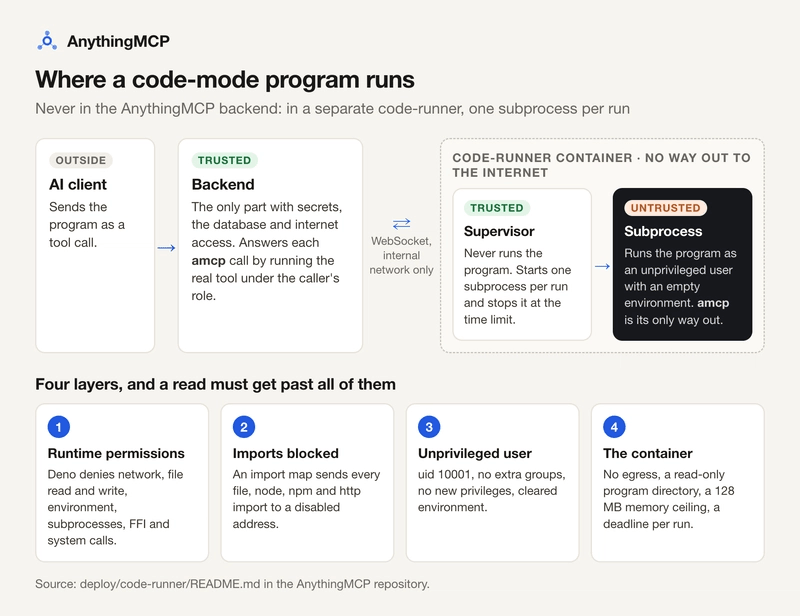
AnythingMCP 的代码模式让智能体用一段 JavaScript 编排工具调用、筛选和关联结果,只将所需信息返回模型。脚本运行于无网络、无文件和无秘密凭据的独立沙箱,只能调用调用者已有权限使用的工具。
AI 深度解读
AI 助手查了几十次工具,最后只交付几行答案,中间那些数据却都要经过模型。AnythingMCP 的 code mode 试图省下这笔上下文开销:让模型写一段 JavaScript,在隔离环境里完成查询、筛选和归组,只把最终结果交回来。
作者在一个 20 次邮编查询任务里,将进入上下文的工具结果从 7,283 字符压到 895 字符,减少约 88%。这个方向值得看,但要分清:省的是模型往返和中间数据,并没有消除底层查询,也不能据此推断所有任务都会更快、更便宜。
几十次查询,为什么只需要模型出面一次
上下文工程(context engineering)关心的是:哪些信息应该进入模型有限的上下文窗口。工具返回的大量原始数据,常常是最先挤占空间的部分。
原文举了一个 CRM 与 ERP 联查的例子:找出仍有逾期发票的客户所对应的未结报价。按作者设定,先取 40 条报价,再逐条查询客户发票,需要 41 次工具调用。如果每次结果都交给模型处理,就是 41 次模型往返,外加留在上下文中的全部结果。
code mode 把这段流程放进程序:查询报价、循环查发票、判断日期、收集命中记录。模型只需提交一次程序,再接收一次结果。
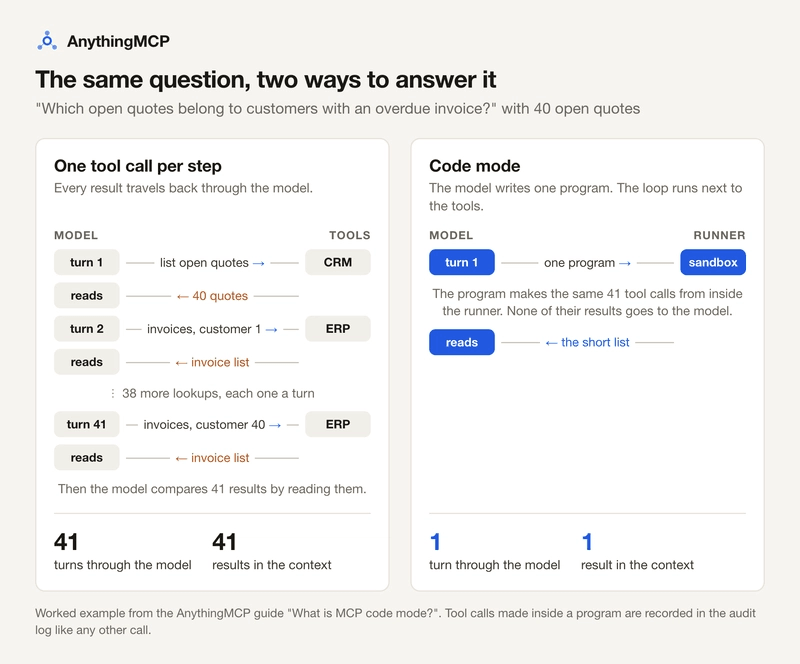
它压缩的是模型参与流程的次数,而不是业务系统实际被查询的次数。
AnythingMCP 是一个开源 MCP 网关,把企业已有的 ERP、数据库和 API 接到受统一管理的入口。程序通过 amcp.run 调用连接器里的工具,仍然沿用 MCP 和原有权限。
原文还引用了两组外部材料:Anthropic 的一个案例中,搬运两小时会议转录产生约 50,000 tokens;另一个按需读取工具定义的案例,将相关 token 从预先加载的 150,000 降至 2,000。后者讨论的是工具定义加载,不能当作 AnythingMCP 业务查询的实测收益。
88%的缩减是怎么测出来的
作者在自托管 AnythingMCP 0.55.2 上,用公开的 OpenPLZ 连接器查询 20 个德国邮编,再按联邦州归组。逐次调用产生 20 次模型往返、7,283 字符工具结果;保存为代码工具后,变成一次往返、895 字符结果。
下面是参与测量的程序。它解决的是批量查询后,只返回归组结果的问题:
const codes = String(args.postalCodes).split(",").map((c) => c.trim()).filter(Boolean);
const byState = {};
for (const postalCode of codes) {
  const rows = await amcp.run("openplz_lookup_postalcode", { postalCode });
  for (const row of rows) {
    const state = row.federalState.name;
    (byState[state] ||= []).push(postalCode + " " + row.name);
  }
}
return { codes: codes.length, byState };
关键是最后一行 return:原始查询结果留在执行环境中,模型收到的是邮编数量和归组后的内容。另外,await amcp.run(...) 位于循环内部,这份示例按顺序查询,并没有使用并发。
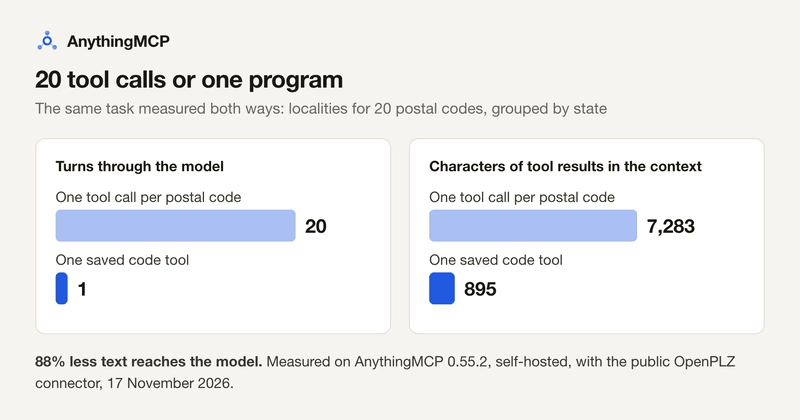
这里测量的是字符数,不能直接换算成相同比例的 token、费用或耗时。原文没有给完整费用、模型配置或端到端延迟对照。测试截图里的 Success in 1142 ms 对应五个邮编的演示,也不是上述 20 个邮编实验的性能结论。
不过,收益来源很清楚:如果任务包含重复查询、大列表匹配、跨系统求和,而答案只占原始数据的一小部分,就适合先用程序计算。单次查询没多少中间数据可省;读完合同再判断下一步检查什么,则仍然需要模型参与。
怎么接入,又怎样限制模型写出的程序
code mode 默认关闭,需要同时具备 code-runner 和某个 MCP server 的启用配置。这里的 server 是一个拥有独立连接器集合的端点。
AnythingMCP Cloud 托管 runner。自托管要求 v0.52.1 或更高版本,在 .env 中加入 COMPOSE_PROFILES=code-runner、CODE_RUNNER_URL=ws://code-runner:8777,再运行 docker compose up -d。已有 profile 时可合并为 COMPOSE_PROFILES=files,code-runner。runner 不可用时,执行会被拒绝,不会回退到后端运行。
管理员可在界面开启 Code mode,也可用 CLI:
npm i -g @anythingmcp/cli
amcp login --browser --scope admin --url https://cloud.anythingmcp.com
amcp api PUT /api/mcp-servers/$SRV --yes --data '{"codeMode":"inline"}'
要留意 {"codeMode":"inline"}:它为该 server 开启 inline 模式,之后需要重新连接 AI 客户端,让客户端发现新工具。
复用流程则可以保存为 Code Tool。在连接器的 MCP Tools 中点击 Add Tool,选择 Code Tool,填写程序、参数和 Uses (connectors)。例如 [{ "connectorId": "<OpenPLZ connector id>" }],其中连接器 ID 来自 /connectors/<id>;还可增加 tools 列表缩小范围。即使调用者本来有权访问其他工具,程序也不能越过这份名单。
保存后先用 Test 验证,再刷新客户端工具。支持远程 MCP 的 Claude、ChatGPT、Copilot、Cursor 都能把它作为普通工具调用。
临时执行用的是 code_execute。先运行 amcp login --url https://cloud.anythingmcp.com --server SERVER_ID,再通过 jq -Rs '{code: .}' program.js | amcp tools call code_execute --args - 提交文件。程序是 async function 的函数体,只能用 JavaScript 和 amcp,没有 imports 或第三方包。
安全边界也围绕这个限制展开:
- 程序运行在独立 runner 中,每次启动新的非特权子进程,不能直接访问网络、文件、环境变量、秘密或启动进程,也不能调用另一个代码工具。
- 后端代为执行每一次
amcp请求,并检查调用者角色;访问外部 API 必须先接成连接器。 - inline 程序始终只读。保存工具初始也为只读,执行时使用当前调用者权限。
- 单次默认限制为 10 秒、500 次工具调用、最多 16 个在途调用、返回值 1 MB、内存 128 MB。
模型还可以通过 code_propose_tool 提交复用建议,但提案不会执行代码,也不会自动创建工具。管理员需要在 AI Skills 的 Suggested 页检查程序,再选择 Create tool 或 Dismiss。代码工具只在工作区自己的 MCP servers 上提供,不进入共享 /mcp 端点,执行及内部工具调用均有记录。
我的判断
我认同把机械的数据处理从模型上下文里移出去。相较于逐次让模型读结果、决定下一次调用,程序更适合表达固定循环、筛选条件和关联规则。
但如果一个查询已经稳定到每周重复,常见替代方案还有后端聚合接口、数据库查询或专门的批量 MCP 工具。它们同样能减少模型往返,而且可以进一步优化底层请求。code mode 的吸引力,是在已有连接器上快速组合流程;原文没有给出它与这些方案的对照数据。
隔离设计也有明确价值。作者称仓库提供了真实执行的限制测试,覆盖 fetch、文件和环境读取、子进程、imports,以及终止 while(true)。这些证据支持运行边界,却不能证明业务逻辑正确:字段理解错误、日期口径偏差、漏掉分页,仍可能得到格式漂亮但内容有误的答案。
原文对 Cloud 配额也有缺口:它提到共享 runner 另有两项配额,却没有列出具体数值。能确定的是,每个 Cloud trial 提供 Team 级 code-mode 功能,包含 inline 和最多 20 个保存代码工具;自托管不按运行次数计量。不能据此推断 Cloud 的完整容量。
能拿来做什么
- 从团队每周重复、需要超过五次工具调用的只读问题开始试做,例如跨 CRM、ERP 核对记录,先确定最终答案需要哪些字段。
- 在 Cursor 等客户端接入前,先用 Test 核对样本结果,同时记录字符数、实际耗时和失败情况,分别判断上下文与性能收益。
- 对经常复用的程序保存为 Code Tool,收紧 Uses (connectors) 和
tools名单,并检查分页、循环终止条件及返回体大小。 - 如果你维护 Node 服务或 MCP 连接器,把 code mode 与聚合接口一起比较;查询已成为固定业务能力时,应评估是否下沉到后端实现。