智能体调用次数不能直接数日志行
文章区分运行、逻辑操作、执行尝试、事件投递及幂等键,解释多事件、重复遥测和重试如何干扰调用计数。示例基于 AgentInspect 的合成读取操作,讨论的是执行证据解释,而非重试实现。
AI 深度解读
同一个工具名在日志里出现六次,Agent 就执行了六次吗?未必。它可能只调用了三次,每次留下开始和结束记录,也可能混入了重复投递。作者用 AgentInspect 6.31.35 的合成读取实验说明:要统计尝试次数,先得给逻辑操作、执行尝试和事件建立清楚的身份关系。
这对排查 AI 编程工具的重试尤其有用。日志行数很好数,但它回答不了操作重试了几次,更不能直接证明外部系统产生了几次实际效果。
一次操作、一次尝试和一条记录有什么区别
作者维护 AgentInspect,文章讨论的是如何解释执行证据,不是实现在线重试,也不承诺外部效果恰好发生一次。
这里至少有三层关系:一个逻辑操作可以包含多次尝试,一次尝试可以产生多条生命周期事件,一条事件还可能被传输系统重复投递。工具名称只说明调用了哪类能力,不能单独承担这些身份。
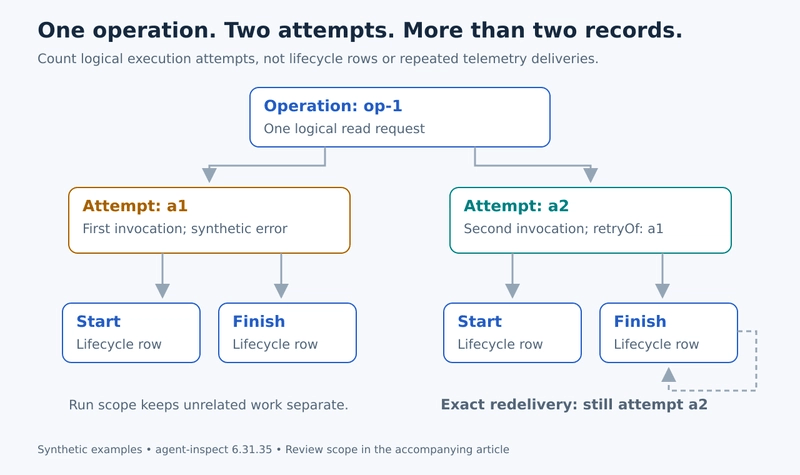
例如,查询一次策略是一个逻辑操作;第一次失败、第二次成功,是两次尝试;每次留下开始和结束记录,又会增加日志行数。若其中一条结束记录被重复发送,增加的是记录数量。
统计尝试次数,必须先定义什么算同一次操作。
作者采用 operationId 标识逻辑操作,用 attemptId 区分尝试,用 attemptNumber 记录序号,再用 retryOf 表达重试关系。业务边界应该在调用发生的位置记录,不能指望事后转换日志的适配器凭工具名补出来。
怎样让规则真正检查重试次数
作者固定安装版本,命令是 npm install --save-exact agent-inspect@6.31.35。这个版本需要用能携带元数据的 step() API;step.tool() 快捷方法只接收名称和函数,不接受第三个元数据参数。
下面的夹具把同一读取操作的两次尝试关联起来,第一次故意失败,第二次返回成功:
import { inspectRun, step } from "agent-inspect";

function attempt(attemptId, attemptNumber, fn, retryOf) {
  return step("lookup_policy", fn, {
    type: "tool",
    metadata: {
      toolName: "lookup_policy",
      operationId: "fixture-op-1",
      attemptId,
      attemptNumber,
      ...(retryOf ? { retryOf } : {}),
    },
  });
}

await inspectRun("two-read-attempts", async () => {
  await attempt("a1", 1, async () => {
    throw new Error("Synthetic temporary failure");
  }).catch(() => {});

  return attempt("a2", 2, async () => ({ found: true }), "a1");
}, { traceDir: ".agent-inspect", silent: true });
要留意 .catch(() => {}):吞掉错误是为了让测试继续执行第二次尝试,不是通用错误处理建议。静态的 fixture-op-1 也只适合这个隔离夹具,实际应用需要按业务范围设计唯一性。
通过 openTraceFile 打开生成的追踪文件后,作者分别检查最多允许一次和两次尝试的契约:
import {
  defineTraceContract,
  evaluateTraceContractRead,
} from "agent-inspect/checks";

const oneAttempt = defineTraceContract({ retry: { maxAttempts: 1 } });
const twoAttempts = defineTraceContract({ retry: { maxAttempts: 2 } });

const strict = evaluateTraceContractRead(trace, oneAttempt);
const bounded = evaluateTraceContractRead(trace, twoAttempts);
关键是两处 maxAttempts。原始夹具在上限为 1 时触发 contract.retry.max-attempts,上限为 2 时通过;判断对象是该逻辑操作关联的尝试,不是 JSONL 总行数。
当前实现会在同一个 run 内归组显式重试身份,优先使用不同的尝试 ID,也支持经过校验的尝试编号等证据。缺少身份或身份冲突时,不能因为名称重复就认定发生了重试。
去重、效果验证和格式转换要分别检查
作者还设计了一个负对照:复制第二次尝试完全相同的终态记录,追加到原始追踪里,再检查同样的契约。它要验证的是,重复投递一条记录不应该凭空增加一次尝试。
但「完全相同」这个前提不能省。如果相同身份对应的参数、状态或归属不同,那是需要调查的冲突。直接使用 new Map(events.map(e => [e.id, e])),可能只保留最后到达的记录,把矛盾证据覆盖掉。测试应分别覆盖精确重复和身份冲突,并设置不同预期。
尝试次数也不能升级成效果次数。两次尝试不证明发生了两次写入,一次超时不证明没有写入,收到成功响应也未必证明接收方观察到了效果。
元数据里存在 idempotencyKey,只能证明记录过这个键。要证明目标系统确实按键去重,还得检查目标系统的行为和范围匹配的回执。因此,重试计数、效果验证和授权应该分开检查。
导出格式也会引入另一层问题:span 树结构合法、工具名完整,不代表操作身份还在。作者的 OTLP 实验在单独评估 run 状态时保留了该夹具的重试判定,但也暴露了恢复后的 run 状态差异,详情放在配套文章中。一次检查通过,不能证明转换前后语义完全一致。
我的判断
我认同作者把身份建模放在规则之前。它直接指出了日志排查里一个常见误区:记录的是事件,却拿事件数量回答业务执行次数。
证据的边界也要看清。文章给出的是 AgentInspect 6.31.35 上的合成读取夹具,没有生产规模、误判率或不同追踪方案的对照数据。那个小夹具适合验证计数规则,不能替支付、通知或预订系统证明重试安全。
按工具名计数适合粗略观察调用分布;若要判断某次业务操作是否超出尝试上限,就需要显式身份。作者关于小夹具更有信息量的建议有道理,但仍是工程经验,原文没有提供比较数据。
能拿来做什么
- 在 Node 或 Agent 工具调用入口,为逻辑操作和每次尝试分别记录身份,并明确它们在什么范围内唯一,避免把同名调用归成一次业务操作。
- 为追踪检查准备一个小夹具:同一操作先失败再成功,然后追加一条完全相同的终态记录;另设身份冲突样例,检查系统是否保留矛盾证据。
- 如果追踪需要导出到 OTLP,在重新读入后再次验证尝试上限,并单独检查 run 状态,避免只验证格式能被解析。
- 对带写入效果的工具,把尝试计数和目标系统回执分开验证;不要仅凭日志中的
idempotencyKey判断去重已经生效。