自动化攻击智能体的工具链与暴露面
文章盘点约 45 个攻击自动化框架,将其中 32 个归为五类,并检查秘密扫描器集成与控制台暴露情况。作者报告部分框架具备扫描能力,且多个默认提供网页界面的项目存在公网服务。
AI 深度解读
AI 渗透工具的风险,已经不能只靠仓库里有没有攻击脚本来判断。作者盘点了约 45 个开源框架:真正把秘密扫描器接给 Agent 的只有 4 个,但几乎每个框架都给了模型 Shell 和网络权限,缺失的流程可能在运行时被补齐。
这篇更有价值的地方,是把「仓库内置能力」「真实攻击记录」和「公网暴露情况」分开调查。对使用 AI 编程工具、维护公开仓库的开发者来说,它提醒我们:既要查代码里泄露了什么,也要查 Agent 实际能做什么。
没写进仓库的能力,为什么仍然构成风险
这些框架的共同结构并不复杂:把语言模型放进一个循环,让它调用工具、读取结果,再决定下一步。与让 AI 生成一条命令相比,关键区别在于后续行动也交给了模型。
作者将其中 32 个归入五类,其余约 13 个属于分叉或变体:
- 网络攻击链工具覆盖侦察、利用和入侵后的操作,常从 Kali 容器启动。PentAGI 调度 Nmap、Metasploit、sqlmap,RedAmon 构建攻击面图谱;DarkMoon 则提供 50 个专门 Agent,覆盖 Web、云、Active Directory 和 CI/CD。
- Web 应用与 API 工具更聚焦应用测试。Strix 自主测试 Web 应用,Shannon 从源码入手,更接近静态应用安全测试(SAST)审查者,PentestGPT 则偏向提供建议。
- 命令与控制(C2)集成工具把模型接入控制系统。Sage、echidna 在 Mythic 内充当操作员,virga 把本地模型放进植入程序;Pojun、FORANG 等来自 ARTEX 分叉。
- Harness 类工具为通用编程 Agent 配上攻击技能。RAPTOR、CyberStrike、cyber-harness、Nebula、Cybermes 属于这一方向,涉及 Claude Code、Codex、Hermes。
- 研究原型来自学术工作,包括 Incalmo、hackingBuddyGPT、VulnBot、HackSynth、AutoPT 和 Ares。
这里的 Harness,可以理解为给现有 Agent 配置工具、技能和执行规则的外层环境。它不必重新训练模型,也可能改变模型能够完成的任务。
ARTEX 的传播说明,删除上游仓库未必能收回能力。作者称,它在首次提交 74 天后,于 2026-10-08 被创建者下架;仅下架当周,就出现了 102 个分叉及带 ARTEX 名称的仓库。
另一个证据来自作者引用的 Unit 42 报告:攻击者在 2026 年 8 至 9 月,使用定制 Cairn 分叉执行了 25 次行动,涉及至少 19 家组织,其中 10 家出现访问权限或数据被获取的情况。一次行动包含凭据与秘密收集,但作者在公开 Cairn 仓库中没有找到对应能力。
公开仓库的功能清单,只能说明默认交付了什么,不能完整代表运行时能做什么。
不过,这个案例涉及定制分叉,不能直接证明公开版本也能达到相同效果。
只有 4 个接好了扫描器,为什么作者仍然担心
作者挑选了最可能具备秘密搜寻能力的工具,包括 ARTEX 分叉、基于 Kali 容器的网络 Agent,以及带开源情报(OSINT)技能的 Harness,并固定到具体提交进行代码审查。
24 个已审查工具的结果如下。
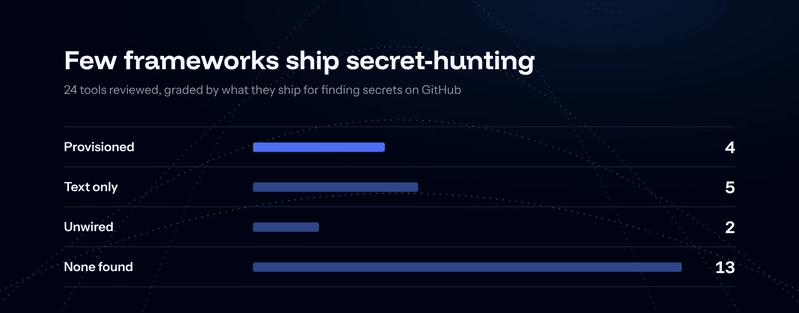
这个分级比简单标注「支持」或「不支持」更有用。Provisioned 表示扫描器已被明确配置,Agent 默认能获得相关 GitHub 指导并调用扫描器;Text only 只有操作说明或技能文本;Unwired 虽有相关代码,却没有接到 Agent 的调用路径上;None found 表示审查后未发现能力。
另外还有 Not reviewed,表示不在审查范围内。它不能被理解成「没有风险」。
真正接好了扫描器的只有 Pojun、Cybermes、Xalgorix 和 AIRecon,而且四者都没有内置 GitHub 内容获取器。也就是说,发现仓库、获取内容、扫描秘密、处理结果,这条完整流水线并没有随项目一起交付。
作者担心的是另一层:几乎所有框架都给 Agent 提供 Shell 和网络访问。模型可能自行补上内容获取、安装工具和串联结果的步骤。
这个判断有合理的机制解释,但证据边界也要划清:代码审查证明了默认配置,不能证明临时拼装流程的成功率。原文没有给出统一模型、提示词、目标和权限条件下的对照测试。「一次提示就能完成」应当看作风险描述,而不是稳定性承诺。
Shodan 的 1,428 条结果,究竟能说明什么
作者还从代码判断这些框架是否暴露网络服务,再用 Shodan 指纹查找公网实例。
41 个接受指纹评估的框架中,11 个默认提供 Web UI,18 个只在部分配置下提供 UI,或根页面没有鲜明特征,12 个完全没有监听服务。不同构建版本可能拥有不同界面,因此最终编写了 56 条指纹记录。
识别依据包括页面标题、favicon 哈希、页面 HTML 和 TLS 证书。它们适合帮助防守方识别资产,但并不等于漏洞验证。
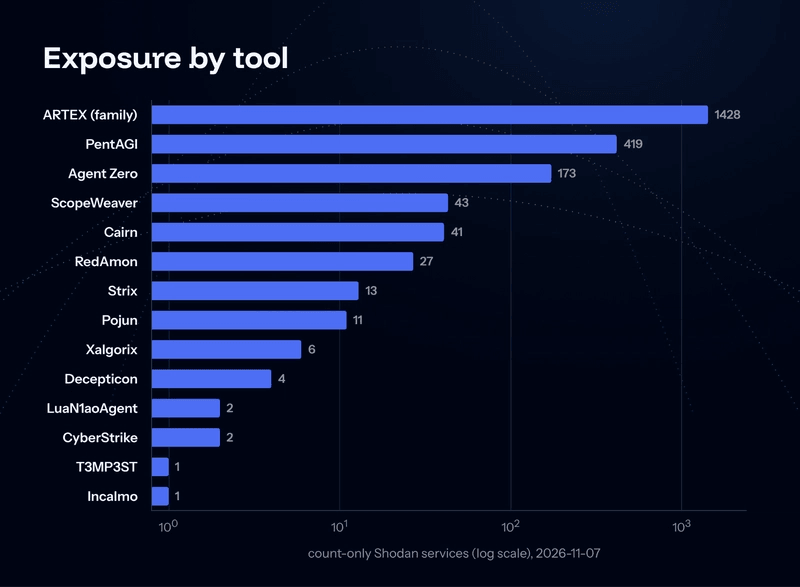
2026-11-07 的结果中,ARTEX 家族匹配到 1,428 条服务记录,PentAGI 为 419 条,Agent Zero 为 173 条。ScopeWeaver、Cairn、RedAmon 分别为 43、41、27 条,其余工具见图。
这些数字的单位是服务记录,不能直接换算成独立组织、攻击者数量或已失陷系统。原文也没有交代去重、误报验证和持续在线情况。没有监听端口的框架,更无法靠这种方法覆盖。
认证情况则提供了更直接的风险线索:173 条 Agent Zero 服务中,134 条停留在登录界面,39 条处于开放状态。存在登录页也不代表认证一定可靠。作者还指出,Cairn、提供超过 150 个攻击工具的 MCP server HexStrike,以及通用 Agent 框架 Agent Zero,默认均不启用认证。
原文提到会发布指纹描述,但给定材料没有包含具体查询表,因此这里无法复述实际 Shodan 查询语句。GitHub Stars 和最近推送时间同样取自 2026-11-07 的 GitHub API,属于当日快照。
我的判断
我赞同作者把关注点从「最受欢迎的仓库」转向「被广泛分叉的基础项目」。上游下架后,分叉仍能保留代码和默认配置;只按 Stars 排查,很容易漏掉实际部署的变体。
但「风险集中在少数基础项目」仍是基于本次样本的判断。原文没有给出足够数据,证明 Stars、分叉数、暴露数量与真实攻击成功率之间的关系。
比工具叫什么更值得审查的,是模型拿到了哪些权限,以及这些权限能否连续使用。
这也补充了传统秘密扫描的局限:扫描器检查凭据有没有泄露,Agent 权限控制则限制它发现凭据后还能做什么。两者解决的问题不同,不能互相替代。
还要保留一层审慎:文章结尾推广了 GitHub Security Audit,内容带有产品导向。这不否定前面的代码审查,但营销式表述不能替代实验数据。尤其是把自主攻击描述得仿佛能够持续绕过防御,超出了材料能够支持的范围。
能拿来做什么
- 检查公开前端和 Node 仓库里的配置、脚本与历史提交,确认有没有服务端密钥或其他有效凭据。发现有效秘密后,应撤销或轮换,不能只删除当前文件。
- 给 Claude Code、Codex 等工具安装技能包或 MCP server 时,同时检查它获得的 Shell、网络和凭据权限。能力审查要覆盖实际执行环境,不能只读技能说明。
- 自建 Agent 控制台时,核实公网可达性和认证配置。尤其要检查容器端口映射、反向代理与默认启动参数,确认服务是否被意外暴露。
- 评估 AI 安全工具时,分别记录代码已接通、只有文字指导、尚未审查等状态,再用授权环境中的任务验证效果,避免把演示结果当成稳定能力。