长任务智能体如何保存进度与审批结果
文章建议为长时间运行的 AI 任务设置持久化标识、输入版本、已批准产物和明确状态,避免仅靠对话记忆追踪进度。示例从基于已确认事实生成产品页草稿入手,让产物与检查清单能够被人工审阅。
AI 深度解读
AI 接手一个长任务,跑得更久、回答更完整,并不代表应用就知道哪些结果可以继续使用。原文的核心主张是:长时间运行的 AI 工作需要可检查、可恢复的检查点,模型的一句「完成了」不能直接成为业务状态。
作者用一个商品页审核清单演示这套思路:缩小任务、区分提议与完成、保存证据,再决定失败后从哪里继续。对正在给前端或全栈产品接入 AI 的团队,这比继续往提示词里补要求更有工程价值。
先把大任务拆成能审核的一份产物
「准备产品发布」同时包含调研、写作、素材制作和发布。Agent 中途停止时,一段自信的回复无法告诉应用:哪些步骤完成了,哪些还没开始。
作者把第一个实验缩小为:根据已批准的事实,为一个虚构陶瓷杯准备商品页草稿。允许使用的事实只有容量 300 mL、象牙白、只能手洗。第一轮只交付拟议草稿和审核清单,由人检查,不执行发布。
这里有两个关键约束。一是完成标准要足够具体,审核者能判断容量有没有写错、护理要求有没有遗漏、有没有凭空加入卖点。二是任务必须有持久化标识,并把原始需求、输入修订版本和最新批准产物关联起来。
对话可以结束,任务状态必须留在应用里。
原文还提到 Google 于 October 28 宣布 Gemini 4 Carbon,以长任务和网络防御为重点,并分阶段启动初始推出。不过,这只是文章的切入点:示例没有证明 Carbon 能通过 RelayRouter 使用,也不是 Carbon 的接入教程。
JSON 格式正确,离审核通过还有多远
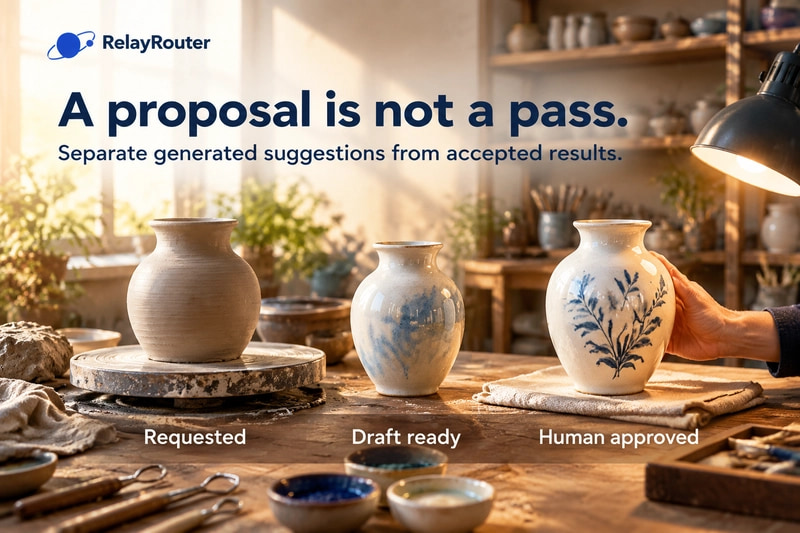
作者建议使用 requested、draft_ready、review_needed、approved 等独立状态,并明确哪些事件有权推动状态变化。
模型可以提出「草稿已准备好」,但应用检查或审核者要判断这次转换是否成立。尤其要区分两件事:模型生成了一份检查清单,以及这些检查真的执行过。
示例的响应约定只有 task 和 checks 两个字段,后者必须包含三条短字符串。本地校验器检查字段名、文本类型、三项列表和字段长度,但人仍然需要判断清单是否有用。
下面的请求载荷解决的是「生成待审核清单」,原样保留:
payload = {
    "model": model,
    "stream": False,
    "messages": [
        {
            "role": "system",
            "content": "Propose a review checklist. Return only JSON with exactly task (a short string) and checks (exactly three short strings). These are proposed checks, not completed work. Do not claim to have executed tests or changed files."
        },
        {
            "role": "user",
            "content": "Synthetic brief: draft a product page for an unbranded ceramic cup. Approved facts: 300 mL, ivory, hand-wash only. Suggest checks for factual fidelity, instructions, and review readiness."
        }
    ]
}
要看的是 system 中限定的工作边界:这些只是拟议检查,不能声称执行过测试或修改过文件。stream: False 则对应这个示例的一次非流式请求。
原文展示的预期 JSON 形状也只是说明,并非记录下来的模型响应。因此,它证明的是接口约定如何设计,没有展示模型在真实请求中的遵循率。
检查点要记录证据,还要决定如何重试
接入时,作者要求从当前 RelayRouter 控制台复制可用文本路由的 Base URL 和模型标识,不要根据新闻标题猜模型 ID,密钥保留在服务端。
下面这些命令用于配置并运行原文提供的 Python 示例:
export RELAYROUTER_BASE_URL='COPY_HTTPS_BASE_URL_FROM_CONSOLE'
export RELAYROUTER_API_KEY='YOUR_SERVER_SIDE_KEY'
export RELAYROUTER_MODEL='AVAILABLE_TEXT_MODEL_ID'
python request_checklist.py
需要核对的是 RELAYROUTER_MODEL 对应的路由是否支持示例请求形状。脚本使用 Python 标准库,在 Base URL 后追加 /chat/completions,发送请求、检查是否正常完成,再解析结果。世界模拟或供应商托管 Agent 属于不同产品接口,不能直接套用。
响应成功后,应用应保存任务标识、输入修订版本、请求的模型、可用响应元数据,以及等待审核的产物。审核被拒绝时,还要保留拒绝原因和当时审核的版本。
代码任务可以记录补丁、实际执行的测试命令及输出;内容任务可以记录已批准事实和修正内容。状态要单独存储,不能埋在生成文本里。日志则只保留足以解释失败的信息,避免混入凭证或不受限制的客户原文,并按实际数据制定留存规则。
恢复逻辑也必须提前设计。请求超时,只说明客户端停止等待,并不能证明上游计算已经结束。应用应读取最后一个确认的检查点,再判断能否重试纯生成步骤。
如果涉及发送消息、更新发票,就需要核对动作是否已经发生,并防止重复执行。换更大的模型并不会自动解决这些问题。
我的判断
我认同作者把「完成的定义」交给应用。对于需要人工审核、可能中断、会产生外部动作的 AI 流程,这条边界很实用。结构化输出控制格式,检查点保存进度,真实证据支持判断,三者各管一件事。
但这篇文章更接近设计起步指南。示例只生成清单,不执行工具、不修改仓库、不发布页面,也没有提供检查点方案与更大提示词之间的对照数据。它的收益主要来自工程推理,不能据此宣称任务成功率提高了多少。
实施成本也要看任务。一次性文本生成,保存输入和结果可能已经够用;多步流程才更需要明确状态转换与恢复规则。原文列出了状态名,却没有完整定义转换表,也没给出发送消息或更新发票的去重实现,这些仍要由业务系统补齐。
RelayRouter 在文中承担的是可用路由的 API 连接。完成标准、审核权限和失败恢复依然由应用负责,这套设计并不依赖某一个网关品牌。
能拿来做什么
- 给 Node 服务中的 AI 任务增加任务标识和输入版本,将产物与审核状态分别保存,让前端能明确显示当前等待谁处理。
- 在日常 AI 编程中,要求交付补丁、实际测试命令和测试输出;把模型写的「测试通过」当作待核实说明。
- 为超时流程先划定重试边界:纯生成步骤根据检查点判断是否重试,发送消息等动作先核对执行结果,再决定下一步。
- 从一个可用文本路由、一份待审核产物和一名审核者开始,先验证生成、拒绝、修订和恢复流程,再增加自动化步骤。