用.NET搭建带权限过滤的本地RAG
教程使用ASP.NET Core、Qdrant和Ollama构建C# RAG API,覆盖按页与标题切块、向量检索、权限过滤及带引用的流式回答。内容还包含效果测量,涉及从文档处理到回答评估的完整链路。
AI 深度解读
用自己的文档做问答,难点往往不在接上模型,而在回答能否找到出处、不同客户的数据会不会串、资料不足时能否停下来。这篇教程用 C#、ASP.NET Core、Qdrant 和 Ollama,把这些问题串成了一条 RAG 流水线。
作者的核心主张是:可靠性要落实到文档处理、检索权限和评测里。它值得程序员读,但不能当效果保证:评测只有 8 份虚构文档、59 道题,而且输入原文没有展示具体成绩。
引用准不准,从文档入库时就决定了
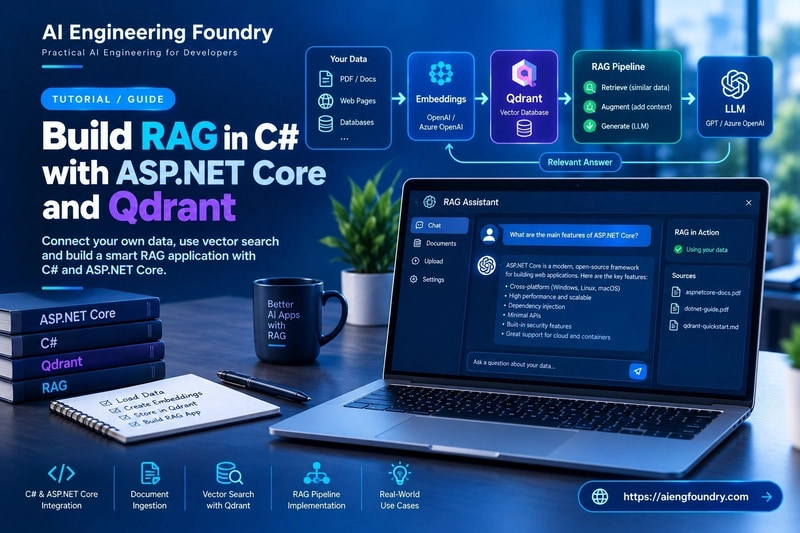
RAG(检索增强生成)先从文档中找相关片段,再让模型依据片段回答。作者将它拆成两条流程:后台负责提取、切块、生成向量和入库;每次提问负责检索、组织上下文和生成答案。
实现来自 SupportDesk AI,面向客服知识库。项目要求 .NET 10 SDK,流式接口使用 ASP.NET Core 10 新增的 TypedResults.ServerSentEvents。默认模型通过 ollama pull qwen2.5:7b && ollama pull nomic-embed-text 拉取,前者回答,后者生成 768 维向量。
作者先保留文档结构:PDF 用 PdfPig 按页提取,Word 用 Open XML SDK 按标题拆分,表格转成 cell | cell 行;Markdown 按标题拆分,但忽略代码围栏里的 #;纯文本作为一个 section。
PDF 还有两个实际问题。ContentOrderTextExtractor 尽量按阅读顺序处理双栏内容;页面非空白字符少于 ScannedPageMaxChars = 20 时尝试 OCR。安装 Tesseract 后,系统读取扫描图像,并跳过小于 200 × 200 像素的图片。这里的尺寸判断是项目启发式规则。
切块采用最多 1,200 个字符、重叠 150 个字符,优先保留完整段落,超长段落再按空白切开。硬约束是不跨 section,否则引用里的页码或标题就可能失真。
生成向量前,再拼上文档标题和章节标题,帮助模型理解「30 天内退货」属于哪份政策。正文仍单独存入 payload,方便展示和引用。Ollama 实现调用 /api/embed,每批处理 32 段文本;文档和问题必须使用相同模型及设置。
权限必须进入检索,不能等回答生成后再检查
Qdrant 的启动命令是 docker run -d --name qdrant -p 127.0.0.1:6333:6333 -p 127.0.0.1:6334:6334 -v qdrant-data:/qdrant/storage qdrant/qdrant:v1.18.3。6333 提供 REST 和控制台,6334 供 Qdrant.Client 使用 gRPC;仓库 compose 的宿主机端口则是 6335、6336。绑定本机地址,是因为未配置 API key 时 Qdrant 没有认证。
更关键的是索引设计。collection 名包含 provider、model 和 dimension,例如 supportdesk__ollama__nomic-embed-text__768,向量距离使用 Distance.Cosine。更换模型就进入新集合,避免把不同向量空间混在一起。
payload 同时保存引用信息与权限信息,包括文档、组织、可见性、正文、页码和章节;document_id、organization_id、visibility 建立 keyword 索引。重新处理文档时先删除旧片段,再写入新片段,避免旧政策继续被引用。SQL Server 保存 Pending、Processing、Completed、Failed 状态,后台逐份处理,重启后重新排队未完成任务。
权限应当决定哪些片段有资格参与检索。
下面这段代码将组织和可见性直接放进向量查询:
private static Filter AccessFilter(AccessScope access)
{
    var filter = new Filter();
    filter.Must.Add(Conditions.MatchKeyword("organization_id", access.OrganizationId.ToString()));
    filter.Must.Add(Conditions.Match("visibility", access.Visibilities.Select(VisibilityValue).ToList()));
    return filter;
}

// 权限属于每次查询的一部分,Qdrant 只考虑用户可见的片段。
var dense = await client.QueryAsync(
    collection,
    query: vector.ToArray(),
    filter: AccessFilter(access),
    scoreThreshold: (float)minScore,
    limit: (ulong)limit,
    payloadSelector: true,
    cancellationToken: cancellationToken);
要看的是 filter: AccessFilter(access)。如果先取 top 5 再过滤,前五条可能全是无权访问的内容,既漏掉合法答案,也增加泄漏机会。项目要求检索必须传入来自登录用户的 AccessScope,没有无权限参数的重载。
作者还做过反向验证:故意移除过滤条件,组织 B 的片段进入组织 A 的结果,集成测试随即失败。新文档默认 Internal;改为 Public 等可见性变化只更新 payload,不必重新生成向量。底层使用较新的 QueryAsync,应与业务封装层的 vectors.SearchAsync 区分。
相似度够高,也不代表资料能回答问题
默认检索取 top 5,余弦相似度门槛是 MinScore = 0.3。没有结果时,系统直接返回固定文本,不调用聊天模型:
var matches = await RetrieveAsync(question, access, request, cancellationToken);
if (matches.Count == 0)
{
    return new RagAnswer(
        RagPrompt.NotFoundAnswer, Grounded: false, [], Metrics: Finish(request, Outcomes.NoContext), SearchQuery: searchQuery);
}

var response = await chat.CompleteAsync(
    RagPrompt.Build(question, matches, options.Value.MaxContextChars), cancellationToken);
关键是 matches.Count == 0 分支提前返回。固定回答为 I couldn't find information about that in the knowledge base.,此时只花费问题向量化的调用成本。
但门槛只能过滤明显无关内容。作者评测中,不可回答问题的最高匹配分数达到 0.44 至 0.61,最弱的可回答问题只有 0.54。提高门槛无法干净地分开两者。项目笔记还给出相关文本的大致区间:nomic-embed-text 为 0.6 至 0.8,OpenAI 的 text-embedding-3-small 为 0.4 至 0.6,换模型后需要重测。
第二道拒答交给提示词:片段编号为 [1] 至 [5],要求引用、禁止外部知识,并声明文档里的指令属于不可信数据。
作者也发现了过度拒答。两道题的正确片段都排在第一,但政策写「30 天」,用户问「六周」或「两个月」,模型仍不敢回答。增加「将规则应用到客户具体情况」后,该模式得到修正;作者称没有增加幻觉,但证据仍限于这套小评测。
上下文以 MaxContextChars = 12,000 限制字符数,首个片段始终保留。字符预算不等于 token 预算,还要检查 Ollama 的上下文窗口,避免提示词被静默截断。
前端拿到的是 SSE(服务器发送事件):依次发送 conversation、可选的改写后 query、sources、多次 delta,最后 done 或 error。来源包含分数和 300 字符摘录,先发来源便于边生成边显示引用。接口 /chat/stream 使用带 bearer token 的 POST,问题最长 2,000 字符;浏览器原生 EventSource 不支持这种调用方式。输入原文在介绍 React 通过 fetch 读取流时截断,没有提供后续完整实现。
我的判断
这套方案最有价值的是把可靠性变成可检查的工程约束:保留出处、隔离向量空间、查询内鉴权、空结果直接拒答。相比只接一个通用 RAG SDK,这些边界更值得理解。作者用 typed HttpClient 和 IEmbeddingService、IChatService 解耦,也允许底层替换成 Microsoft.Extensions.AI 或 Semantic Kernel。
但它没有证明这套配置优于其他方案。评测使用单张 8 GB GPU、qwen2.5:7b 和 nomic-embed-text,运行日期为 2026-10-05;语料小而干净,拒答与权限题更少,输入里也没有具体指标表或完整评测步骤。1,200/150 的切块、top 5、0.3 门槛应视为起点。
还有两处边界:提示词声明「不要执行文档指令」不能单独证明防住了提示注入;先删旧片段再写入新片段会如何处理失败和检索空窗,原文没有说清。权限测试能证明特定过滤条件被覆盖,不能据此推断整个系统安全。
能拿来做什么
- 做知识库前先检查提取结果,确认扫描页有正文、页码和标题能随片段保留,再讨论更换回答模型。
- 做多租户检索接口时,将服务端用户身份生成的权限范围设为必填参数,并测试跨组织内容是否会进入结果。
- 做 React 问答界面时,按
sources、delta、done、error分别处理来源、增量文本和结束状态;后端将取消信号传到模型调用,用户关闭页面后停止生成。 - 用自己的问题集调整参数,分别统计
answered、no_context、declined、failed、cancelled,同时检查检索正确却拒答的情况,不只盯着相似度分数。