从本地会话追踪 Claude Code 用量去向
作者分析一周内 471 个会话、21449 次 API 调用和约 61.5 亿 token,指出仅看缓存命中率不足以理解用量结构。文章按 API 公开价格估算消耗,明确无法据此解释订阅额度为何加速耗尽。
AI 深度解读
Claude Code 的缓存命中率到了 97%,为什么用量还是消耗得很快?作者翻查了一周的本地记录:471 个会话、21,449 次 API 调用、61.5 亿 token。他发现,缓存确实在工作,但少量昂贵的缓存写入,被庞大的缓存读取量掩盖了。
这份分析最有用的地方,是把长会话、子代理和暂停后的恢复拆成了可核对的账目。它能帮助重度用户找到使用习惯里的开销,却不能解释订阅额度为什么突然掉得快。API 标价和套餐计量,是两套需要分开看的东西。
为什么 97% 的缓存命中率仍然不够看
作者在 2026 年 10 月 23 日,用官方 session-report 插件分析了最近七天的记录。Claude Code 会把请求用量写进 ~/.claude/projects,其中也包括子代理的记录。
安装和运行只需要两条命令:
/plugin install session-report@claude-plugins-official
/session-report
注意第一行的 @claude-plugins-official,这是原文给出的官方插件市场来源。插件输出可排序、可展开的 HTML 报告,底层运行的是 analyze-sessions.mjs --json --since 7d。
统计也有坑:流式响应可能拆成多条记录,共用一个 request ID;恢复会话还可能把旧历史重放到新文件。自己写统计脚本时,必须按 request ID 去重,不能把每一行都当成新请求。
作者算出的 token 分布,看起来非常健康:
| 类型 | token 占比 | 按 API 标价折算的费用占比 |
|---|---|---|
| 缓存读取 | 96.9% | 约 46% |
| 缓存写入 | 2.8% | 约 38% |
| 模型输出 | 0.4% | 约 16% |
这些比例经过四舍五入。真正需要盯住的,是只占少量 token、却吃掉大量费用的写入。
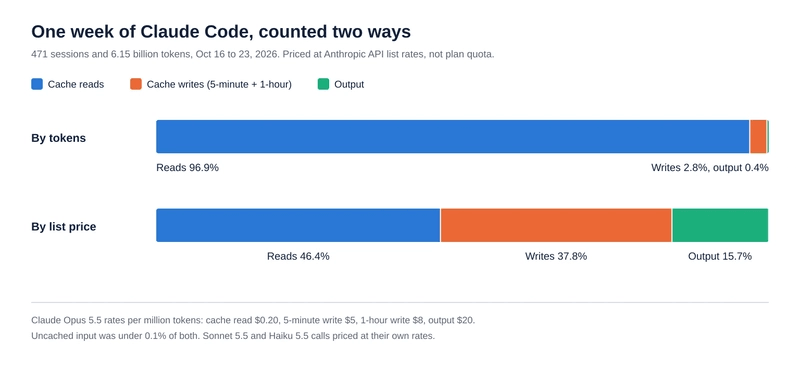
按原文列出的 2026 年 10 月 23 日 Claude Opus 5.5 价格,每百万 token 的普通输入、输出、缓存读取分别为 4、20、0.20 美元。5 分钟缓存写入按普通输入的 1.25 倍计价,1 小时写入按 2 倍计价。
因此,同样是 50 万 token,上下文命中缓存时读取一次约 0.10 美元,过期后重新写入则约 4 美元。一次重写,抵得上四十次读取。
缓存读得多,不等于缓存写得便宜。
作者另外写了 weigh.py,用 python3 weigh.py 7 给最近七天的请求按模型和 token 类型加权,结果约为 2,500 美元。请求数和 token 总量与插件的差异在 0.1% 以内。这是 API 标价折算值,不是作者的订阅账单。
真正昂贵的是上下文过期后再写一遍
插件把单次写入超过 100,000 个、未能从缓存读取的 token 标为一次大额缓存中断。作者一周遇到 223 次,占全部缓存写入 token 的 42%,折算约 446 美元,占整周费用的 18%。
223 次里,209 次发生在闲置导致缓存过期之后,占 94%。系统提示词、工具列表或模型变化导致的前缀变化,只对应 13 次。
这个结果很具体:在作者的使用方式里,主要问题不是频繁改提示词,而是带着大段历史回来时,缓存已经失效。
缓存有有效期,也就是 TTL,每次读取都会刷新它。作者在 Claude Code 2.1.301 到 2.1.305 的日志中观察到:
- 主会话的缓存写入有 98% 使用 1 小时有效期。
- 子代理的缓存写入有 100% 使用 5 分钟有效期。
这是日志观察,不是官方保证。要迁移这条经验,应先检查自己记录中的 cache_creation 字段。
主会话里有 72 次中断发生在闲置超过一小时之后,折算约 307 美元,占整周的 12%。其中 57 次是作者回来继续旧会话,间隔中位数为 11 小时,重写量中位数为 489,000 token。另外 15 次中,9 次来自超过一小时的前台命令,6 次来自唤醒闲置会话的后台任务通知。
所以,输入一句「继续」并不代表只发送这两个字。模型还要重新拿到此前的上下文。
作者建议离开前写交接摘要、下次开新会话,或者趁缓存还有效时压缩上下文。后者没有做实测,只是根据读写价差提出的推断,不能当成已经验证的节省方案。
子代理为什么比 token 占比看起来更贵
作者一周运行了 688 次子代理,占全部 token 的 32%,却占缓存写入的 64%。
子代理启动时并非完全没有缓存。78% 的首次调用读到了超过 10,000 个缓存 token;首次读取量中位数为 17,900,新增写入量中位数仍有 55,000。原因不复杂:共享提示可以复用,新任务的说明和上下文仍要写进去。
688 次运行的首次写入合计 3,900 万 token,占整周缓存写入的 23%。
更容易被忽略的是,子代理结束后再补一句要求。作者发现,Claude Code 会带着这个子代理原来的上下文继续执行。如果补充消息来得太晚,5 分钟缓存已经过期,就要重新写入。
他遇到了 92 次这样的恢复,中位间隔只有 9.3 分钟,重写量中位数却达到 178,000 token,是新建子代理首次写入中位数的三倍多,折算约 76 美元。
另有 42 次中断来自子代理等待自己的构建、测试或休眠命令超过五分钟,折算约 44 美元。作者因此把长等待放到主会话执行,因为他的日志里主会话缓存能保留一小时。
这里比较的是上下文写入量。新代理是否需要重新调查、会不会遗漏旧代理掌握的信息,原文没有给出完整对照。
我的判断
我认同作者把「缓存命中率」换成「各类 token 的费用占比」。前者适合描述复用程度,后者更接近解释 API 开销。请求去重、区分缓存有效期、保留未知模型提示,也让这份测量比直接累加日志可靠。
但它仍然是一位重度用户的一周样本。长会话和大量并行子代理,使缓存过期在他的记录中尤其突出。短任务为主的团队,未必会得到相同排序。
价格口径也有条件。原文脚本为 claude-opus-5-5、claude-sonnet-5-5、claude-haiku-5-5、claude-fable-5-1、claude-opus-5 配置了价格。其中 Sonnet 5.5 的输入、输出、读取单价为每百万 token 2、10、0.10 美元;Haiku 5.5 为 0.10、0.50、0.01 美元,提示超过 100,000 token 后改为 0.50、2.50、0.05 美元。Fable 5.1 对应 10、50、0.25 美元,Opus 5 对应 5、25、0.50 美元。
按原文口径,Opus 5.5 和 Sonnet 5.5 的完整 1M 上下文按标准费率计价;fast mode 会让全部费率翻倍,US-only routing 额外增加 10%。作者这一周均为标准速度、全球路由。复用脚本时,价格表和这些条件都需要重新核对。
至于 10 月 21 日 X 上「用量消耗快了 5 倍」的反馈,原文称 Boris Cherny 先回应没有改动,随后表示团队在调查。截至原文写作的 10 月 23 日,没有公布原因。
这份分析能解释作者的 token 去向,不能证明套餐额度变化的原因。
即使两周的 token 构成没有明显变化,也只能缩小排查范围,不能直接证明平台修改了计量。Anthropic 没有公布套餐如何权衡缓存读取、写入和输出,这是证据的边界。
能拿来做什么
-
给 Claude Code 做一次按周统计,同时查看
/usage的套餐用量。把最近一周与体感正常的一周对比,优先检查缓存写入占比、大额中断次数和子代理数量;如果任务规模也变了,要一起记录,避免误判。 -
前端重构或全栈排障暂停过夜前,留下短交接:目标、改动文件、已验证结果、未解决问题和下一步。次日据此开新会话,再判断是否需要找回旧上下文;压缩会话可以尝试,但应单独验证收益。
-
子代理完成后尽快审阅结果,需要补充时及时发送。超过五分钟后,应比较继续旧代理与新建代理的上下文规模、调查成本,不要只凭「复用更省」或「重开更省」做决定。
-
Node 构建、测试等长任务若经常超过五分钟,可以先观察它们是否触发子代理缓存重写,再决定是否放到主会话。作者的日志支持这个调整方向,但你使用的 Claude Code 版本和缓存字段才是实际依据。