智能体记忆实验:保存规则可能削弱收益
据文中转述,Anthropic 在数据库问答实验中为 Claude 提供跨会话笔记目录,使得分从 0.383 升至 0.700;限制只记录失败则损失了较多收益。该内容属于记忆机制研究,结果来自特定任务,并非新模型发布。
AI 深度解读
给 AI 编程助手一份跨会话笔记,成绩可能明显提高;再补一句「只记录失败」,收益却可能缩水。Anthropic 这组研究讨论的,是长期运行的 Agent 该怎样保存、读取和修正记忆。
它的结论并非「记得越多越好」:强模型可能更适合自行判断哪些信息值得留下,而每次会话都会加载的内容必须精简。对使用 Claude Code、维护 MEMORY.md 的程序员,更有价值的问题是:记忆有没有被读取,错误有没有被纠正,以及节省的检索成本能否覆盖维护成本。
记忆有效,前提是模型真的会读
据原文转述,Anthropic 在 2026 年 11 月 6 日发布了研究文章 The components of agent memory。它没有发布新模型或新 API 功能,而是分析 Agent 记忆的组成,并提供 dreaming cookbook 和 knowledge-wiki quickstart 两份配方。
主要实验采用 CL-Bench 1.0 的数据库任务:Claude 查询数据库,连续回答问题。每个问题都从新会话开始,唯一能跨会话保留的是记忆目录。因此,这个设计主要检验的是持久化记忆,而非同一段聊天越积越长的效果。
Claude Opus 4.7 的平均奖励从无状态基线的 0.383 提升到 0.700。但原文没有完整展示各模型的成绩表,也没有交代重复次数和波动范围,不能把这一组提升直接当成所有任务的预期收益。
Sonnet 4.6 则暴露了另一类问题:它经常不读记忆文件,也不验证自己的推测。明确要求它先读笔记、再检验推测后,成绩接近翻倍,达到 0.641。
记忆写进文件,只完成了保存,还没有完成使用。
所以,模型看起来「没有长期记忆」,未必是存储方案失效,也可能是读取环节没发生。Claude Code 中的「Recalled 2 memories」可以作为读取线索,/memory 则能打开自动记忆目录。不过,读取提示也不能证明模型正确采用了笔记。
为什么每次加载的内容必须少
Anthropic 把记忆分成四层:会话记录保存可搜索的事件日志;记忆笔记提炼重要观察;wiki 等表示层组织知识;注入上下文则在每次会话开始时直接加载。
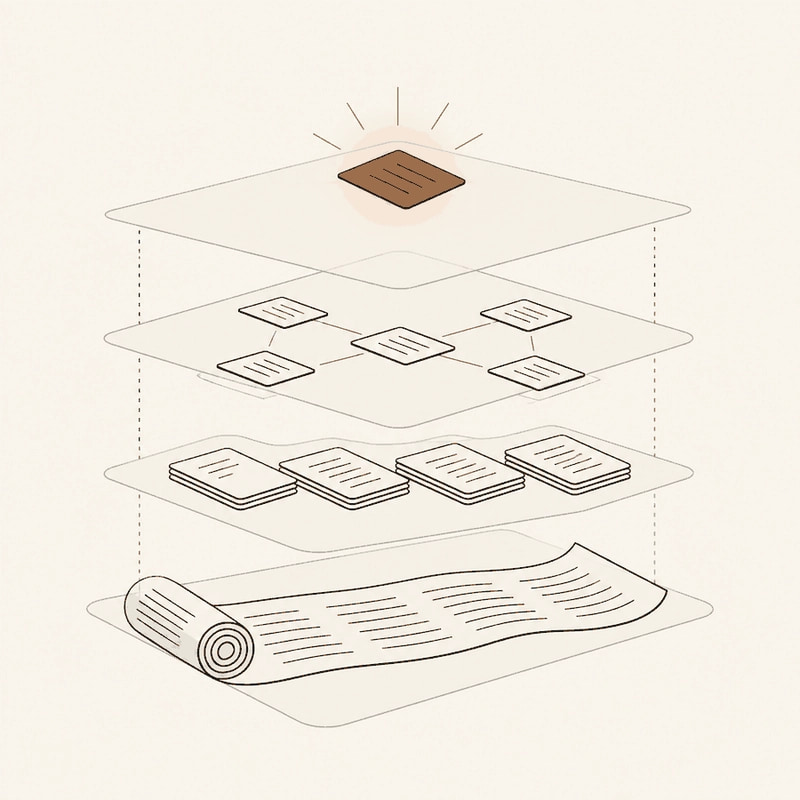
可以把它理解为:原始记录留作查证,笔记方便复用,wiki 负责组织,而开场上下文只放最必要的信息。底层资料可以很多,不代表每次都要全部塞给模型。
注入层的成本尤其直接。它持续占用 token;一条错误笔记如果总被加载,就可能反复影响判断。而且,加载了也不保证模型会执行。
原文引用的 Claude Code 文档给出了具体边界:自动记忆位于 ~/.claude/projects/<project>/memory/,其中 MEMORY.md 的前 200 行或前 25KB 会在每次对话开始时加载,以先达到的限制为准。详细内容应拆进主题文件,按需读取。对于 CLAUDE.md,文档建议每个文件控制在 200 行以内,这是建议目标,不能与自动记忆的加载上限混为一谈。
更反直觉的结果出现在写入规则上。要求「只记录失败」后,Opus 5 和 Opus 4.7 都失去了相当一部分记忆收益。研究给出的解释方向是:对于较强模型,告知记忆的用途,再让模型判断信息是否重要,比预先限定保存类别更有效。
Pokémon Red 实验也展示了不同模型的记录方式:Sonnet 3.7 写了 413 个文件、分布在 225 个文件夹,只获得一枚徽章;Fable 5 使用两个文件夹中的九个文件,另加 global.md,获得四枚徽章。
但这不是「文件少导致成绩好」的因果证明。模型本身也变了,不能据此推出删掉文件就能提高能力。结合 Sonnet 4.6 的表现,更稳妥的结论是:写入可以少设死规则,读取和验证是否需要明确指令,则要按模型实测。
Dreaming 的价值,在于让旧笔记接受复查
记忆可能从写下的第一天就是错的。Anthropic 所说的 dreaming,是在空闲阶段回看日志,对照原始会话修正笔记,或者重新整理知识结构。
在 Pokémon 实验中,dreaming 修正了一条错误的地点笔记,Agent 在第 1,935 次行动到达 Cerulean City;未修正记忆和没有记忆的运行都没有到达。
更接近知识检索应用的是 Stainless 语料实验:约 350,000 个文件、约 420M tokens,使用 25 道有评分标准的问题评估。dreaming 从 2 个会话增加到 128 个会话时,仅靠 wiki 的评分标准满足比例从 13% 升到 48%。
加入搜索后,随着 wiki 增长,综合成绩从 54% 升到 61%;单独搜索是 53%。wiki 与搜索组合还为每个问题节省了约 20,000 tokens。这里的 13% 和 48% 指评分标准满足比例,不能直接理解为完整答对的问题比例。
收益有代价。另一个法律文书任务中,wiki 甚至长得比原始文档更大;离线整理本身也消耗计算资源。
在 Claude Managed Agents 中,Dreams endpoint 处于 research preview。它以异步任务读取一个记忆存储和 1 到 100 个历史会话,写出新的存储,保留输入存储,便于检查后决定是否采用。请求需要 dreaming-2026-04-21 beta header,SDK 会设置;通常耗时几分钟到几小时,按所选模型的标准 token 费率计费。
下面这段原文代码展示了如何限定整理目标,store_id 和会话 ID 需要来自自己的 Managed Agents 运行:
import anthropic

client = anthropic.Anthropic()

dream = client.beta.dreams.create(
    inputs=[
        {"type": "memory_store",
         "memory_store_id": store_id},
        {"type": "sessions",
         "session_ids": [session_a, session_b]},
    ],
    model="claude-opus-5-5",
    instructions=(
        "Focus on coding-style preferences; "
        "ignore one-off debugging notes."
    ),
)
print(dream.id)
重点看 instructions:这次整理聚焦代码风格偏好,忽略一次性调试记录。这属于针对某次维护任务设定范围,不能直接等同于要求所有日常记忆永远只保存某一类信息。原文作者也明确表示,自己没有运行过 Dreams API 或这些配方。
我的判断
我认同它把「存得下」和「用得对」分开讨论。对 AI 编程助手而言,一份总被加载的错误约定,可能比缺少一份笔记更麻烦。分层保存、保留原始记录、按需读取,比持续加长 MEMORY.md 更有依据。
但「给强模型自由」仍有适用前提。数据库问答、游戏探索和团队代码库不是同一种任务,失败记录之外还有哪些信息贡献了收益,原文没说清。它提供的是特定实验中的结果,不是取消所有团队规则的理由。
wiki 加搜索的对照比较有参考价值,但仅有 25 道评测题,也没有足够数据证明整套方案的总成本更低。每题少用约 20,000 tokens,还要减去构建和维护 wiki 的开销。对于变化不多、检索量很小的项目,直接搜索是否更划算,需要另算。
原文作者还开发 Hermes IDE,产品自身也提供跨会话固定信息。他披露了这一利益关联。文章中的产品建议可以参考,但应与 Anthropic 的实验结果分开判断。