16GB笔记本搭建本地大模型服务平台
作者在 M1 Pro、16GB 内存的笔记本上,用 Ollama、LiteLLM 和 Open WebUI 搭建开放权重模型服务。平台包含用户密钥、模型访问限制、限流及数据库请求日志。
AI 深度解读
在 16 GB 内存的 MacBook Pro M1 Pro 上搭一套本地 ChatGPT,模型能回答只是起点。作者做的 OzAI,还要提供独立密钥、限流、用量记录和 IDE 接入。真正花时间的,是排查那些请求成功、答案却不对劲的问题。
这篇实践最有价值的结论是:自托管 LLM 既要管 API,也要检查模型实际吃进了什么、用户等了多久。提示词被截断、推理耗尽输出预算、后台任务抢占资源,都可能不报错,却让产品变得难用。
一台笔记本,能撑起多大的服务
OzAI 没有训练新模型,而是用 Ollama 运行 Qwen3 8B 和 Qwen2.5-Coder 3B,再用 LiteLLM 提供兼容 OpenAI 的网关。Open WebUI 负责聊天,SearXNG 提供搜索,Postgres 保存请求日志,Grafana 展示指标。
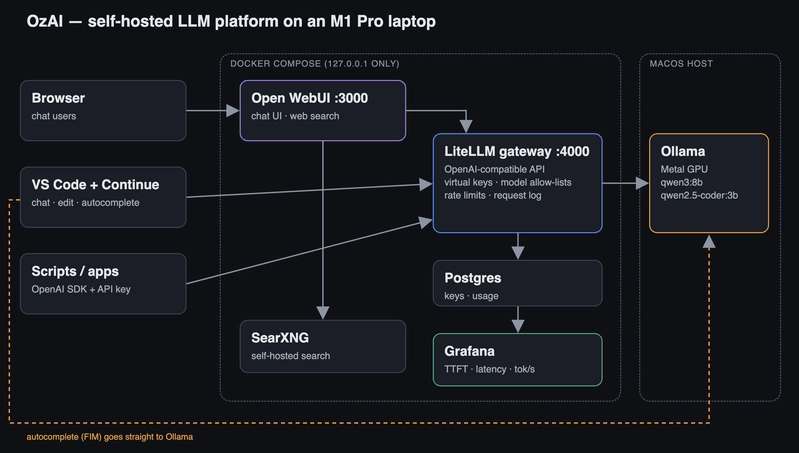
除 Ollama 外,组件都运行在 Docker Compose 中,仅绑定 127.0.0.1,尚未开放互联网访问。Ollama 原生运行在 macOS,通过 Metal 使用 Apple GPU;容器通过 host.docker.internal:11434 访问它。作者这样部署,是因为其 macOS Docker 环境中的 Linux VM 无法访问 Apple GPU,容器里的 Ollama 只能使用 CPU。
先看作者的单请求测试:最大输出 200 tokens,没有并发。
| 模型 | 磁盘占用 | 冷加载 | 提示词处理 | 生成速度 |
|---|---|---|---|---|
| qwen2.5-coder:3b(Q4) | 1.9 GB | 2.1 秒 | 120 tok/s | 53.3 tok/s |
| qwen3:8b(Q4_K_M) | 5.2 GB | 3.9 秒 | 87 tok/s | 22.4 tok/s |
作者用内存带宽解释速度差异:生成每个 token 都要读取权重,模型约大 2.7 倍,速度约慢 2.4 倍。Q4_K_M 大致用每个权重 4 bits 存储,才让 8B 模型压到 5.2 GB;未量化的权重约需 16 GB,已经占满这台机器的内存。
但单人可用,不代表多人可用。另一组测试通过 Python 线程发送流式请求,每次要求 128 tokens:
| 并发用户 | 首 token 时间 p50 | 最慢首 token 时间 | 单用户 tok/s | 总 tok/s |
|---|---|---|---|---|
| 1 | 0.3 秒 | 0.3 秒 | 19.5 | 19.5 |
| 2 | 3.4 秒 | 6.7 秒 | 14.5 | 19.7 |
| 4 | 9.3 秒 | 18.6 秒 | 8.7 | 20.8 |
| 8 | 21.3 秒 | 43.3 秒 | 4.7 | 20.7 |
总吞吐一直在约 20 tok/s,多出来的用户主要是在排队。作者计划后续用 vLLM 的连续批处理,让多个请求在同一轮模型计算中推进,但本文没有给出迁移后的实测。
网关管得住请求,也要管住额外开销
LiteLLM 把真实模型映射成客户端使用的名称,还能为不同密钥配置模型白名单和限流。下面这段配置同时解决普通聊天、深度推理和代码模型的路由:
model_list:
  - model_name: ozai            # 快速聊天
    litellm_params:
      model: ollama_chat/qwen3:8b
      api_base: http://host.docker.internal:11434
      reasoning_effort: none
      num_ctx: 8192
  - model_name: ozai-think      # 同一模型,开启推理
    litellm_params:
      model: ollama_chat/qwen3:8b
      api_base: http://host.docker.internal:11434
      num_ctx: 8192
  - model_name: ozai-coder
    litellm_params:
      model: ollama_chat/qwen2.5-coder:3b
      api_base: http://host.docker.internal:11434
关键是 reasoning_effort: none:默认聊天关闭推理,需要时再选择 ozai-think。作者曾看到一道简单问题在正文出现前输出超过 600 个推理流片段,完整响应约两分钟,其中还包含等待另一请求的时间。max_tokens 太小时,预算甚至全被推理消耗,最终答案为空。
创建用户密钥时,可以直接限制可用模型和每分钟请求数:
curl localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -d '{"key_alias":"demo-friend","models":["ozai"],"rpm_limit":10}'
注意 models 和 rpm_limit 两项。作者验证了无密钥返回 401,越权访问 ozai-coder 返回 403;一分钟内发出 12 次请求时,先有 9 次 200,随后触发 429,因为同一窗口已有一次请求。
预算也有陷阱。max_budget: 0 不代表本地免费模型可以随便调用:检查条件是 spend >= budget,0 ≥ 0 会直接拦截。作者建议不设置预算,或配置自定义 token 价格,让预算有实际含义。
另一笔开销来自 UI。Open WebUI 在回答后,还会请求模型生成标题、标签和后续问题。作者把后台任务切到 3B 的 ozai-coder,关闭标签和后续建议后,体感响应明显改善,但没有提供前后延迟对照。
没报错的请求,为什么仍然答错
状态码正常,只能证明调用完成,不能证明上下文完整。
作者接入搜索后,SearXNG 明明返回了结果,模型仍说无法获取实时信息。线索藏在日志里:无论问题长短、是否搜索,提示词数量都固定在 2,050 tokens。
他发送约 5,000 tokens 的文本,在末尾放入暗号,模型答出了 BANANA,但日志仍显示 prompt_tokens: 2050。末尾保住了,开头却被截掉;Open WebUI 恰好把搜索结果放在开头。
在网关配置加入 num_ctx: 8192 后,作者把暗号移到开头重测,得到 prompt_tokens: 5430,模型仍能答出暗号。内存占用从 5.6 GB 增至 6.2 GB。这比单看「搜索成功」更能验证整条链路。
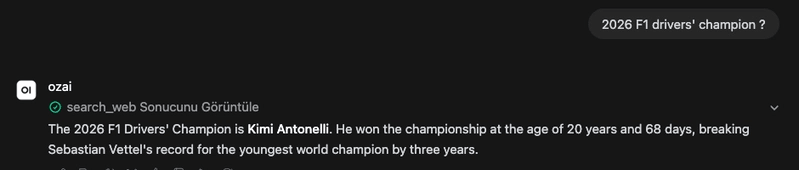
上下文完整也不等于事实可靠。按原文给出的文档对照,KEDA Kafka scaler 的默认 lagThreshold 是 10,模型却自信回答 1000。它还自报知识截止于 October 2023,但这只是模型的回答,不能当作经过验证的训练信息。
作者称,后续加入文档检索增强生成(RAG)后,10 道 KEDA 问题的正确数从 1/10 提升到 8/10。本文尚未展开题目、评判标准和完整实验,能确认的是作者报告了这组结果。
IDE 接入则暴露了协议细节。VS Code 的 Continue 扩展可以通过网关聊天和修改代码,但自动补全使用中间填充(FIM),需要光标前后的代码。作者发现网关的 completions 端点丢失了 suffix、raw 参数,代码模型于是开始解释斐波那契数列,而不是补函数。
最终方案是聊天经过网关,自动补全直连 Ollama,代价是补全不再进入网关用量日志。Cursor 的自定义模型调用来自其服务器,无法访问本机 localhost;Cloudflare Tunnel 和 Access 是作者后续计划,本文尚未实现。
我的判断
这套实践最值得借鉴的是排查方法:先测吞吐,再查请求日志,再用暗号验证上下文是否真的抵达模型。它把「模型感觉不聪明」拆成了能定位的工程问题。
但几处结论需要保留边界。每个模型只有一次单请求测速,并发测试也只覆盖这台机器和当前配置,不能据此认定所有 LLM 服务都只能串行工作。作者提到的 vLLM 连续批处理,正是另一种服务方式。
同样,关闭推理、减少后台任务,是响应速度与功能之间的取舍。作者没有提供回答质量或延迟分布的完整对照,这部分属于经验之谈。
与直接调用托管 API 相比,OzAI 更适合学习推理服务、验证本地工具链。它证明了笔记本可以搭起完整调用路径,还没有证明自托管更便宜、更准确或更适合生产。搜索接入也只说明没有把查询交给第三方 AI 提供商,不等于查询不会离开本机。
能拿来做什么
- 给前端或 Node 聊天应用接本地模型时,可以先固定兼容 OpenAI 的调用入口,再通过模型别名区分快速聊天和推理模式,并验证当前客户端是否正确传递参数。
- 排查搜索或 RAG「接上却没效果」时,可以在长上下文的开头、末尾分别放入测试暗号,同时检查
prompt_tokens,确认内容没有在中间环节被截断。 - 验证多人可用性时,可以复用 1、2、4、8 并发的测试思路,同时记录首 token 时间和总 tok/s,避免只凭单人聊天体验判断容量。
- 接入 IDE 自动补全时,应单独验证 FIM 的
suffix、raw是否抵达 Ollama;如果采用直连方案,也要明确哪些请求不会进入网关日志。