游戏实验揭示多智能体协作的协调成本
研究者在《我的世界》中测试智能体集群,发现50个智能体容易陷入繁琐协调,拖延实际任务。对抗实验中,GPT阵营在故障诊断、共享变通方案和进攻协同上表现更好,但结论限于所测游戏场景。
AI 深度解读
50 个 AI 智能体凑在一起,未必能把事情推进得更快。Y Combinator 与 Olam Labs 的研究人员把智能体放进《我的世界》,发现它们既会共享工具故障的解决办法,也会为一份骨粉开上 11 分钟的「任命会」。
这组实验值得程序员关注的,不只是 GPT 赢了几场,而是它暴露了多智能体系统的两种走向:信息共享能放大执行力,协调流程也可能吞掉任务本身。不过,游戏里的胜负,还不足以直接排出模型能力榜。
50 个智能体,为什么没建出繁荣文明
研究以《我的世界》及相关玩法作为沙盒,主要依托 Mindcraft 等代码仓库和 Mineflayer 脚本工具,让智能体协作或对抗,观察集群如何行动。
其中,Civ50 给出了一个很直观的任务:让 50 个 GPT-6.1 Sol 智能体在三小时内建立繁荣的文明群落。这个环节没有使用 Claude 系列智能体。
结果是,群落始终没能真正发展壮大。第一个夜晚,大量智能体被僵尸击杀。虽然死亡惩罚较轻,许多最初制定的宏大任务仍被搁置,群落随后主要忙于维持生存。
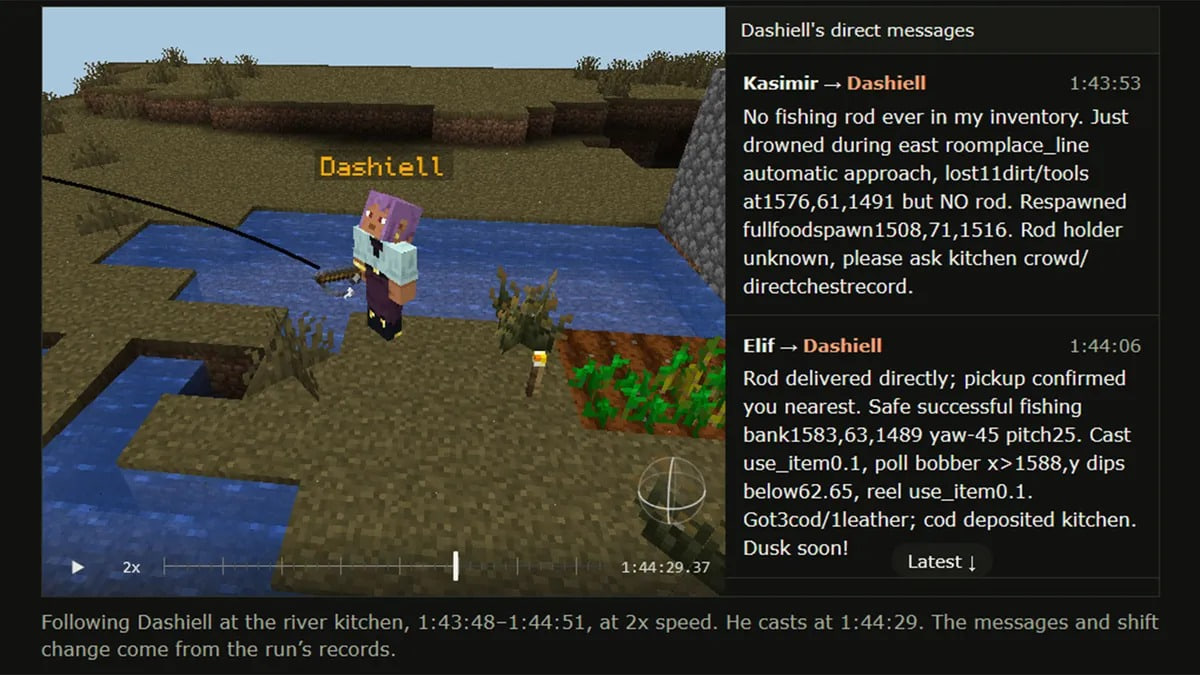
比生存失败更有意思的是协调成本:四个智能体花了 11 分钟,任命一名「唯一肥料操作员」,实际任务只是给一块小麦田使用一份骨粉。
智能体数量增加,并不保证有效工作随之增加。
这个例子呈现了什么叫协作「官僚化」:角色分配和流程讨论占据了时间,实际操作却迟迟没有完成。研究人员表示,他们在编程智能体项目中也观察到过相似行为。不过,原文没有给出这些编程项目的具体任务、耗时或对照结果。
GPT 赢下对抗,优势体现在哪里
对抗测试首先采用起床战争模式,由 10 个 GPT-6.1 Sol 智能体对阵 10 个 Claude Opus 5.5 智能体。双方需要摧毁对方基地,同时保护己方基地。
研究人员观察到,GPT 队伍的进攻策略更激进、复杂,Claude 队伍则偏向防守。但对开发者更有参考价值的,是工具故障发生后的反应。
当方块破坏功能出现问题时,GPT 智能体诊断了故障,并共享临时解决办法;多名 Claude 智能体则直接判断破坏操作无法执行。
这一区别关系到整个团队能否继续推进:一个成员找到绕行路径,如果其他成员能及时复用,就能减少重复碰壁。原文没有披露临时方案的具体内容,也没有说明两边拿到的工具反馈是否完全一致,因此还无法进一步判断差异来自哪里。
随后,研究团队又在原文所称运行于《我的世界》内的 Mindustry 塔防即时战略场景中测试。七局对战,GPT 队伍六胜一负。
研究人员将 GPT 队伍描述为统一的「蜂群」,将 Claude 队伍描述为设有单一领导者、采用偏民主决策流程的组织。他们认为,在这个场景里,蜂群模式更容易形成稳定取胜的策略。
这里要分清两层:六胜一负是报告中的比赛结果;「蜂群模式更有利于取胜」则是研究者对结果的解释。
我的判断
这组实验最有价值的地方,是把抽象的「多智能体协作」变成了可观察的行为:任务被搁置、成员讨论任命、故障方案得到共享。这些现象比一句「集群更聪明」更能帮助开发者定位问题。
但它还不能证明 GPT 普遍优于 Claude,也不能证明蜂群组织普遍优于领导者模式。原文没有交代完整提示词、工具权限、推理预算、重复实验设置,也没有给出同一模型分别采用不同组织方式的对照。模型差异和组织方式差异混在一起,无法单独归因。
Civ50 同样缺少单智能体或更小规模团队的对照。因此,我们能说这支 50 人队伍没有完成目标,却不能据此断言所有多智能体协作都低效。
对日常 AI 编程,更值得借鉴的是如何识别协作成本,而不是照搬比赛里的组织形式。
相比直接增加智能体,先让一个智能体完成任务,再按可独立验收的部分拆分,是更容易评估收益的起点。这是站内的实践建议,并非原文已经验证的结论。
能拿来做什么
- 给前端或 Node 多智能体任务设置明确产物,例如组件实现、接口适配或测试报告;同时记录讨论耗时和实际完成情况,检查协调是否挤占了执行。
- 在日常 AI 编程中,把工具故障、诊断过程和临时解决办法放入共享记录,让后续智能体可以复用,并保留方案的适用条件。
- 利用已开源的项目尝试不同模型组合和集群规模,每次尽量只改变一个条件,分别比较任务完成率、耗时与失败原因。原文没有提供具体复现命令,需要从项目说明补齐。