RAG 文档处理:先保留结构,再切分
文章指出,PDF 扁平化提取与固定字符切分会破坏检索上下文,应先恢复布局、阅读顺序和表格,再按章节等结构切分。保留标题、页码及父子关系可支持过滤和引用,视觉密集页面则可考虑直接检索页面图像。
AI 深度解读
PDF 问答答错,不一定是模型不够强。表格失去表头、标题脱离正文、多栏内容顺序错乱之后,再好的检索和生成也只能处理残缺材料。原文的核心主张是:先恢复文档结构,再按结构切块,最后才考虑长度限制。
作者用 Docling 和 LangChain 跑通了一个小样例,也讨论了父子检索、摘要树和 Agent 接入。它值得读的地方,是把排查顺序从「换模型」前移到「检查入库材料」;但样例简单,不能直接当成复杂 PDF 的效果保证。
为什么切得整齐,检索却可能更差
传统流程常把 PDF 提取成连续文本,再每隔 1,000 个字符切一块。丢失的信息却可能早在切分前就发生:多栏阅读顺序、标题与正文的归属,以及表格的行列关系,都不一定保得住。
RecursiveCharacterTextSplitter 会优先沿段落等分隔符切分,适合干净正文,但它看不见表格。作者用 chunk_size=200、chunk_overlap=0 演示:收入说明落在第一块,表格和下一节的 Risk Factors 标题落在第二块,风险正文落在第三块。字符数符合要求,内容却无法独立理解。
原文提到,LangChain 教程采用 chunk_size=1000、chunk_overlap=200。放大预算能推迟断裂,重叠能补回部分上下文,但都不能保证表头与数据、标题与正文始终同行。
切块的第一目标,是保住能独立解释的信息单元。
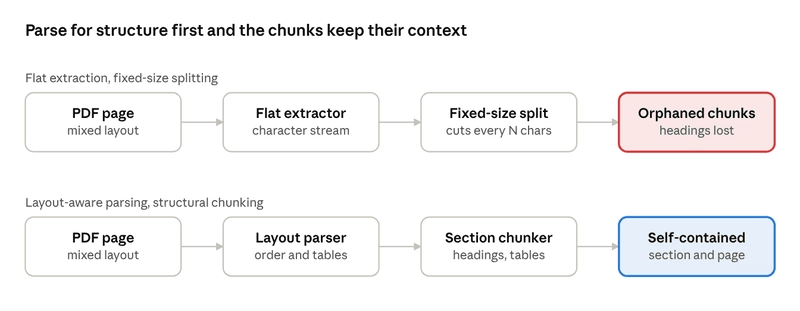
文档智能(Document Intelligence)先识别标题、正文、表格、图片和页脚,再恢复阅读顺序、表格结构,扫描件还需要 OCR。Docling 用布局检测模型识别区域,再由 TableFormer 恢复表格,包括缺失边线、空单元格和跨行跨列关系。
训练材料也影响适用范围。原文介绍的 DocLayNet 包含 80,863 页人工标注数据、11 类元素,覆盖财务、专利、法律和手册等版式。它比只用论文版式更广,但不代表你的票据和扫描件一定能识别准确。
Docling 能恢复结构,但输出仍要检查
作者的运行环境是 Python 3.13、langchain 1.4.7、langchain-docling 3.0.0、docling-slim 2.145.0 和 langchain-text-splitters 1.1.3。安装命令为 pip install -U "langchain-docling[local]" langchain langchain-text-splitters。其中 [local] 会带入标准本地模型依赖;作者裸装时曾因缺少格式依赖遇到 ImportError。
先查看解析结果,是整条流程中很有用的一步:
from langchain_docling import DoclingLoader
from langchain_docling.loader import ExportType

docs = DoclingLoader(file_path="acme_10k.pdf", export_type=ExportType.MARKDOWN).load()
print(docs[0].page_content)
要看的是 export_type=ExportType.MARKDOWN:它每个文件返回一个完整 Markdown Document,便于人工检查;ExportType.DOC_CHUNKS 则每块返回一个 Document,默认使用 HybridChunker。加载接口还提供一次性读取的 load() 和流式读取的 lazy_load()。
测试里表格保住了表头,但所有标题都变成 ##,文档标题还与首节标题合并。因此,MarkdownHeaderTextSplitter 的标题匹配规则必须依据实际输出设置,不能照搬手写 Markdown 的层级。
切分方面,HierarchicalChunker 按检测到的文档元素输出,默认只合并列表项;HybridChunker 再拆分过大的块,并通过默认开启的 merge_peers 合并共享标题和图注的小块。表格跨块时,默认开启的 repeat_table_header 会重复表头。
还有三个容易漏掉的细节:
- 作者显式使用 MarkdownTableSerializer,才避免默认序列化把表头与数值的对应关系弄丢。
- 示例用
sentence-transformers/all-MiniLM-L6-v2的 tokenizer,设置max_tokens=512;计数器应与实际 embedding 模型对齐。 - DoclingLoader 已将
chunker.contextualize(chunk)放进page_content,而source、section、pages、has_table被提成平铺元数据,方便过滤和引用。
Markdown 表格不能表达合并单元格。原文以 Mistral OCR 3 输出 HTML 的 colspan、rowspan 为例,提醒选型时检查表达能力。作者建议拿最难处理的 10 页测试,比只看整洁样例更有价值。
检索小块、返回大块,比一味加长切块更灵活
有标题时,可以先用 MarkdownHeaderTextSplitter 分节,再用 RecursiveCharacterTextSplitter 限制长度。需要让 embedding 看到标题,应设置 strip_headers=False,默认值是 True。
父子检索进一步拆开了两个需求:小块负责精确匹配,大块负责提供上下文。子块进入向量库,父节保存在文档存储中,命中子块后返回完整父节。
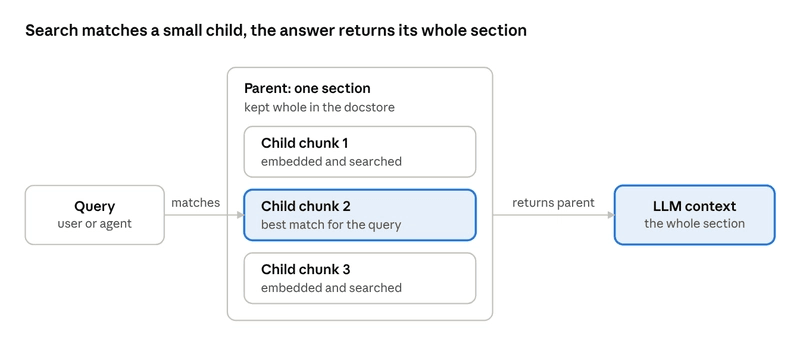
作者在 langchain-classic 1.0.8 中验证了 ParentDocumentRetriever,配合 InMemoryVectorStore、InMemoryStore 和 child_splitter,示例子块大小为 80 字符。父节太长时可加 parent_splitter;测试设置 150 字符上限后产生 3 个父块,最长 148 字符。不过这里使用假 embedding,只验证了返回完整父节的机制,不能证明排序更准。
全篇归纳则是另一类问题。RAPTOR 来自 ICLR 2024:先切成 100 token 的叶子块,经 UMAP 降维、Gaussian Mixture Models 软聚类,由 BIC 选择聚类数量,再用 LLM 生成摘要并递归建树。
查询既可逐层遍历,也可用 collapsed tree,把所有层节点放在一起排序。论文在 QASPER 上后者表现更好,并报告结合 GPT-4 后,QuALITY 的最佳结果提高了 20 个绝对准确率百分点。代价是索引阶段增加 LLM 调用;作者还引用约 4% 摘要存在轻微幻觉的分析。这些是论文结果,不是本文样例测出的收益。
没有标题的转录稿或长文,才更适合考虑语义切分和 Agent 切分。原文同时提醒,SemanticChunker 所在的 langchain-experimental 已出现停止积极维护的弃用警告,采用前应与普通递归切分比较。
Agent 能引用来源,前提是入库时留下来源
Agentic RAG 让 Agent 决定何时检索,但检索工具返回什么,仍由入库流程决定。作者通过 @tool 包装 search_filings,调用 similarity_search(query, k=4),返回带章节和页码的文本,再交给 create_agent。
示例模型字符串是 anthropic:claude-sonnet-5。作者只用 stub chat model 测试了工具输出与 Agent 构建,没有验证真实模型的回答质量。
结构元数据的用途很直接:章节和页码支持回查;向量库支持过滤后,section、has_table 可以成为工具参数;多轮检索内容太多时,原文引用 Deep Agents 教程,把材料写入 Agent 文件系统,只返回文件路径供后续分析。
检索内容还可能包含针对 Agent 的指令。提示词要求只把文档当数据,属于缓解措施,仍要限制工具权限。
对于幻灯片、图表和密集表单,原文最后提出直接检索页面图像:ColPali 基于 PaliGemma-3B,跳过文本提取。但提供的原文在 patch 表示的说明处截断,后续参数和实验没有给全,不能补写结论。
我的判断
我认同先检查入库材料。表格已经丢掉列名时,换 embedding 模型很难补回原始对应关系。不过,结构切分并不总比递归切分划算:干净文章可以先用简单方案,复杂 PDF 才更需要布局恢复。
作者只测试了自行生成的单页 PDF。约 34 秒的 CPU 首次运行包含权重下载和两次转换,是冷启动记录,不是性能基准。父子检索用了假 embedding,Agent 用了 stub,结构切分相对普通切分也没有统一评测。因此,它提供的是可复现的机制示例和工程经验,尚不能证明业务效果必然提升。
父块越大,上下文成本也越高;摘要树又增加索引成本。选型应围绕真实问题比较,而不是把所有策略叠起来。
能拿来做什么
- 给 PDF 知识库建立一组困难页面样本,先检查多栏顺序、标题归属和表格,再调检索模型。
- 在现有检索接口中保留章节、页码和文件来源,让前端答案可以展示可回查的引用。
- 对「命中正确但上下文不足」的问题试验父子检索,并同时记录检索效果与上下文用量。
- 接入文档 Agent 时,让工具返回来源信息,并限制工具权限;不要把提示词中的防注入要求当成完整保障。