在 Next.js 中实现带鉴权的 MCP 服务
教程通过 TypeScript SDK、Zod 工具参数定义及 App Router 路由,构建使用 Streamable HTTP 的 MCP 服务。实现包含 Origin 检查和 bearer token 鉴权,并以博客管理工具为案例,作者称代码已通过类型检查和运行验证。
AI 深度解读
给现有 Next.js 应用接上 MCP,不一定要再维护一套服务。作者的方案是把内容管理能力放进 App Router,通过一个经过鉴权的 HTTP 入口,让 AI 客户端调用现有业务代码。真正值得读的,是工具定义、请求隔离和权限边界怎样配合。
不过,这篇教程也有需要核对的地方:它采用的 SDK 与协议版本有明确前提,静态令牌和 OAuth 的表述存在张力,示例代码也没有覆盖作者列出的全部生产防护。可以参考架构,不能照抄后就当作完整上线方案。
为什么把 MCP 放进现有 Next.js 应用
MCP(Model Context Protocol)让 AI 应用发现并调用服务端能力。工具是可调用的函数,资源是通过 URI 读取的数据,提示词是可复用的模板。本文只实现工具,通过 JSON-RPC 接收调用。
作者的网站允许 Agent 查询、创建和发布博客、作品集。把入口放在 /api/mcp,工具就能复用页面和后台使用的 Prisma、校验逻辑与业务层;写入后,再刷新受影响的页面、站点地图和订阅源,让 Agent 发布与人工发布走同一条业务路径。
MCP 接入的价值,在于复用业务能力,同时让兼容客户端发现和调用它们。
这与 Next.js DevTools MCP 不同,后者帮助编程 Agent 检查开发服务器。这里是在应用里搭建自己的远程服务,也不要求使用 Vercel,作者的网站自托管在 Coolify。
传输方式则选 Streamable HTTP。stdio 由客户端启动本地子进程,不适合这个远程 HTTP 入口。按原文引用的 2026-07-28 协议修订,每条消息通过同一路径 POST,响应可以是 JSON,也可以是限定在当前请求内的 SSE 流;GET 流入口、协议会话、initialize 握手及 Mcp-Session-Id 均已移除。旧版 2024-11-05 的 HTTP+SSE,则在 2025-03-26 被 Streamable HTTP 替代。
这些是原文给出的版本前提,不能直接套到使用旧协议的项目。
工具定义决定模型能否正确调用
原文采用官方 TypeScript SDK v2,测试版本为 2.3.1,安装命令是 npm install @modelcontextprotocol/server zod。它将 @modelcontextprotocol/server 与旧版 @modelcontextprotocol/sdk 区分开,后者仍有 1.32.x 面向已有项目。
依赖要求是 Zod 4,即 zod ^4.2.0,导入路径为 zod/v4。使用 TypeScript 6 或更高版本时,作者要求在 tsconfig.json 的 compilerOptions 加上 "types": ["node"],因为发布的类型引用了 Buffer。
工具通过 server.registerTool(name, config, handler) 注册。其中,描述告诉模型何时调用,inputSchema 约束参数,outputSchema 配合 structuredContent 提供可校验的结构化结果。
例如,list_posts 允许按 draft、published 和最长 200 字符的搜索词过滤;create_post 要求标题为 8 至 180 字符,slug 符合 /^[a-z0-9]+(?:-[a-z0-9]+)*$/,正文至少 1 字符,并且只创建草稿。
字段上的 .describe() 也会进入客户端看到的 JSON Schema。给模型写清字段用途,比只起一个参数名更有用。参数校验失败时,按作者描述,SDK 会返回带有 isError: true 的可读结果;slug 重复这类业务错误也采用同样形式,让模型有机会修改后重试。
但示例只是内存数组:虽然接收了 content,处理函数并未保存它。它展示的是工具注册方式,不能充当完整 CMS 数据层。
另外,readOnlyHint、destructiveHint 都只是客户端提示。权限仍要由业务代码检查,工具声明只读或非破坏性,不会自动获得安全保障。
HTTP 入口接通之后,还缺哪些防护
作者将实现拆成 lib/mcp/server.ts、lib/mcp/auth.ts 和 app/api/mcp/route.ts 三个文件。请求先过 Origin 和 bearer 校验,再交给 SDK。
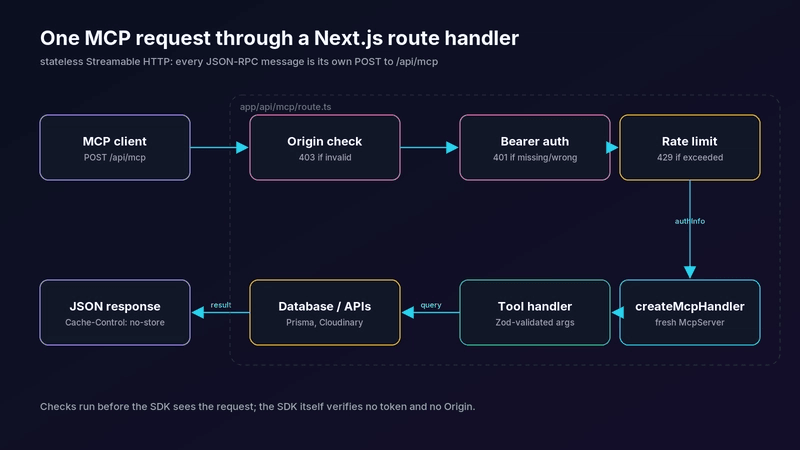
下面这段负责把工具挂到 Next.js 路由,并把身份信息传给 SDK:
// app/api/mcp/route.ts
import { createMcpHandler, originValidationResponse } from "@modelcontextprotocol/server"
import { verifyBearer } from "@/lib/mcp/auth"
import { createServer } from "@/lib/mcp/server"

export const runtime = "nodejs"
export const dynamic = "force-dynamic"

const handler = createMcpHandler(() => createServer(), { responseMode: "json" })
const ALLOWED_ORIGINS = ["www.example.com", "localhost"]

async function handle(request: Request): Promise<Response> {
  const badOrigin = originValidationResponse(request, ALLOWED_ORIGINS)
  if (badOrigin) return badOrigin

  const authInfo = verifyBearer(request)
  if (!authInfo) {
    return Response.json(
      { error: { code: "UNAUTHORIZED", message: "Invalid or missing bearer token" } },
      { status: 401, headers: { "WWW-Authenticate": 'Bearer realm="mcp"' } }
    )
  }

  const response = await handler.fetch(request, { authInfo })
  const headers = new Headers(response.headers)
  headers.set("Cache-Control", "no-store")
  return new Response(response.body, { status: response.status, headers })
}

export { handle as POST }
重点看 handler.fetch(request, { authInfo }):身份已经由前面的代码验证,SDK 不替你完成令牌和 Origin 校验。
按作者说明,createMcpHandler 每次请求调用工厂,生成新的 McpServer;连接池和缓存应放在模块作用域。responseMode: "json" 固定返回 JSON,需要进度通知时可省略,让 SDK 使用 SSE。runtime = "nodejs" 则满足鉴权代码使用 node:crypto 的要求。
鉴权辅助函数读取 MCP_TOKEN,用 SHA-256 将两侧令牌变成等长摘要,再交给 timingSafeEqual 比较,避免直接比较不同长度时抛错。无 Origin 的 CLI、服务端 Agent 请求会继续进入鉴权,非法 Origin 则返回 403。
作者称在 SDK 2.3.1 上测得:缺令牌返回 401,Origin: https://evil.com 返回 403,有效令牌可取得工具列表并返回 200。接客户端前,可以先用这段命令检查入口:
curl -s https://www.example.com/api/mcp \
  -H "Authorization: Bearer $MCP_TOKEN" \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/list","params":{}}'
重点保留 Accept 中的两种类型,原文要求客户端同时接受 JSON 与 SSE。Cursor 则在 ~/.cursor/mcp.json 的 mcpServers 中配置完整 url 和 Authorization 请求头;本地可运行 next dev,连接 http://localhost:3000/api/mcp,再用 MCP Inspector 逐个调用工具。
生产防护并未全部写进示例。作者实际采用鉴权失败每 IP 每 15 分钟 30 次、鉴权成功每 IP 每分钟 120 次的两档限流;删除要求 confirm: true,发布单独经过 publish_post,检查 SEO 字段和图片 alt。获取远程图片的工具还拒绝回环及私有地址,防止 SSRF。
部署到多实例时,共享限流可放到 Redis;serverless 则需为慢工具设置足够的 maxDuration。协议无会话,不代表业务数据和限流状态都能放进单实例内存。
我的判断
我认可工具复用现有业务层、创建默认落草稿、发布单独设门槛的设计。这些边界比让一个大工具处理所有操作更容易审查,也便于定位失败原因。
但原文有几处不能直接背书。
首先,文字说未设置令牌时返回 404,展示的代码却返回 401;文字要求所有响应 no-store,代码只在 SDK 返回后设置,Origin 和鉴权提前返回的分支没有覆盖。两处都需要补齐。
其次,作者一边推荐个人 Agent 使用静态 bearer,一边说 HTTP 鉴权必须遵循包含 Protected Resource Metadata(RFC 9728)的 OAuth 2.1 流程。这两种表述需要进一步澄清。多用户接入也不能只把 verifyBearer 换成 JWT 校验,就当作完整 OAuth 实现;发现流程、用户授权和权限范围仍需落实。
原文还提及 CVE-2026-104850,称实验中仅升级未能阻止泄漏,直到传入 expectedIssuer。这里没有完整复现材料,只能视为作者的安全提示,不能替代针对具体依赖的核验。
最后,MCP 有额外成本。作者引用另一项同数据测试:REST 的 p50 为 76 µs,MCP 为 424 µs,网站的 21 个工具占用 5,949 tokens 上下文。本文未提供完整测试条件,不能据此推广性能结论。如果调用方固定、只是执行几个确定动作,普通 REST API 仍然是合理选择。
能拿来做什么
- 已有 Next.js 后台可以先接入
list_posts这类只读工具,复用现有查询层,确认模型能够正确选工具、传参数后,再开放写入。 - 给 Node 内容管理能力增加 Agent 入口时,把创建、发布、删除拆开,并在处理函数中检查权限、确认参数和发布条件。
- 联调时先用
curl或 MCP Inspector 检查工具列表、参数错误和业务错误,再接 Cursor,同时核对项目实际安装的 SDK 与协议版本。 - 上线前补齐示例缺少的限流、提前返回分支的缓存头和持久化,并按个人使用或多用户接入分别落实鉴权方案。