Forgekit 集成聊天、鉴权与 RAG 应用骨架
Forgekit 是采用 MIT 许可的 Next.js AI 应用模板,集成流式聊天、模型接入、鉴权、会话存储及基于 pgvector 的文档检索。项目使用 AI SDK、Better Auth、Drizzle 和 PostgreSQL,支持 Docker、Coolify 或 Vercel 部署。
AI 深度解读
Forgekit 想解决的,是 AI 聊天应用里最费时间的接线工作:登录、会话保存、模型切换、文档检索、用量记录和部署。作者把这些装进一个 MIT 开源的 Next.js 项目,主打自己掌握数据库、服务器和模型入口。
它值得看的地方,是这些能力如何串成一条可运行的链路。作者做过本地和 Docker 冒烟测试,也修出了真实的持久化问题。不过,能跑通与能直接承接生产业务,仍有距离。
一个 Next.js 应用加一个数据库,能包办多少事
Forgekit 使用 Next.js App Router,浏览器把消息发送到 /api/chat。服务端检查登录状态和请求频率,再通过 AI SDK 的 streamText 调用模型与工具;回复流结束后,保存消息和 token 用量。
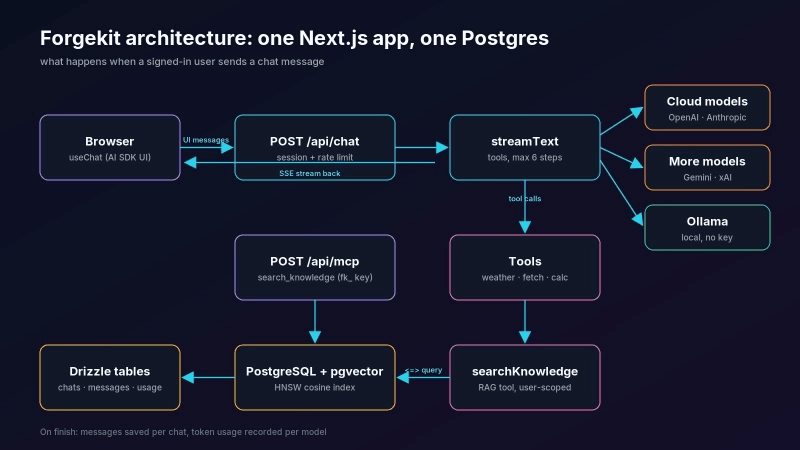
聊天、消息、文档、向量分块、API key、用量记录,以及限流的回退存储,都放在 PostgreSQL。pgvector 是数据库扩展,因此这套方案不需要额外维护一个向量数据库服务。对已有 PostgreSQL 运维经验的小团队,这能减少备份和部署对象。
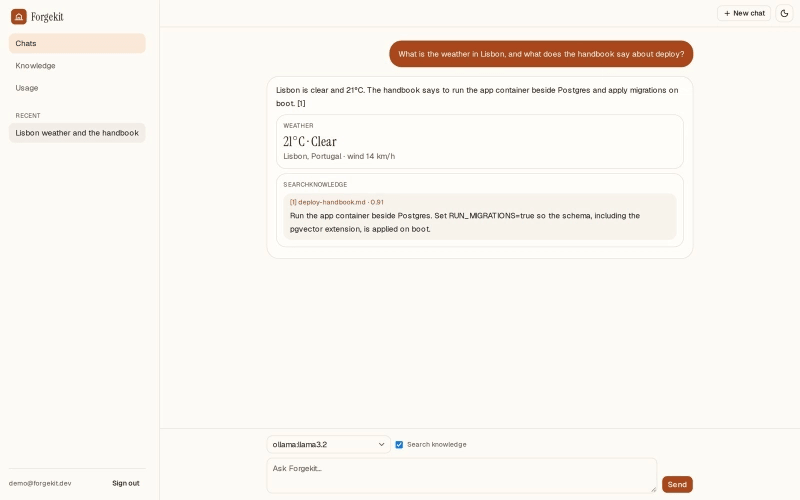
内置能力包括五家模型提供方、三个工具、保存会话的流式聊天、文档 RAG、邮箱和 GitHub 登录、按用户限流,以及 MCP 入口。五家提供方分别是 OpenAI、Anthropic、Google、xAI 和 Ollama,模型选择器只展示已配置的提供方。
原文锁定的版本为 Next.js 16.4.2、React 19.3、ai 7.0.142、Better Auth 1.7.10、Drizzle ORM 0.45.4、MCP SDK 1.32.1。这些是作者写作时的版本声明,不能当作经过本文独立核验的兼容性结论。
扩展模型时,统一目录的设计比较实用。模型定义放在 lib/ai/models.ts,调用分支放在 lib/ai/providers.ts 的 languageModelFor;模型选择器、/api/models 和聊天路由共用目录。添加 Mistral 的示例,是执行 pnpm add @ai-sdk/mistral,再补上 PROVIDERS、CATALOG、MISTRAL_API_KEY 和对应分支,模型名使用 mistral-large-latest。
流式回复之外,真正要看的是消息怎么落库
作者在干净检出后运行了 pnpm install --frozen-lockfile、pnpm typecheck、pnpm lint、pnpm test 和 pnpm build,报告全部通过,其中测试覆盖 6 个文件、15 项测试。
随后,他们连接 pgvector Postgres 和一个模拟的 Ollama 端点,验证注册、创建聊天、流式回复、历史记录、用量统计及文档上传,并分别检查了 pnpm start 和 Docker 镜像。
这个验证有价值,也有边界:模拟端点能检查应用链路,不能证明真实模型的工具调用质量或检索回答质量。
冒烟测试发现两个问题:助手消息使用空 id,导致同一会话第二次回复保存失败;pnpm db:migrate 和 pnpm start 没有读取 .env。作者称已在 main 修复。
下面这段核心代码,把用量记录和消息持久化放到了各自的结束回调中:
const result = streamText({
  model: resolved.model,
  system: SYSTEM_PROMPT,
  messages: await convertToModelMessages(messages),
  tools,
  stopWhen: isStepCount(6),
  onEnd: async ({ totalUsage }) => {
    await recordUsage({
      userId: user.id,
      modelId: body.modelId!,
      inputTokens: totalUsage.inputTokens,
      outputTokens: totalUsage.outputTokens,
      totalTokens: totalUsage.totalTokens,
    });
  },
});

return createUIMessageStreamResponse({
  stream: toUIMessageStream({
    stream: result.stream,
    originalMessages: messages,
    sendSources: true,
    generateMessageId: () => crypto.randomUUID(),
    onEnd: async ({ messages: nextMessages, isAborted }) => {
      if (isAborted) return;
      await saveMessages(chat.id, nextMessages, body.modelId!);
    },
  }),
});
要盯住 generateMessageId:界面显示出回复,不代表消息已经具备可持久化的稳定标识。另一个细节是 isAborted,这段代码在流中止时跳过保存,接入业务前需要确认这是否符合自己的会话恢复预期。
stopWhen: isStepCount(6) 用来限制工具调用循环。默认限流为每用户 60 秒内 30 次请求,由 RATE_LIMIT_REQUESTS 和 RATE_LIMIT_WINDOW_SECONDS 配置。
请求限流、调用步数限制和 token 统计,都不能直接替代用户预算额度。
作者也只说可以在用量记录上继续增加硬配额,没有声称已经实现按金额封顶。
RAG 的关键约束,是用户隔离和向量维度
文档上传后,Forgekit 按 800 字符切块,相邻块重叠 120 字符,生成 1536 维向量,存入带 HNSW 余弦索引的 pgvector 列。
提问时,searchKnowledge 工具把查询转成向量,检索当前用户的文档块,再返回带编号的引用。RAG 在这里就是先从资料里找相关片段,再交给模型回答。
检索代码直接展示了用户过滤和结果数量限制:
const embedding = await embedQuery(query);
const similarity = sql<number>`1 - (${cosineDistance(chunk.embedding, embedding)})`;

const rows = await db
  .select({ content: chunk.content, documentName: document.name, score: similarity })
  .from(chunk)
  .innerJoin(document, eq(document.id, chunk.documentId))
  .where(eq(chunk.userId, userId))
  .orderBy(desc(similarity))
  .limit(Math.min(Math.max(limit, 1), 8));
重点是 .where(eq(chunk.userId, userId))。这条查询把用户范围写进数据库条件;结果数被约束在 1 到 8。索引使用 vector_cosine_ops,但原文没有给出这套应用的检索延迟、召回率或文档规模测试。
嵌入提供方默认按 OpenAI、Google、Ollama 的顺序选第一个可用项,也可以用 EMBEDDING_PROVIDER 指定。OpenAI 使用 text-embedding-3-small,Google 使用 gemini-embedding-001,并将 outputDimensionality 设为 1536。
本地 RAG 容易卡在这里:常见的 nomic-embed-text 输出 768 维,与固定的 1536 维列不匹配。要么选择输出兼容的模型,要么一起修改列和迁移。进一步说,更换嵌入模型时,即使维度相同,也不能默认已有文档向量还能与新查询向量混用。
知识库还通过 POST /api/mcp 暴露 search_knowledge,供 Claude Desktop、Cursor 或其他 agent 调用。凭证是在 Usage 页面创建的 fk_ bearer key,数据库只保存其哈希。
自定义工具则放在 lib/ai/tools.ts 的 createChatTools 中,由 tool()、Zod 输入结构和 execute 组成。工具可以接收 userId 来落实数据范围;内置 webFetch 还会拒绝私有网络地址,限制模型选取 URL 后访问内网的风险。
我的判断
Forgekit 的方向适合希望自己控制基础设施的小团队:先在一个 Next.js 应用和一个 PostgreSQL 中理解整条链路,再决定哪里值得拆开。作者称 lib 目录不足 1,000 行 TypeScript,这也让它适合作为阅读参考。
但「集中存储更省事」仍是有条件的工程取舍。原文没有给出并发负载、检索质量、租户隔离全链路测试,也没有证明 pgvector 能满足任意规模的知识库。单条查询包含用户过滤,是正确做法,却不足以证明所有文档入口都没有越权问题。
与 Vercel Chatbot 的比较,同样应按部署偏好理解。作者依据截至 2026 年 10 月的 README 做对比,没有提供性能或开发耗时对照,因此「更适合自托管」可以作为设计定位,「更高效」则没有证据。
部署材料比较具体:作者构建的生产镜像为 284 MB,使用非 root 用户;配置 RUN_MIGRATIONS=true 后启动时执行迁移,/api/health 检查数据库连接。不过,这个大小只是作者构建结果,启动迁移也仍需结合自己的发布流程评估。
能拿来做什么
- 如果你准备做内部文档聊天,可以先用 Node.js 22、pnpm 和 Docker 跑通
git clone、bash scripts/setup.sh、pnpm dev,再用真实资料检查引用是否准确、用户之间能否访问彼此文档,而不只看回复是否流畅。 - 如果你正在写 Next.js AI 聊天,优先检查消息 id、流结束保存和中止行为。可以参考这段持久化代码,再为自己的断流重试与历史恢复明确规则。
- 如果你想用 Ollama 降低试用门槛,可以配置
OLLAMA_BASE_URL=http://127.0.0.1:11434和OLLAMA_MODELS=llama3.2,qwen2.5,先验证聊天,再单独解决嵌入模型的维度与存量向量问题。 - 如果你准备自托管,按原文用
docker compose up -d --build启动应用与pgvector/pgvector:pg17,补齐DATABASE_URL、BETTER_AUTH_SECRET、BETTER_AUTH_URL和模型配置。容器里的127.0.0.1指向容器自身;部署到 Vercel 时,则需要可访问的托管 Postgres、托管模型,并先执行一次pnpm db:migrate。