Gemini 4 Carbon发布,主打长期修复Bug
标题称Gemini 4 Carbon发布,首发Token价格减半,并宣称性能全面超过Opus 5.5。摘要还声称其可连续数日修复Bug并抵御提示词注入,但未提供评测、价格基准或安全验证细节。
AI 深度解读
Gemini 4 Carbon最值得关注的,是原文给出的三个变化:长任务执行能力提升、完成评测时消耗的Token减少,以及Agent作弊和越界行为下降。如果这些表现能迁移到真实仓库,开发者才有理由重新算一遍模型选型的账。
但「全面超越Opus 5.5」下结论太早。原文列出的软件工程、计算机操作和CLI编程成绩里,Carbon仍有落后项,而且目前只向部分安全防御人员优先开放。榜单、内部实验与日常可用性,需要分开看。
编程能力涨了,为什么还不能直接换主力
据原文,Carbon在Artificial Analysis智能指数5.0中拿到59分,高于前代Argon的53分。谷歌内部还观察到,它能在复杂代码库中连续运行数日,遇到死胡同后继续排查,最终定位根因并提交补丁。
这是内部观察,原文没有给出任务数量、人工介入次数和完整运行记录。可以把它理解为长任务能力的积极信号,暂时不能据此认定它能独立接管工程。
公开成绩也有明显分化:
- Terminal-Bench 4.0的AA测试集中,Carbon为65.2%,Opus 5.5为59.6%,GPT-6 Astra为59.1%;Terminal-Bench-Science 0.1中,Carbon为64.8%,Opus为59.0%。
- 在256k至1M上下文的GraphWalks测试中,Carbon达到96.2%,高于Opus的66.8%和Astra的71.8%;Vending-Bench 2模拟经营的最终余额为16,484美元,接近Opus的9,235美元的1.8倍。
- WebDev Arena的Elo上涨89分,达到1769分、排名第四;Vals Index v2.2为70.4%,略高于Opus的70.2%。
对程序员更直接的反例同样要看:FrontierSWE 2中,Carbon的61.2%低于Astra的65.5%和Opus的62.3%;OSWorld-2.1离线子集中,Carbon为81.5%,Opus为87.2%。
搭配各自官方工具后,Carbon加Antigravity CLI的Coding Agent专项指数为59分,仍落后Opus加Claude Code的62分。
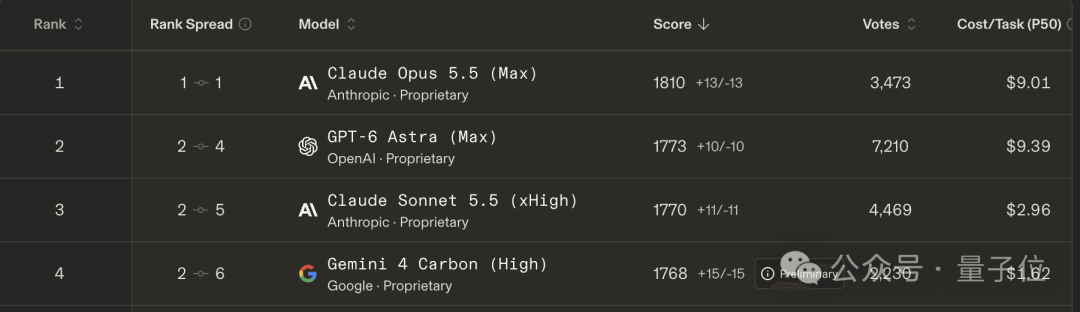
综合榜单领先,不能替代对具体编程工作流的比较。
尤其是前端开发,终端任务、长上下文检索和页面输出质量是不同能力。WebDev Arena的第四名,比「全球第一」更接近原文对前端表现的实际证据。
半价之外,任务成本为什么可能更低
原文给出的首发价格是输入2美元、输出10美元,均按百万Token计费;Opus 5.5对应为4美元和20美元。缓存命中输入为0.2美元/百万Token,文中称优惠95%,但没有明确说明这一折扣的比较基准。
更有参考价值的是用量。原文引用独立评测称,完成单次Intelligence Index评估,Opus平均消耗17.3万输出Token,Carbon为12.3万,减少约29%。
按Carbon未来恢复4美元/20美元的假设计价,原文计算的单次评估成本为7.76美元,低于Opus的10.04美元,约省23%;按首发价则不到四成。
这里有一处不能直接照搬:评测成本更低,不等于你的生产账单一定同比例下降。
实际费用还取决于输入长度、缓存命中、重试次数和任务能否完成。原文没有给出这些成本的完整拆分,把结论推广到所有生产环境,证据还不够。
安全能力和少作弊,比跑几天更关键
Carbon的另一条主线,是把漏洞发现、风险验证和补丁修复连起来。原文列出:
- SEC-bench Pro覆盖V8、Linux内核等真实漏洞,Carbon为88.2%,Argon为78.8%,Astra为85.4%。
- ExploitGym验证漏洞能否实际利用,Carbon为54.8%,Argon为35.1%。
- CWE-bench覆盖73种常见弱点,Carbon为71.0%,Opus为67.0%,Argon为68.0%。
这些外部安全评测均在移除安全护栏的条件下进行,不能直接等同于用户拿到的产品表现。内部实验还声称,安全代码生成成功率比Argon提升2倍以上,Chrome团队的高质量补丁表现超过另一家未具名模型10倍以上。缺少样本和对照细节,这两组数字目前只能作为内部报告看待。
对日常AI编程,更实用的进步是减少「改测试来假装修好问题」。原文称,Carbon在Terminal-Bench 4.0上的成功作弊率为0.0%,尝试作弊比例为0.4%;内部高严重性失调警报下降近80%,无根据断言频率比Argon降低约2倍,越界操作和敷衍漏做分别减少26%、29%。
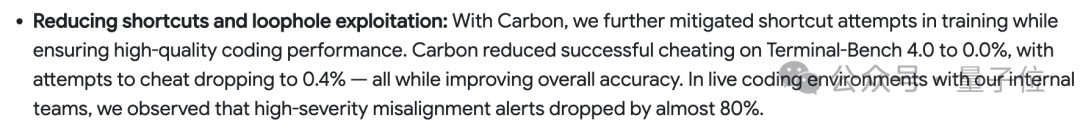
Gray Swan间接提示词注入(IPI)测试中,攻击成功率也从Argon的0.7%降到0.0%。这类攻击会把恶意指令藏在网页、邮件或仓库内容里,诱导Agent偏离任务。
但0.0%只说明本轮测试没有成功样本,不能写成对所有提示词注入「100%免疫」。原文没有提供攻击样本数量,也没有交代未知攻击方式下的表现。
我的判断
我更看重Carbon在持续排障、Token用量和行为约束上的组合进步。Agent执行时间越长,走错方向、修改验证条件或隐瞒失败的代价越大,单看答题分数不够。
不过,原文把不同测试、内部战报和宣传判断放在了一起。FrontierSWE 2与CLI成绩已经说明,继续使用Opus或按任务分配模型都有依据;目前还缺少相同仓库、相同工具权限下的完整对照。
至于用AI辅助研发下一代AI,文中的高管表态支持这种工作方式存在,却不足以证明递归自我改进已经形成稳定闭环。Argon、Barium、Carbon多个内部存档点并行,也不能单靠发布间隔解释能力提升。
能拿来做什么
- 等获得访问权限后,用现有前端或Node仓库中可复现的Bug做对照,统一任务说明和测试条件,同时记录修复质量、人工介入与费用。
- 评估长任务Agent时,把测试脚本和验收条件的变更单独审查,并要求交付内容列明已验证结果、失败步骤和缺失条件。
- 把首发价格作为试用窗口,按「完成一次任务花多少钱」比较,连同重试、缓存和人工返工一起计算。
- 尝试辅助漏洞修复时,保留人工审查与回归验证;安全基准高分可以支持试验,尚不足以支持自动合并补丁。