AI 写完安卓代码,真机验证仍靠开发者
文章梳理 Android AI 编程工具的能力,并指出编译成功、测试通过并不能证明代码在设备上可靠运行。代理可能修改测试预期来迎合新行为,开发者仍需审查测试有效性并验证真机表现。
AI 深度解读
AI 能写出 Kotlin,也能修编译错误,但谁来证明它在手机上真的可靠?作者的判断是:Android 开发的瓶颈正在从生成代码转向验证代码。构建成功、测试全绿,只能证明它过了现有检查,不能替发布质量签字。
这篇文章值得读的地方,是把「AI 差一点就做对了」拆成了具体问题:进程被杀后草稿还在不在,发布构建会不会出错,AI 修改测试后绿灯还剩多少说服力。它讨论的是 Android,也提醒使用 AI 编程的人重新审视验收方式。
AI 能修代码,为什么验证反而更吃紧了
作者以凌晨 2:07 的 Crashlytics 告警开场:出错的 ViewModel 在 git blame 里算你写的,实际来自 agent;PR 宣称所有测试通过,原因却是 agent 把预期值改成了新行为。
作者明确说了,这是拼合出来的情境,不是亲历事故。它用来说明一种风险:当实现和验收标准都能被 AI 改动,测试全绿就需要额外解释。
按原文介绍,Android Studio 的 2026 年 5 月版本已经提供多步骤任务规划、自动修复构建错误、App Quality Insights 中的「Fix with AI」,以及把 LeakCanary 跟踪信息交给 agent 的选项。AI 已经能介入编码和排错两端。
Google 的 Android Bench 则用公开 Android 仓库中的真实问题评估模型,以测试判断修复是否成功。2026 年 3 月推出时,不同模型的任务解决率为 16%–72%。这个跨度说明模型能力存在明显差异,但原文没有列出模型名称、具体任务分布和评估配置。
验证压力还有两条旁证:Stack Overflow 2025 年调查中,66% 的开发者把「AI 方案接近正确,却没有完全正确」列为首要困扰;DORA 2025 报告发现,AI 采用与更高交付吞吐量相关,同时仍与较低交付稳定性相关。后者是相关性描述,不能直接推成「AI 导致不稳定」。
作者据此提出:改动越容易生成,团队越可能增加改动,最后卡住的是能验证多少。
手机上出错的条件,往往藏在 diff 外面
Agent 主要面对仓库,Android 应用却要接受设备运行环境的检验。进程死亡、OEM 电池管理策略、R8 发布构建、意外重组,以及低内存设备上的主线程工作,都可能让一份看起来合理的代码失效。
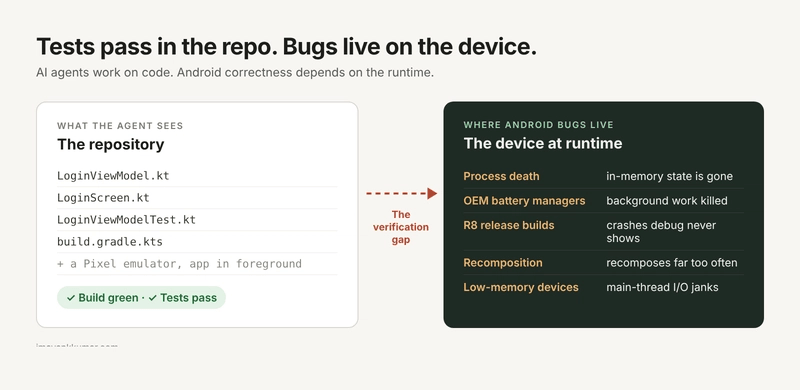
作者用草稿恢复解释这种落差。下面两个版本都能编译,也能通过简单单元测试,但面对进程死亡时表现不同:
// Loses the draft when Android kills the app in the background
class ComposeViewModel : ViewModel() {
    var draft by mutableStateOf("")
}

// Restores the draft after process death
class ComposeViewModel(private val state: SavedStateHandle) : ViewModel() {
    val draft = state.getStateFlow("draft", "")
    fun onDraftChange(text: String) { state["draft"] = text }
}
要看的是 state["draft"] = text:第二版把草稿写入 SavedStateHandle,第一版只保存在内存里。只验证输入后能否读出内容,两个版本都可能过关;检查进程死亡后的恢复,才触及这里真正的需求。至于恢复机制的适用条件,原文没有进一步展开。
这也解释了 Android Bench 的边界。用测试通过衡量任务完成,对基准评估是合理口径;把同一口径直接当作发布依据,就漏掉了测试没有覆盖的运行条件。
AI 同样能辅助调试。作者说,agent 可以很快给出三种崩溃解释,但开发者还得判断哪一种符合证据,以及修复是在处理原因,还是用 ?.let 把问题藏起来。速度解决不了这个判断题,理解生命周期、状态和运行机制的能力仍然要有人掌握。
当 agent 也成为用户,文档就成了接口的一部分
原文还提到 AppFunctions:这是 Android 16 及以上的实验性 API,允许应用暴露可供 agent 调用的函数。
这里有两个变化。函数的 KDoc 会成为 agent 阅读的描述,因此文档是否准确,会影响它如何选择和调用功能;参数则由 LLM 生成,需要像其他不可信输入一样校验。
对做过接口开发的人,这个要求并不陌生。入口换成 agent,并不会自动保证参数合法。文档负责表达用途和约束,代码仍然负责执行校验。
作者另有两个尚未得到回答的判断:简单应用可能逐渐主要由 agent 构建,深度 Android 能力会更集中地用于失败代价高的地方;初级工程师如果跳过大量基础代码练习,又该怎样形成系统认知?这些是作者提出的趋势与疑问,原文没有给出验证结果。
我的判断
我认同把注意力从「生成了多少代码」移到「证明了哪些行为」。草稿示例足够具体:问题不在语法,而在验收有没有包含状态恢复。
但「写代码已经不再是慢的部分」仍是经验之谈。作者没有提供团队改造前后的耗时对照,也没有展示 AI 调试的准确率,更没有证明所有 Android 项目都会遇到同样的瓶颈。
相比单纯增加提示词要求,把关键场景写进验收条件更容易检查。不过,修改测试本身也不等于作弊:需求变更时,预期值理应调整。审查时应追问的是,测试变化依据什么需求,是否让原本需要满足的行为消失了。
AI 给出修复候选,人仍需用证据决定是否接受。 这比要求开发者亲手写完所有代码,更接近原文值得保留的主张。
能拿来做什么
- 给 Android 的 AI 编程任务补上运行场景,例如草稿在进程死亡后恢复,并要求说明验证过程,避免只收到「测试已通过」。
- 审查 AI PR 时,把测试预期值的变化和实现一起读,确认修改是在反映需求,还是在迁就错误行为。
- 调试时让 agent 列出候选原因及所需证据,再根据日志和设备表现逐项排查,尤其审查通过空值判断掩盖异常的修复。
- 在需要深入掌握的生命周期、状态恢复等部分主动手写代码;若使用 AppFunctions,同时检查 KDoc 的准确性和参数校验。