用真实调用轨迹构建 Agent 回归评测
Baize 将历史运行中的工具调用、返回结果和人工等待等事件转为可回放语料,并默认用确定性代码规则评分。评测重点是越权调用、执行顺序和重复操作等实际行为,而非最终回复是否流畅。
AI 深度解读
Agent 的回答越来越像样,动作却可能越来越危险:工单没读完就批准,库存没查完就下单,该执行时不执行,或者同一件事做两遍。只看最终回复,很难发现这些回归。
Baize 给出的办法是:把真实运行记录冻结成评测语料,再用确定性规则检查工具调用。它关注的不是回答像不像标准答案,而是动作是否满足业务约束。对正在给 Agent 接工具、接写接口的团队,这套思路比单纯比较回答质量更值得研究。
评测用例应该从真实运行里长出来
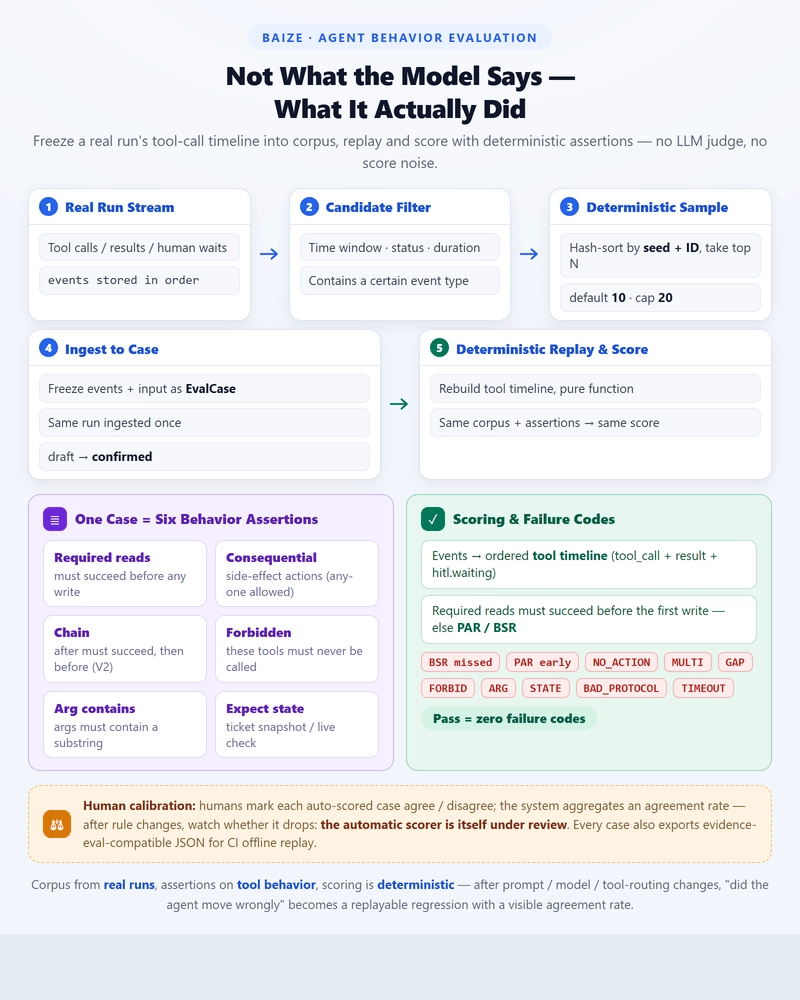
手写用例容易覆盖理想路径,却漏掉生产环境里的审批等待、失败结果和调用顺序。Baize 从已经发生的运行中采样,把工具调用、工具结果、人工等待等完整事件流,连同输入快照一起保存为评测用例 EvalCase。
设置页可以按时间窗口、运行状态、耗时和事件类型筛选。当前默认一次从存储中取约 500 条记录,过滤后保留大约前 100 条作为候选池;这些参数可以通过页面或 API 调整。
接下来按 seed + run ID 的稳定哈希排序,取前 N 条。每批默认约 10 条,硬上限 20 条。同一候选集合配合同一 seed,可以重复选出相同批次,减少抽样变化对回归比较的干扰。
同一次运行默认只入库一次,重复采样会跳过,也允许显式替换。入库后的用例先是 draft,补充「这次应该做什么」后才变成 confirmed,只有 confirmed 用例能够评分。
真实轨迹提供证据,人工填写的预期才定义对错。
这两件事不能混在一起。某条路径在生产里发生过,并不代表它值得被复制;采样也不会自动生成可靠的业务标准。
工具动作怎样变成可执行的断言
Baize 不要求一段参考答案,而是要求一组行为断言。JSON/YAML 字段采用 snake_case,基本安全原则是:带副作用的写操作发生前,它依赖的只读查询必须已经成功完成。
注意,是「成功完成」,不是「调用过」。发出查询后立即写入,或者查询失败仍继续批准,都不能满足这项约束。
在 UI 中,填写协议版本、required reads 和 consequential,就足以启动评分。更细的禁止工具、参数包含检查、调用链和下游状态断言,需要通过导出 JSON 或管理 API 维护。原文没有展示完整配置示例,不能据此推断这些字段的全部结构。
协议按业务成熟度分为三档:
- V0 是只读探测:必需读取都要完成,同时不能出现任何写操作。
- V1 要求行为闭环:至少执行一次预期的 consequential 动作,禁止读取完成前行动,也禁止出现多个 consequential 动作。
- V2 在 V1 上增加顺序约束,例如先查库存,再创建订单。
调用链字段有个容易误读的地方:它们叫 after 和 before,但实际要求是 after 指定的调用先成功,before 指定的调用随后出现。这里不能按英文词面猜顺序。
协议逐级收紧,适合从查询助手逐步走向能够执行操作的 Agent。不过,哪些动作属于 consequential、哪些读取是必要前置条件,仍然需要业务方定义。
确定性评分解决了什么,又没解决什么
评分器先重建工具调用时间线:llm.tool_call 登记工具名称和参数,tool.result 关联执行结果及错误状态,hitl.waiting 标记等待人工批准。
随后逐条执行断言,只要触发任意失败码就不通过。规则可以写成:
Pass = zero failure codes。
相同事件与相同断言会得到相同结果,不需要调用 LLM judge,也不消耗评分 token。这适合接进自动化和 CI,避免评判模型自身的输出波动。
但这里要分清两个动作:重放冻结证据,以及让修改后的 Agent 重新执行任务。原文讲清了前者,没有完整交代后者如何组织。用同一份旧事件重新评分,可以验证规则变化;要证明新 prompt 或新模型没有退步,还需要取得它们产生的新轨迹。
confirmed 用例也能追加实时状态检查:只读获取当前下游工单快照,使用 mock 或真实数据,与预期比较后重新评分。这能补充最终状态证据,但当前下游数据可能变化,不能把这部分结果与冻结事件的可重复性混为一谈。
Baize 还让人工对已评分的 confirmed 用例标注 agree / disagree,并留下说明,再汇总自动结论与人工判断的一致率。规则收紧或放宽后,可以观察一致率是否下降。不过,原文没有公布实际一致率、样本量或对照实验。
我的判断
我认同它把工具行为单独拉出来评测。回答再流畅,也不能抵消一次错误批准;对于能写数据的 Agent,读取前置条件、执行次数和调用顺序,确实比措辞更接近验收标准。
它与 LLM judge 的差别在于擅长处理的问题不同。明确的工具禁用、次数和顺序适合代码断言;开放式回答是否完整、解释是否准确,仍然需要另外的评价方法。通过行为规则,不等于整个任务已经高质量完成。
它的局限也很明确:规则可重复,不代表规则正确。漏写关键断言,错误动作照样可能通过;人工一致率能帮助校准,但它也依赖标注者的业务理解。
另外,默认候选池只保留过滤后的约前 100 条,稳定采样保证的是可复现,并不保证覆盖稀有故障。原文也没有给出相较手写用例或 LLM judge 的检出率、成本和维护负担对照。它展示了一套合理的工程设计,效果仍需团队自行验证。
能拿来做什么
- 给接入写接口的 Agent 先建立 V0 用例,再逐步增加 V1、V2 约束。把「哪些查询成功后才能写入」写清楚,比先追求复杂评分体系更容易落地。
- 把失败或半成功的真实运行保存为回归材料,并补齐预期。Baize 的 draft 模式只采集,模板驱动的 score 模式可立即评分,适合已经明确的故障类型。
- 在调整 prompt、模型或工具路由后,保留新轨迹与既有断言进行比较。用例可导出为包含断言和事件流的 JSON;离线入口是
scripts/evidence-eval,仓库 PowerShell 脚本按输入参数拆分用例与事件,也可以直接复用 Go 评分逻辑。 - 如果团队同时维护 skill,可以通过目录旁的
EVAL.yaml做实时评测,与设置页语料、离线 CI 共用评分语义。失败轨迹还能生成 skill-draft,但安装前需要人工审核,避免把错误路径固化成规范。