安卓编程榜更新:模型效果与成本分化
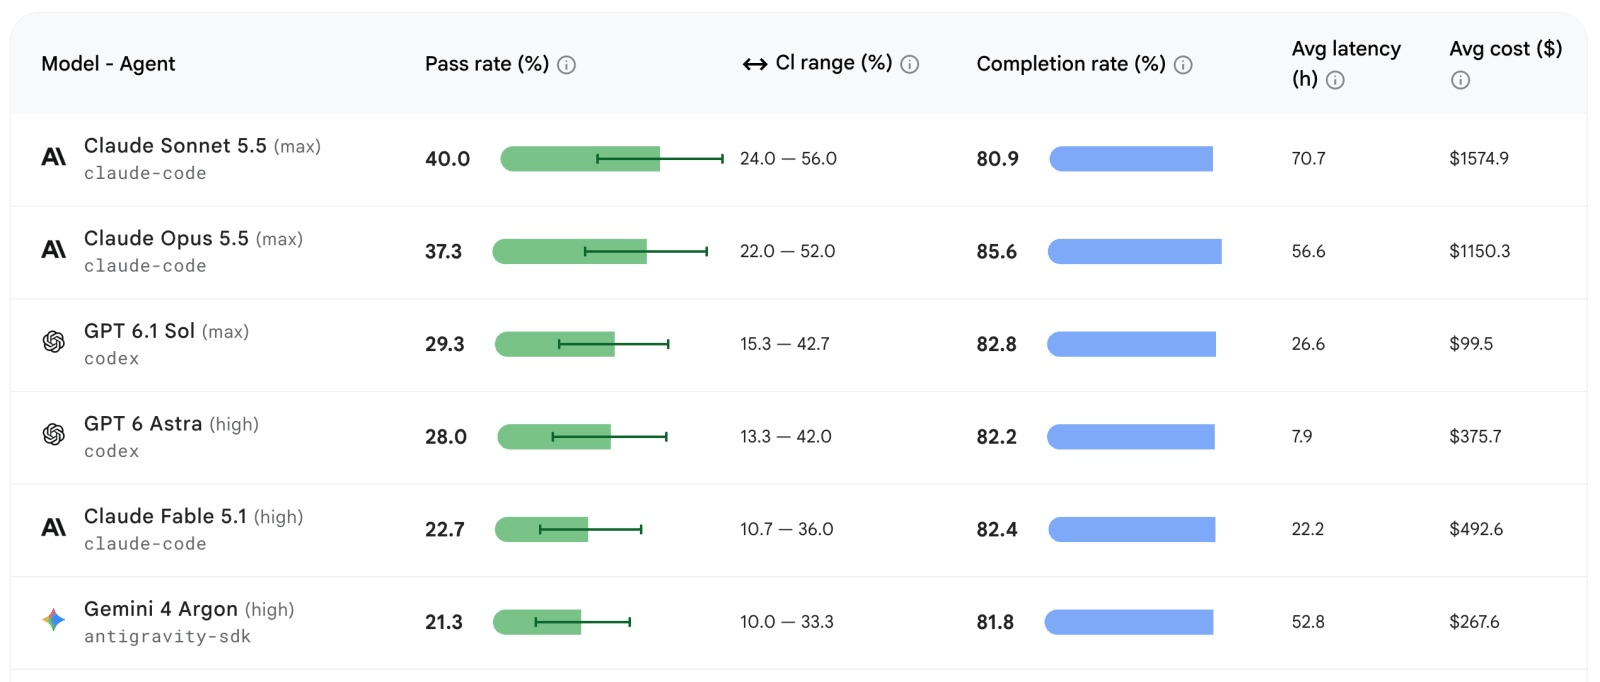
谷歌 Android Bench 新增模型推理等级和测试结果,Claude Sonnet 5.5 以 40% 通过率居首,Gemini 4 Argon 为 21.3%。GPT-6.1 Sol 通过率为 29.3%,榜单所列调用成本为 99.50 美元,低于榜首模型的 1,574.90 美元。
AI 深度解读
谷歌更新了 Android Bench,榜首却是 Claude Sonnet 5.5,自家的 Gemini 4 Argon 只排第五。比名次更有用的是:几个模型的完成率都在八成左右,通过率和调用成本却拉开了距离。
对程序员来说,这份榜单提供了一个选模型的切口:除了看任务能否做完,还要看结果能否过关、为此花多少钱。不过,它评估的是安卓编程辅助能力,不能直接当作前端、Node 或通用编程能力排名。
都能完成八成任务,为什么成绩差这么多
Android Bench 于今年年初推出,面向安卓开发场景,考量安卓开发特有的使用方式和最佳实践。谷歌持续加入新模型,也把平均调用成本纳入指标,帮助开发者同时考虑效果与费用。
10 月 26 日的更新补充了 GPT-6 Sol、GPT-6.1 Sol、Claude Sonnet 5、Claude Sonnet 5.5 和 Gemini 4 Argon 的测试结果,还新增了各模型采用的推理等级标注。
报道给出的三组数据很直观:
| 模型 | 通过率 | 完成率 | 报道所列调用成本 |
|---|---|---|---|
| Claude Sonnet 5.5 | 40% | 80.9% | 1,574.90 美元 |
| GPT-6.1 Sol | 29.3% | 82.8% | 99.50 美元 |
| Gemini 4 Argon | 21.3% | 81.8% | 267.70 美元 |
完成率接近,不代表交付质量接近。
GPT-6.1 Sol 的完成率在这三款模型中最高,但通过率仍低于 Claude Sonnet 5.5。Gemini 4 Argon 的完成率也超过八成,通过率却只有 21.3%。
这提示我们,模型把任务执行到结束,和结果满足评测要求,是两回事。不过,报道没有给出两项指标的具体定义、评分规则和失败案例,不能进一步断言差距究竟来自代码正确性、安卓规范,还是其他检查项。
榜首与低成本模型,该怎么选
Claude Sonnet 5.5 以 40% 的通过率位居第一,10 月初加入榜单的 Claude Opus 5.5 排在第二。如果优先考虑这套测试下的通过表现,Claude Sonnet 5.5 有明确优势。
GPT-6.1 Sol 的看点则在成本:通过率为 29.3%,调用成本为 99.50 美元,报道折合约 664.8 元人民币;Claude Sonnet 5.5 的调用成本为 1,574.90 美元,约 10,522 元人民币。
但不能据此给日常 AI 编程直接报价。报道将平均调用成本列为基准指标,却没有交代成本的计算口径、任务规模,以及失败重试如何计费。这里的金额适合在榜单范围内比较,不能理解成修一次 Bug 或完成一个需求的价格。
Gemini 4 Argon 排名第五,低于 Claude Fable 5.1。它的通过率为 21.3%,平均调用成本为 267.70 美元,约 1,789 元人民币。就报道列出的数据看,它相对 GPT-6.1 Sol 同时处于通过率更低、成本更高的位置。
原文还提到,有内部消息称 Gemini 4 Argon「难以处理部分编程任务」,谷歌仍认可其能力。这属于消息转述,没有具体任务和复现材料,不能拿来解释榜单成绩的成因。
我的判断
这份榜单最有价值的地方,是把通过率、完成率、成本和推理等级放到同一个选择框架里。只比较模型名称,容易忽略推理配置和预算对结果的影响。
但它支持的结论有边界。Gemini 4 Argon 在这套安卓测试里落后,并不能证明它在所有编程任务中都落后;Claude Sonnet 5.5 拿到第一,也不代表它一定最适合你的项目。榜首通过率只有 40%,同样提醒读者不要把排名理解为可靠交付的保证。
对于以前端和全栈为主的读者,我更愿意把它当作选型线索。相比直接照榜单购买,用自己项目里的代表性任务做小规模对照,更能回答实际问题。原文没有提供前端、Node 或团队落地的对照数据,不能替它补上这些结论。
能拿来做什么
- 如果你在做安卓开发,可以把 Claude Sonnet 5.5 和 GPT-6.1 Sol 纳入候选,分别验证较高通过率和较低成本是否适合自己的任务。
- 日常使用 AI 编程时,分别记录任务是否结束、代码是否通过检查,避免把模型输出完成当作验收完成。
- 比较模型时,把推理等级和调用费用一起记下来;报道已经新增推理等级标注,但没有展开各模型的具体配置。
- 如果主要写前端或 Node,先用项目中已有的修复、测试和构建任务做对照,再决定是否采用榜单推荐的候选模型。