少样本分类何时够用:混合语言实测
作者对比少样本分类器与Jev的银行意图路由表现:干净英语中,每类5个标注样本即可匹敌Jev。面对印英、泰米尔英混合表达及干扰题,即使增加到每类35个英语样本,差距仍未消除,并提供结果仓库和路由实现。
AI 深度解读
每类只标 5 条样本,一个普通分类器就能追平专用模型 Jev。但把银行客服消息从标准英语改成印度用户常用的混合语言,结论就变了:增加到每类 35 条英语样本,也补不上差距。
这组实验值得看的地方,是它把「便宜模型够不够用」拆成了几个具体条件:用户怎么打字、类别描述是否准确、模型会不会自信地答错。对准备做客服分流、工单分类的程序员,这比单看一张准确率榜更有用。
5 条样本能追平 Jev,前提是输入接近训练数据
作者用 Banking77 做银行客服意图分类:给一条消息,从 77 个类别里选一个,例如 card_arrival、declined_card_payment、request_refund。
参赛方法包括描述向量的余弦相似度、样本向量投票、基于向量的逻辑回归分类器、同时读取消息与描述的 cross-encoder,以及 TypeSafe 的 Jev。向量方法先把文字转成数值表示,再判断距离或类别;Jev 则根据全部候选描述做选择。
在 1,001 条标准英语测试消息上,Jev 准确率为 83.3%,余弦相似度为 73.2%,cross-encoder 为 71.1%。逻辑回归分类器每类用 5 条样本,共 385 条,就达到 84.2%。领先的 0.9 个百分点落在 Jev 的误差范围内,作者将其视为打平。向量投票需要每类 10 条才能超过 Jev;每类 35 条时,两种方法最高达到约 91.4%。
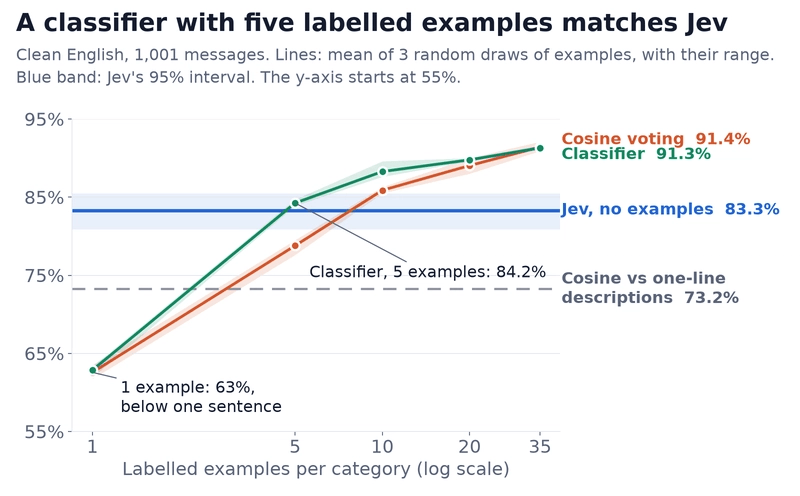
样本也不是有就行。每类只有 1 条时,准确率约 63%,反而低于一句类别描述的 73%。单条消息可能只覆盖某种表达,描述却能概括类别范围。
把同样的 5 条样本塞进 Jev 的描述,在另一组 249 条消息上能达到 90.4%,但 token 用量变成 3.7 倍,优势也只是临界水平。
Jev 的接口适合这类有限选项任务:返回选项及其概率,不需要解析生成文本。下面是原文调用方式,每次会发送全部 77 条描述,约 2,400 个输入 token:
from typesafe_sdk import Choice, RetryPolicy, TypeSafeClient

client = TypeSafeClient(api_key="public", base_url="https://opencode.ai/zen",  # 免费路由
                        retry=RetryPolicy(max_retries=0))  # 重试会消耗每日配额
question = Choice(
    instructions="Which banking support intent does the customer_message express? "
                 "Pick the single best match.",
    criteria=descriptions,  # {"card_arrival": "The customer ordered a card and it has not arrived yet, ...", ...} x 77
)
response = client.system_one({"customer_message": text}, {"intent": question}, model="jev-1.13-free")
answer = response.choices["intent"]
answer.choice, answer.confidence  # ("request_refund", 0.98)
要看清 criteria=descriptions:候选描述本身就是模型判断的依据,写错会直接改变结果。
用户换一种打字方式,英语成绩就不够用了
作者让 Claude agents 将覆盖全部 77 类的 144 条消息,分别改写成 Hinglish 和 Tanglish。前者混用印地语与英语,后者混用泰米尔语与英语,都使用拉丁字母,并保留 card、top up、PIN 等英文词。
这些改写经过其他 agents 检查,但还没有母语使用者审核。
在这 144 条原始英语消息上,Jev 为 86.1%,每类训练 35 条英语样本的分类器为 93.1%。换成 Hinglish,两者变成 85.4% 和 56.2%;换成 Tanglish,则是 77.1% 和 52.8%。向量投票稍好,分别达到 63.7% 和 64.6%。
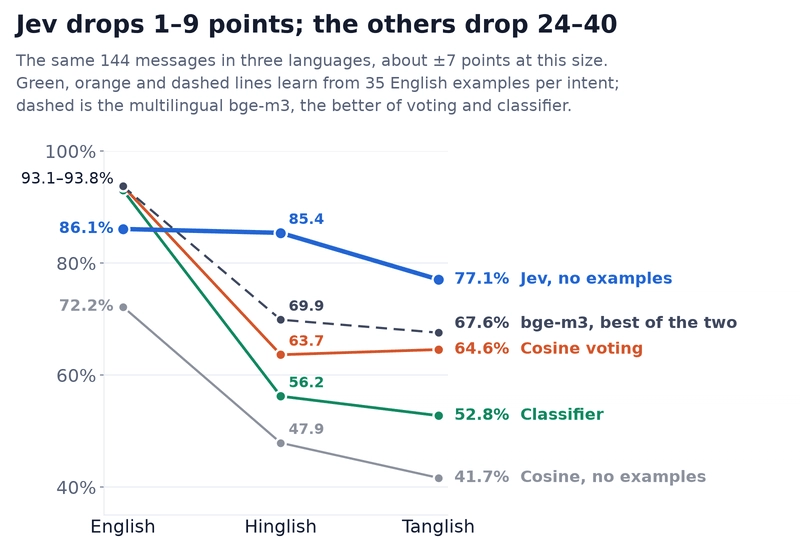
这是否只是因为 bge-small-en 只支持英语?作者又换成体量约为它 17 倍的多语言模型 bge-m3。投票与分类器中较好的结果,在两种混合语言上分别为 69.9% 和 67.6%。确实有改善,但 Hinglish 上仍落后于 Jev;Tanglish 的样本较少,差距只能算临界。
另一个测试是 105 条专门诱导关键词匹配出错的消息,由 3 个 agents 编写,另 3 个盲标。Jev 全部答对,cross-encoder 达到 79.0%;英语向量分类器约为 64%,从每类 5 条加到 35 条也没有起色,换 bge-m3 后达到 76.5%。
这里的 100% 只能解释为 Jev 通过了这组特定考题。作者也承认,105 条全部通过标注检查,可能说明审核偏宽松。
增加同一种语言的样本,不能保证覆盖另一种语言和另一类表达陷阱。
描述写错和自信答错,都能绕过你的保护措施
最有启发性的失败发生在 get_physical_card 类别。作者按标签名写了「用户询问如何获取实体卡」,结果 Jev 在该类 13 条测试消息上全部答错。
实际数据却主要在问 PIN:106 条训练消息中,105 条提到了 PIN。Jev 将这 13 条都分到 change_pin,其中 9 条置信度至少为 0.95。
作者没有修正描述后重跑。依赖描述的 cosine、cross-encoder、Jev 成绩都带着这个问题;投票和分类器不读取描述。这个缺陷影响了对比的公平性,也说明高置信度无法修复错误的类别定义。
作者随后尝试分流:先让便宜分类器回答,置信度低于 0.7 再调用 Jev。下面是完整的核心逻辑:
from sentence_transformers import SentenceTransformer
from sklearn.linear_model import LogisticRegression

model = SentenceTransformer("BAAI/bge-small-en-v1.5")
embed = lambda texts: model.encode(texts, normalize_embeddings=True)
clf = LogisticRegression(C=100, max_iter=5000).fit(embed(examples), labels)  # 每类35条;C=1会欠拟合

def route(text: str) -> str:
    probs = clf.predict_proba(embed([text]))[0]
    if probs.max() >= 0.7:
        return clf.classes_[probs.argmax()]
    answer = client.system_one({"customer_message": text}, {"intent": question},
                               model="jev-1.13-free").choices["intent"]
    return answer.choice  # client和question来自前面的Jev调用
关键是 probs.max() >= 0.7,这个阈值必须用自己的数据验证。
在每类 35 条样本的实验中,英语分流节省了 86% 的 Jev 调用;两种混合语言只能省约四分之一。准确率通常与更好的单一方法相差约 1 个百分点以内,Tanglish 上甚至更高。
但陷阱题暴露了漏洞:分类器对错误的 Google Pay 答案仍有 86% 至 91% 的把握,直接通过了 0.7 门槛。
作者没有精调阈值,0.7 只是固定 0.9 / 0.7 / 0.5 网格的中间值。建议是在几百条留出消息上扫描 0.5 到 0.9。投票与分类器一致才放行的替代规则,在标准英语上更好,到了 Hinglish 却失效。
我的判断
我认可分层处理的方向,但「5 条够用」只适用于这次标准英语分类实验,不能拿来承诺一般业务效果。
成本差异很实际:作者笔记本 CPU 上分类器耗时 7 ms,bge-m3 为 43 ms;Jev 从印度测得的往返中位耗时为 0.76 s。按每百万输入 token 0.042 美元的标价估算,每千条消息约 0.10 美元。这些是单一环境下的测量与估算。
证据还有边界:混合语言和陷阱测试只有 105 至 144 条,误差约为 ±6 至 ±9 个百分点;Banking77 是公开数据,Jev 可能在训练时见过;cross-encoder 只测了一个面向搜索的模型。最关键的对照,即用混合语言样本训练分类器,作者尚未做。
免费第三方路由也不能直接当作生产保障。它每天约限 250 次调用,10 月下旬曾中断约 4 天;作者检查时 TypeSafe 自身暂停注册。路由虽对照过官方公布答案,却没有证明与官方服务完全相同。
因此,相比全量调用 Jev,我会优先验证分流;相比直接换更大的多语言模型,我会先补真实输入样本。这是基于实验缺口的取舍,原文没有提供后者的效果对照。
能拿来做什么
- 做客服或工单分类时,先读每类至少 5 条真实消息,再写描述,并检查标签名是否准确表达数据里的含义。
- 给评测集加入用户实际会输入的混合语言、缩写和否定句,单独统计各组准确率,避免标准英语成绩掩盖问题。
- 在服务端采用分类器优先的分流前,扫描 0.5 到 0.9 的阈值,同时检查高置信度错误。原文还建议 Jev 低于 0.95 时转人工,但这同样需要本地验证。
- 复现报告需要 Python 3.12 或更新版本,安装会引入 PyTorch。原文的
.venv/bin/python -m app.main triage && cat results/TRIAGE.md可利用已提交答案重建报告,无需密钥或 API 调用;实际接入时只安装官方typesafe-sdk。