AI 辅助 Oracle 变更的验证与回滚流程
文章提出先发现、预览和审批,再限界执行与独立验证的数据库变更流程,并介绍不可见索引、迁移 SQL 预览及在线重定义的用途。强调在线操作不代表可安全回滚,须针对具体变更和数据库版本验证。
AI 深度解读
让 AI 给 Oracle 加索引,难点往往不是生成那条 SQL,而是确认它有没有漏看现有索引、会不会影响其他查询,以及出问题后怎样撤回。作者给出的结论很明确:安全要靠发现、预览、审批、受控执行和独立验证组成的流程,不能靠模型表现得有多自信。
这是 Oracle AI Database Skills 系列的第 7 篇,共 8 篇。它适合正在让 AI 参与数据库维护的开发者阅读,但提供的材料在最后的演示开头就截断了,没有完整执行结果,也没有性能对照数据。应把它看作变更流程建议,而非经过实测证明的优化方案。
AI 提议加索引,先让它交代查询条件
作者把流程概括为 route → act → trust:先通过 Oracle Database Skills 做结构发现、澄清意图,再通过受限的 MCP 执行,最后用查询计划、日志和审计核验结果。
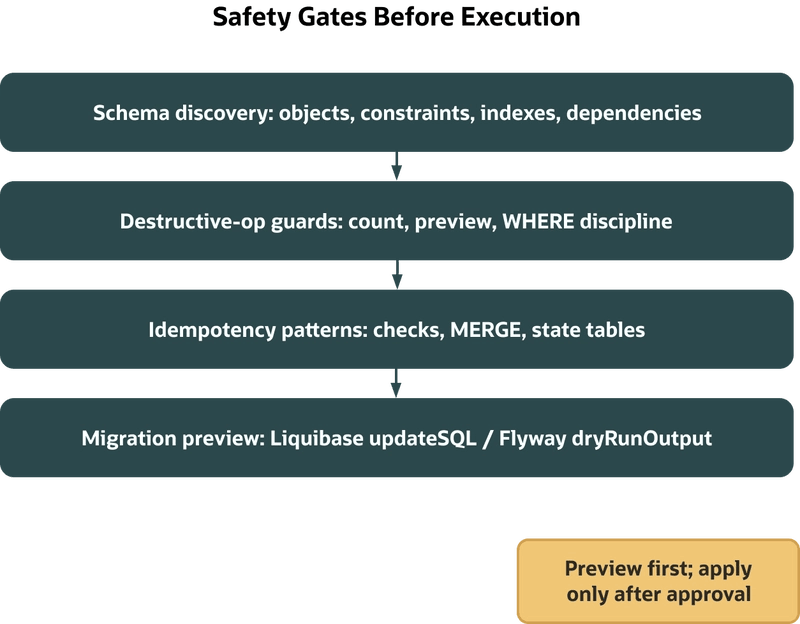
第一步不是写 DDL,而是盘点对象、约束、索引和依赖。同一 schema 内用 USER_*,跨 schema 则根据权限使用 ALL_* 或 DBA_*。
下面这段查询解决的是「建议的新索引是否已经被现有索引覆盖」:
SELECT index_name, column_name, column_position
FROM   user_ind_columns
WHERE  table_name = 'DOCUMENTS'
ORDER  BY index_name, column_position;
重点是 column_position:检查联合索引时,不能只看列名是否出现,还要看排列顺序。作者另用 user_indexes 检查 visibility 和 status。
接着,模型必须明确目标 WHERE 条件、访问哪些行、预期执行计划怎样变化。「给 source 和 published 加索引会更快」还不够具体。原文用 source = 'kb' 与 published >= DATE '2025-01-01' 演示先执行 SELECT COUNT(*),确认更新或删除涉及的范围。
Oracle 不会强制 UPDATE、DELETE 携带 WHERE,这个约束需要工具和代码审查落实;有了 WHERE,也仍需核对影响行数。
重复执行则要分两层处理。数据操作可以用 MERGE,例如按 key 把 config 中的 max_connections 设置为 '100'。迁移工具通过状态表记录执行历史:Liquibase 使用 DATABASECHANGELOG、DATABASECHANGELOGLOCK,Flyway 使用 flyway_schema_history。
迁移有执行记录,不等于其中每条 SQL 都天然适合重复执行。
作者强调的是同时设计数据操作、迁移状态和重试行为,而不是把幂等性全部交给工具。
预览 SQL 和限制权限,要一起落地
预览解决「准备执行什么」,权限解决「最多能执行什么」。两者缺一,审批都容易流于形式。
Liquibase 的命令是 liquibase --changelog-file=changelog.xml updateSQL,根据当前数据库状态输出待执行 SQL。Flyway 对应 flyway -locations=filesystem:sql -dryRunOutput=preview.sql migrate,把待执行脚本写入 preview.sql;原文明确,dryRunOutput 需要 Teams/Enterprise,Community 不提供。
这与系列前文的 SHOWSQL 是同一套思路:审核实际 SQL,再批准执行,不能只批准模型对变更的文字描述。
执行通道采用 SQLcl MCP Server,MCP 即 Model Context Protocol。它通过 stdio 暴露连接、断开、列出已保存连接和运行 SQL 等工具。作者引用 SQLcl 25.3 文档,指出 Level 4 最严格,但默认级别和具体限制要查安装版本的文档。
建议使用预先保存的最小权限连接,并配置 restrict levels 限制临时凭据。Autonomous AI Database 的托管 MCP 则取决于服务层级和 Release Update(RU),不能假定每个环境都有。
这里还需要分清:工具列表小,不代表数据库权限小。只要允许运行 SQL,连接账号能做什么仍然关键。MCP 提供受控入口,数据库授权决定实际边界。
在线变更能降低影响,但回退要另行证明
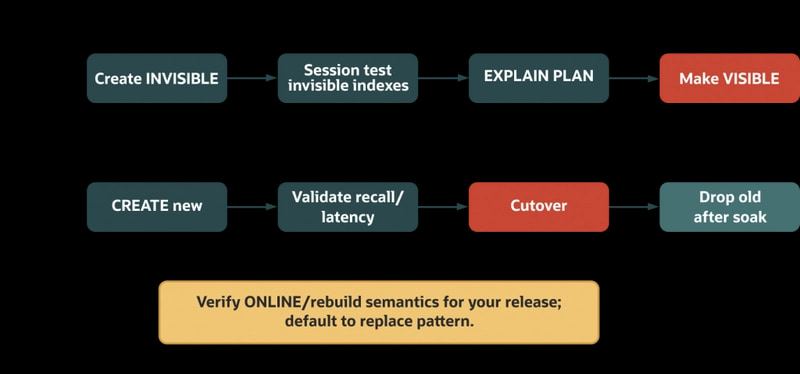
原文大多数示例面向 Oracle Database 19c 及以后版本。最容易复用的是 invisible index:先创建不可见索引,仅在测试会话允许优化器使用它,确认效果后再对所有查询开放。
下面这条命令把验证范围限定在当前会话:
ALTER SESSION SET optimizer_use_invisible_indexes = TRUE;
要盯住 ALTER SESSION。OPTIMIZER_USE_INVISIBLE_INDEXES 也能在系统级设置,但作者这里选择会话级测试。之后通过 EXPLAIN PLAN、DBMS_XPLAN,最好再加实际执行计时,判断目标查询是否获益,再决定设为可见或撤回。
原文还区分了几类在线机制:
- 索引维护使用受支持的
ALTER INDEX ... REBUILD ONLINE。作者提醒,不能据此推断目标版本和索引类型一定支持CREATE INDEX ONLINE。 - 写入中的表结构调整使用
DBMS_REDEFINITION,流程包括CAN_REDEF_TABLE、START_REDEF_TABLE、COPY_TABLE_DEPENDENTS、SYNC_INTERIM_TABLE、FINISH_REDEF_TABLE。主键策略用CONS_USE_PK,其他情况考虑CONS_USE_ROWID,均需核对资格限制。 - 视图、包等代码演进使用 Edition-Based Redefinition(EBR)。表自身不分 edition,通过 editioning view 等隔离访问,在
ORA$BASE的子 editionapp_v2测试,再调整客户端连接、服务或应用路由。 - Oracle Database 26ai 的向量索引讨论覆盖 HNSW、IVF 和
DISTANCE COSINE。作者建议新建、验证、保留观察期后删除旧索引,用代表性查询或DBMS_VECTOR同时检查召回率和延迟。
LOB、物化视图日志、行移动以及 editioning 的交互都有版本限制。上述内容应当作为方案入口,不能直接当生产脚本执行。
在线操作解决可用性问题,回退还要单独验证。
索引设为不可见、删除新索引、切回旧 edition,覆盖的是不同故障。结构已经切换、并发数据已经变化时,不能假定它们都有统一的回退窗口。
我的判断
我认同作者把审批点放在实际 SQL 上,也认同先局部验证再扩大影响。它比直接让 AI 执行 DDL 多了几个明确关卡,而且这些关卡同样适用于人工编写的迁移。
但文章没有给出变更前后的耗时、吞吐、锁等待或向量检索对照结果。「更安全」主要是流程上的经验判断,不能进一步推成性能提升承诺。提供的原文最后停在 SELECT in,完整演示也无法核验。
另一个需要保留意见的地方是 EBR 示例:文中把含 CASE 计算投影的定义写成 CREATE OR REPLACE EDITIONING VIEW,却没有解释这种写法的适用限制。它不能作为已经验证可执行的模板,使用前应核对目标版本对 editioning view 的定义要求。
证据链方面,作者建议用 DBMS_APPLICATION_INFO.SET_MODULE('mcp-agent','index-additive-change') 标记操作,通过 V$SESSION.MODULE、.ACTION、DBTOOLS$MCP_LOG 追踪;启用 Unified Auditing 后,再查 UNIFIED_AUDIT_TRAIL。这些记录能回答谁执行了什么,却不能单独证明业务结果正确。
与已有的人工迁移审批相比,这套方案的价值是把同样的控制落实到 AI 执行入口。Liquibase 按 tag、changeSet、date 回退,以及 Flyway Teams/Enterprise 的 undo,也都依赖事先编写适用的反向脚本。可追溯和可回退,需要分别交付。
能拿来做什么
- 让 AI 优化 Oracle 查询时,先要求它提交现有索引及列顺序、目标
WHERE、预期计划变化和验证方法,再接受建索引建议。 - 在 Node 服务的数据库迁移流程中,把 Liquibase
updateSQL或适用版本的 FlywaydryRunOutput作为审核产物,同时保存正向脚本与回退脚本。 - 给 AI 编程助手连接 Oracle 时,使用预存的最小权限账号和受限 MCP 配置,并把会话标记、迁移记录和执行日志关联到同一次变更。
- 做索引调整时,先安排不可见索引的会话测试;做表重定义或 EBR 切换时,单独写明回退条件、旧对象保留时间,以及并发写入如何处理。