用真实命中率核算提示缓存收益
文章将 Bedrock 工作负载实测的99.8%缓存命中率,与按 Anthropic 官方 API 定价推导的盈亏门槛比较。作者强调缓存写入有溢价,且 Bedrock 独立计费,不能直接套用官方 API 价格计算账单。
AI 深度解读
Prompt caching 开了就能省钱吗?作者拿一个 Bedrock 生产工作负载实测的 99.8% 命中率,对照缓存读写价格算了一遍:按 Anthropic 第一方 API 的 Sonnet 4.6 定价,命中率超过约 21.7% 才开始省钱,低于它反而更贵。
这篇值得读的地方,是把「缓存有优惠」拆成了可计算的条件。不过,21.7% 来自第一方 API 价格,99.8% 来自 Bedrock 实测,两者不能直接拼成 Bedrock 账单的节省证明。
为什么缓存命中之前,要先多付一笔钱
Prompt caching 复用的是已经处理过的提示词内容,例如多次请求共有的 system prompt 前缀。它的收费包含两部分:第一次写入缓存更贵,后续读缓存便宜。能不能省钱,取决于便宜的读取能否摊平写入溢价。
作者在 2026-11-10 核对的 Anthropic 第一方 API 价格是:Sonnet 4.6 普通输入每百万 token 收费 $3,5 分钟缓存写入收费 $3.75,缓存读取收费 $0.30。对应普通输入价格,写入倍率是 1.25x,读取倍率是 0.10x。
这套交易有一个时间限制:TTL,也就是缓存有效期。按原文描述,Bedrock 多数模型,包括 Sonnet 4.6,缓存窗口是距离上次写入或读取的 5 分钟。匹配请求在窗口内到达,才能享受读取价格;窗口过去,下一次请求又要付写入费用。
所以,重复使用同一段 prompt 还不够,重复请求之间隔了多久也很关键。
判断缓存是否划算,要同时看复用内容、请求间隔和读写价格。
这里还得划清价格来源。作者没有拿到 Sonnet 4.6 在 Bedrock 上的准确缓存倍率:Bedrock 定价页的表格由 JavaScript 渲染,抓取未能获取;所用工具中的 AWS Price List API 模型目录又只更新到 Claude 3 Sonnet。原文因此要求 Bedrock 用户去控制台核对自己账户的费率。
21.7% 是怎么算出来的
作者把问题限定为:对同一个可缓存前缀发起 N 次请求,命中率 h 表示其中作为缓存读取计费的比例,w 是写入倍率,r 是读取倍率。
下面的公式计算平均成本相对普通输入价格的比例:
cost ratio = (1 - h) * w + h * r
要看清 (1 - h) * w 这一项:在这个简化模型里,未命中的部分都按缓存写入计费,并没有回到普通输入价格。只盯着读取价格有多低,会漏掉这部分成本。
令成本比例等于 1,就得到收支平衡时的最低命中率:
h* = (w - 1) / (w - r)
关键是分母中的 w - r,读写价差会影响需要多少次命中才能摊平溢价。代入 Sonnet 4.6 第一方 API 的倍率:
(1.25 - 1) / (1.25 - 0.10) = 0.25 / 1.15 ≈ 21.7%
低于约 21.7%,缓存比普通输入贵;高于它,平均成本开始下降。完全没有命中时,成本比例就是 1.25,也就是多花 25%。
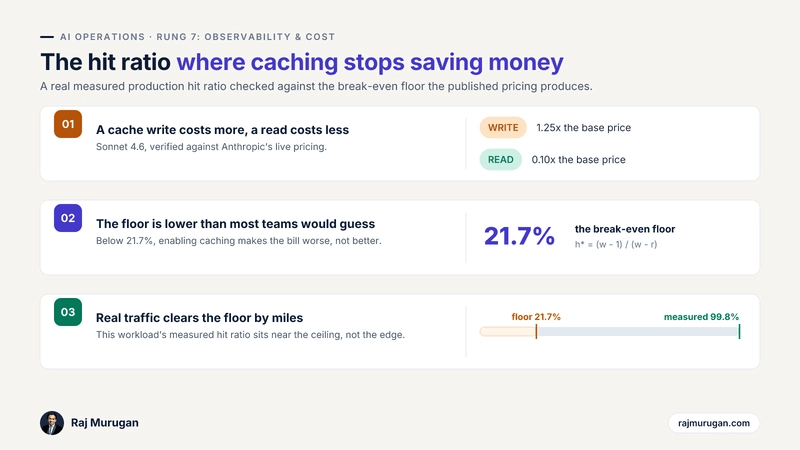
这项推导纠正了一个容易被高命中率案例带偏的预期:缓存不需要接近 100% 命中才有价值。只要实际价格符合这里的倍率,适度复用就可能覆盖写入成本。
不过,这里算的是可缓存输入部分。输出 token、不能缓存的输入以及其他费用都没有纳入,不能把这个成本比例直接理解成整次 AI 调用的账单比例。
哪些请求模式容易省钱,哪些容易踩线
作者引用的 99.8% 命中率,来自此前文章中的同一个 Bedrock 生产工作负载。它采用的是一轮用户交互内连续发起多次调用的 agent 模式,请求集中发生,共享前缀的重复使用大多落在 5 分钟内。
在这样的调用节奏下,缓存容易反复命中。它离按第一方 API 价格算出的 21.7% 门槛很远,所以作者认为这类工作负载通常值得开启缓存。
反例是每小时运行一次的定时任务。即使每次使用完全相同的 system prompt,60 分钟的间隔也跨不过 5 分钟 TTL。按原文模型,每次都是新写入,命中率为 0%;若写入倍率为 1.25x,就会比普通输入贵 25%。
低流量聊天应用也可能遇到类似问题。用户隔很久才发下一条消息,前缀虽然相同,缓存却已经失效。因此,日请求量相同的两个应用,也可能因为请求分布不同,得到完全不同的缓存收益。
作者建议按顺序做两项检查:先取目标模型的实际读写倍率,算出门槛;再检查同一前缀的重复请求间隔是否落在 TTL 内。经常超过 5 分钟时,应查看每次调用返回的 usage 数据,测量真实命中情况。
原文提到前文有一个「两个关键字参数」的开启方法,但没有给出参数名或代码;usage 的具体字段也没有在这里展开。单靠这篇文章,还不能完成 SDK 接入。
我的判断
我认可它把缓存优化变成了一个可以验算的问题。相比「有重复 prompt 就开启」的经验规则,先算门槛、再看调用节奏,能解释为什么同样的配置在不同应用里结果不同。
但它的证据边界也很明确:99.8% 是一个工作负载的实测结果,21.7% 是指定价格下的数学推导。
这篇没有新增一个低命中率生产实验,也没有给出开启前后的完整 Bedrock 账单对照。每小时定时任务会增加成本,是根据价格和 TTL 推出的结果;「绝大多数工作负载都适合开启」则仍是作者的经验判断,缺少覆盖不同流量形态的对照数据。
公式还有一个容易忽略的前提:同一个可缓存前缀,使用稳定的计费倍率。实际系统如果缓存多个长度不同、复用频率不同的前缀,就应该分别计算。一个短前缀频繁命中、一个长前缀持续重写,混在一起看请求命中率,可能掩盖真正花钱的部分。
延长 TTL 也是另一种选择。原文说部分 Bedrock 模型支持付费的更长 TTL,但没有给出具体模型、时长和价格。它可能增加命中机会,也可能提高写入成本,需要重新代入公式,不能沿用 21.7%。
对国内开发者来说,最能迁移的是计算方法。使用不同平台、模型或转发服务时,应以实际账单规则为准,不能直接照搬这组美元价格。
能拿来做什么
- 给 Node 服务或 AI 编程工具接入缓存前,先记录同一前缀的请求时间间隔。重点看连续交互是否落在 5 分钟内,别只统计一天总共调用多少次。
- 为目标模型核对普通输入、缓存写入和缓存读取价格,换算出 w、r,再用
h* = (w - 1) / (w - r)计算门槛。Bedrock 用户应采用自己账户对应的实际费率。 - 开启缓存后,通过每次响应的 usage 数据验证读取和写入情况,并按前缀分别观察。不要用某个生产案例的 99.8% 命中率替代自己的测量。
- 对每小时运行的摘要、巡检等任务,先核对 TTL 是否覆盖调用间隔;对一轮内多次调用的 agent,再优先验证共享前缀的缓存收益。