多个编程助手会话共享 MCP 服务进程
开源工具 mcp-stdio-mux 针对多个会话重复启动本地 MCP 服务的问题,让不同应用和配置共享服务进程。其配置工具支持识别多种编程助手,修改前备份文件,并提供恢复命令。
AI 深度解读
同时开着 Claude Code、Codex 和 Cursor,内存开销不只来自编辑器。按作者描述,每个会话都会启动配置里的本地 MCP server,多个应用、多个 profile 再把进程数量放大。他的 16 GB Mac 一度出现超过 7 GB 的 swap。
作者为此做了 MIT 开源工具 mcp-stdio-mux:让符合条件的会话共享服务进程。它的价值在于减少重复启动,但共享也会扩大故障影响范围。比节省多少内存更值得看的是,它如何划分共享边界,以及发布前查出的隔离问题。
哪些 MCP server 可以合并,哪些必须分开
作者一次 dry run 在六个应用的 15 份配置文件中找到 49 条 server 配置,去重后只有 17 种。重复项包括 GitHub、Postman、Cloudflare、Google Drive、Google search 等 npx 包,也有 uvx mcp-server-fetch、连接托管服务的 mcp-remote、uv run 项目,以及 serena、tilth 这类二进制程序。
工具能发现 Claude Code、Claude Desktop、Codex、Gemini CLI、Cursor、Windsurf 和 OpenCode 的配置,包括各个 profile。它将本地启动命令包装成 mcp-stdio-mux run ... -- <your original command>,原命令仍可读;修改前逐文件备份,mcp-stdio-mux undo 可以恢复原始字节。它还会给 Claude Code 和 Codex 安装一个小 skill,方便后续让 agent 接入新增服务。
能共享的前提,是这些会话确实可以使用同一份服务状态。
两个会话只有在 profile、完整命令、配置中的凭证都匹配时才共享;服务依赖项目目录时,目录也必须匹配。凭证通过哈希比较,不写入日志。跨应用的 work profile 可以共享,default profile 与客户 profile 默认分开。
还有三类特殊处理:
- Playwright 涉及浏览器状态,每个会话保留自己的进程。
uv run、node dist/index.js这类相对路径命令,按项目目录分配进程。- codebase-memory-mcp 已有自己的 daemon,工具保持原样。
它还会根据服务公布的工具名,识别浏览器标签页、登录等客户端状态需求,并为这类服务保留独立进程。远程 HTTP server 和项目里的 .mcp.json 不在修改范围内。
每个会话约 1.2 MB,是怎么做到的
原理是增加一个共享守护进程(daemon),统一连接后端 server;各个 agent 会话仍保留自己的本地子进程。
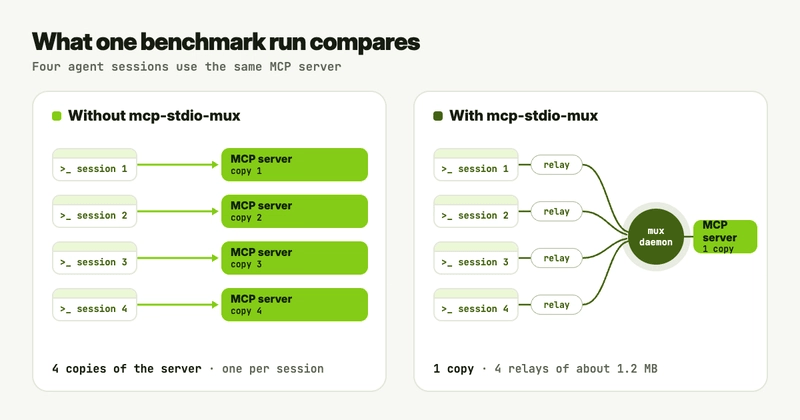
第一版每个会话留一个 Python 中继进程,消耗约 18 MB。对于轻量服务,中继甚至比被替代的服务还贵。
新版只短暂运行启动进程:找到或启动 daemon,通过 Unix socket 的 SCM_RIGHTS 传递 stdin、stdout 对应的文件描述符,再将自身替换成以 server 命名的 /bin/cat。应用仍有一个可以监控和停止的子进程,约占 1.2 MB,实际通信由 daemon 直接读取会话管道。
作者在 2026 年 11 月 10 日,用 16 GB Apple silicon Mac 测量四个会话,统计它们引起的全部进程。指标是活动监视器「内存」列对应的 phys_footprint,每种 server 跑三次。
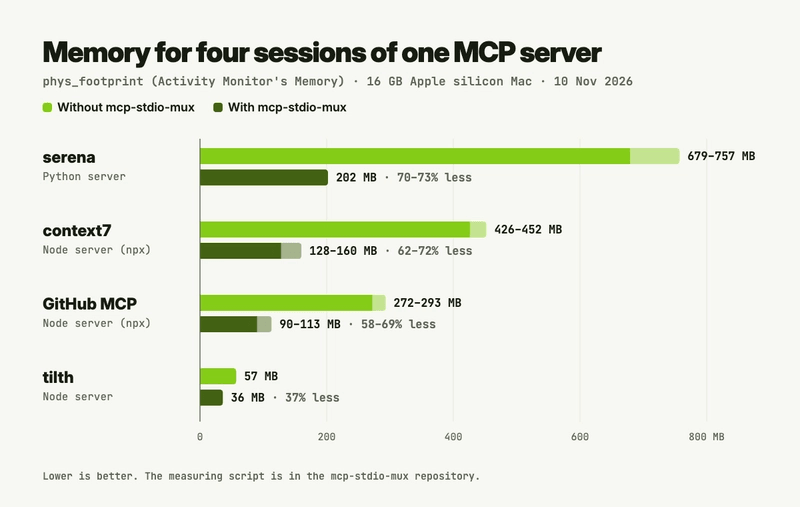
结果分别是:serena 从 679–757 MB 降到 202 MB,context7 从 426–452 MB 降到 128–160 MB,GitHub MCP 从 272–293 MB 降到 90–113 MB,tilth 从 57 MB 降到 36 MB。
npx 服务每个会话会带起 npm exec 和 node 两个进程,四个会话就是八个;共享后只留一对。这能解释收益来源,也解释了为什么轻服务节省得少:共享层本身也有成本。
共享进程之后,一个慢会话会不会拖住所有人
会,而且作者的早期实现确实出过问题。
发布前,他让一个看不到原开发推理过程的独立 AI agent 审查代码。审查发现 15 个问题,并复现了所有严重问题。其中,一个会话在工具调用中途关闭后,迟到的响应会被发给其他所有会话;超过 16 MB 的响应会冻结全部会话;某个会话停止读取,也会阻塞其他会话。
第一种问题从 9 月就在作者自己的环境中存在。工具「一直能用」,并不能证明隔离正确。
作者称,发布版已修复所有严重问题,每项修复都有先失败的测试;测试集共 91 项,在 macOS 和 Linux 上运行。原文没有展开具体修复机制,不能据此推断所有异常路径都已覆盖。
下面这组命令分别用于预览改动、应用配置和检查共享状态:
uvx mcp-stdio-mux setup --dry-run   # 查看计划,不做修改
uvx mcp-stdio-mux setup             # 确认一次后应用
mcp-stdio-mux status                # 查看共享情况及其开销
先看第一行的输出,确认哪些服务会被调整,再决定是否执行第二行。
我的判断
我认可它针对的问题:多个常驻 agent 会话重复启动同一批服务,确实存在可压缩的进程开销。作者也给出了测量口径、重复次数和具体结果,比只贴一张内存下降截图更有参考价值。
但这些数字只说明作者机器上的四会话实验。原文没有给出调用延迟、并发吞吐、长时间稳定性,以及和手动停用闲置服务、按需加载服务的对照数据,也没有展示整机 swap 从超过 7 GB 降到多少。不能把单项服务的内存节省直接当成整机收益。
更需要打问号的是按工具名识别有状态服务。这是一种实用策略,但原文没说明遇到自定义工具名或未识别的会话状态时如何处理。profile 和凭证相同,也不自动保证业务状态适合共享。
它更适合已经确认存在大量重复服务的工作流,收益要用自己的配置测。
能拿来做什么
- 如果你经常同时开多个 AI 编程会话,可以先运行
uvx mcp-stdio-mux setup --dry-run,核对重复服务、profile 和凭证边界,判断是否有实际节省空间。 - 如果你的 Node MCP server 用
node dist/index.js启动,应确认它归属的项目目录;涉及登录态或浏览器状态的服务,还要单独核对隔离方式。 - 接入后用
mcp-stdio-mux status查看开销,并比较相同会话数量下的内存与调用体验;收益不足时,可以用mcp-stdio-mux undo恢复配置。 - 如果你也在写多客户端共享服务,可以把「调用中途断开」「响应超过 16 MB」「客户端停止读取」加入验证范围,这三个案例比只测正常调用更有价值。