研究:编程代理框架换装未必提高通过率
一项受控研究发现,更换Claude Code、OpenCode等代理框架带来的通过率变化,与同一配置重复运行的波动相近。单任务成本却可能相差三倍,主要受每一步重复发送的系统提示词影响。
AI 深度解读
给同一个模型换一套更复杂的编程 Agent 框架,能多修几个 bug?The Decoder 转述的一项研究给出的答案是:未必能稳定多修,但账单可能涨到三倍。多出来的工具、系统提示词和上下文管理,没有自动变成更高的任务通过率。
这项研究值得看,不是因为它证明了简单工具永远更好,而是它把一个常被忽略的问题摆上台面:排行榜里多出的几分,到底来自框架改进,还是同一套配置再跑一次就会出现的波动?
换框架的收益,可能还没超过重跑的波动
编程 Agent 通常由模型和 harness 共同组成。这里的 harness,可以理解为模型在代码仓库里的工作环境:系统提示词、工具调用、历史记录管理,以及出错后如何继续执行。
山东大学的 Liu 和 Han 比较了三套按发布状态使用的 harness:Claude Code、OpenCode 和 mini-SWE-agent。前两者有专门的文件与搜索工具、较长的系统提示词和自动历史压缩;mini-SWE-agent 只提供 Bash 工具,不做上下文管理。
参与交叉测试的模型包括 Qwen3.6、Qwen3.8、Deepseek-V4-Flash、GLM-5.3-Flash 和 HY4-Preview。Claude Opus 5 仅在 Claude Code 中运行,作为参考。任务来自 SWE-bench Verified,包含最难的 45 道任务和另外 447 道任务组成的测试池;部分配置重复运行,用来估计随机波动。
在 447 道任务的测试池里,对参与该组测试的两个模型,Claude Code 和 mini-SWE-agent 的通过率相差不到 2 个百分点,并在 5 个百分点的等效界限内被判为统计等效。
困难任务也没有拉开稳定差距。不同 harness 每个模型相差 2 至 5 道,而同一配置重跑,结果就能变化最多 3 道。
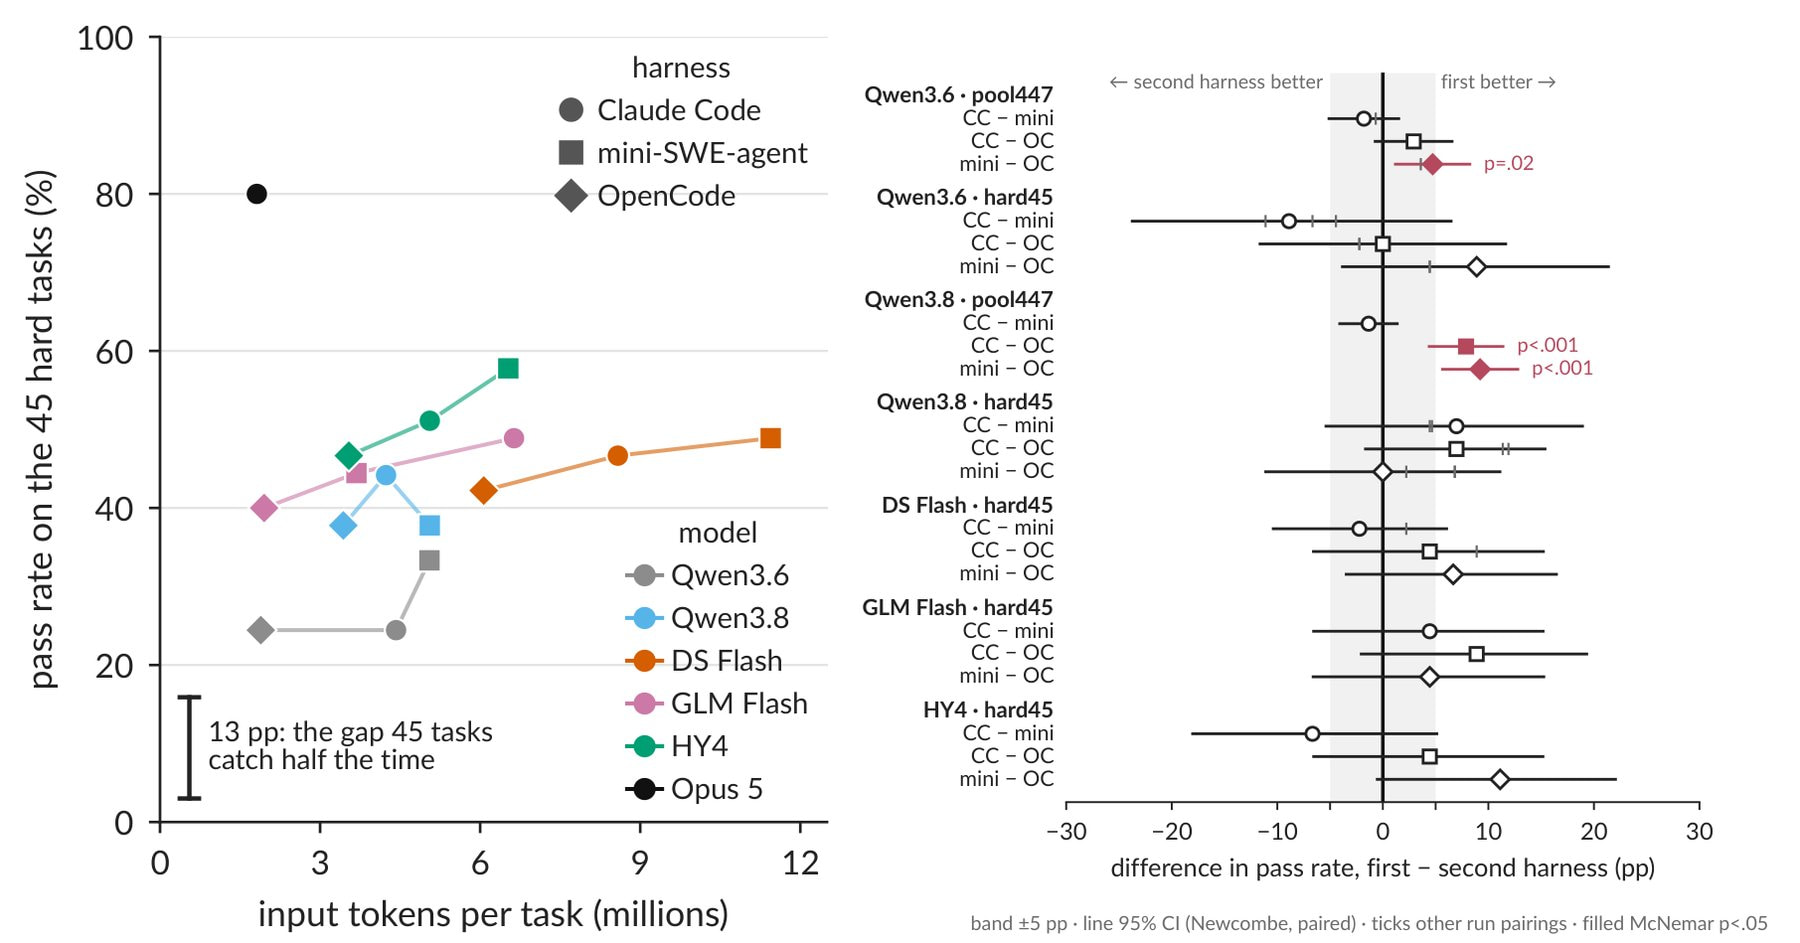
研究还比较了任务结果的翻转比例,也就是某道题从成功变失败,或从失败变成功的比例:
- 同一 harness 重跑,翻转比例的中位数为 13%。
- 更换 harness,翻转比例的中位数同样为 13%。
- 更换模型后,这个数字上升到 22%。
在这组实验里,换 harness 带来的结果变化,与同一配置重跑处于相近水平。
这也解释了为什么单次跑分容易误导。原文称,SWE-bench Verified 上,同一配置重跑就可能相差最多 6 个百分点。智谱宣传的领先 Claude Code 2.4 个百分点,落在这一波动范围内。
样本量也限制了结论:只有 45 道任务时,即便真实差距达到 13 个百分点,实验也大约只有一半机会检出;扩到 447 道任务,约 5 个百分点的差距才可以可靠检出。小幅领先需要更多证据。
复杂框架贵在哪里,为什么简单框架也未必最省
三套 harness 每次工具调用返回的文本量相近,成本差距主要来自系统提示词和工具描述。这些内容会随每一步请求重复进入输入上下文:
- Claude Code 约为 16,600 tokens。
- OpenCode 约为 7,000 tokens。
- mini-SWE-agent 不到 1,000 tokens。
根据研究者的逆向分析,Claude Code 还会把模型的推理输出保留在对话历史中。首次调用之后,三套 harness 的上下文增长速度相近,但起点已经不同。
可以把它理解为一笔每轮都要携带的固定开销。起点越高、执行步数越多,累计输入就越大。
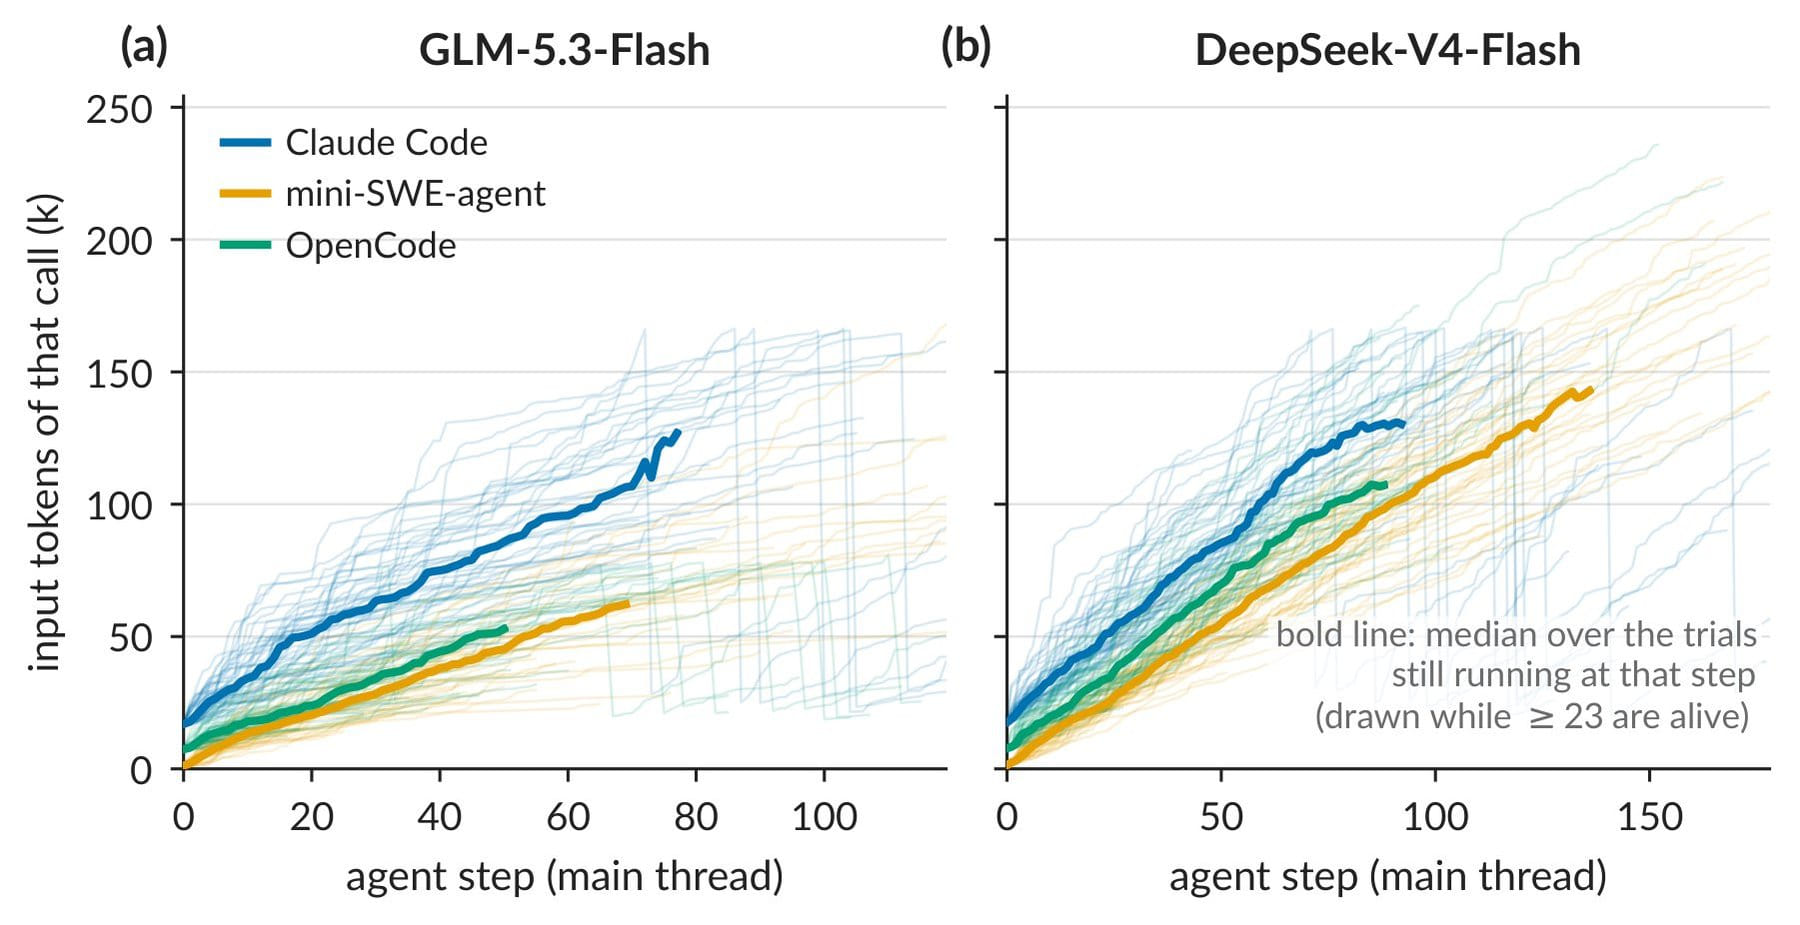
但不能据此推出 mini-SWE-agent 一定最便宜。总成本还取决于模型需要走多少步。
使用 GLM-5.3-Flash 时,Claude Code 的成本接近 mini-SWE-agent 的两倍;原文给出的另一组单次试验费用是 Claude Code 1.81 元、OpenCode 0.56 元。使用 DeepSeek-V4-Flash 时,mini-SWE-agent 多走了足够多的步骤,最终费用与 Claude Code 大致持平。
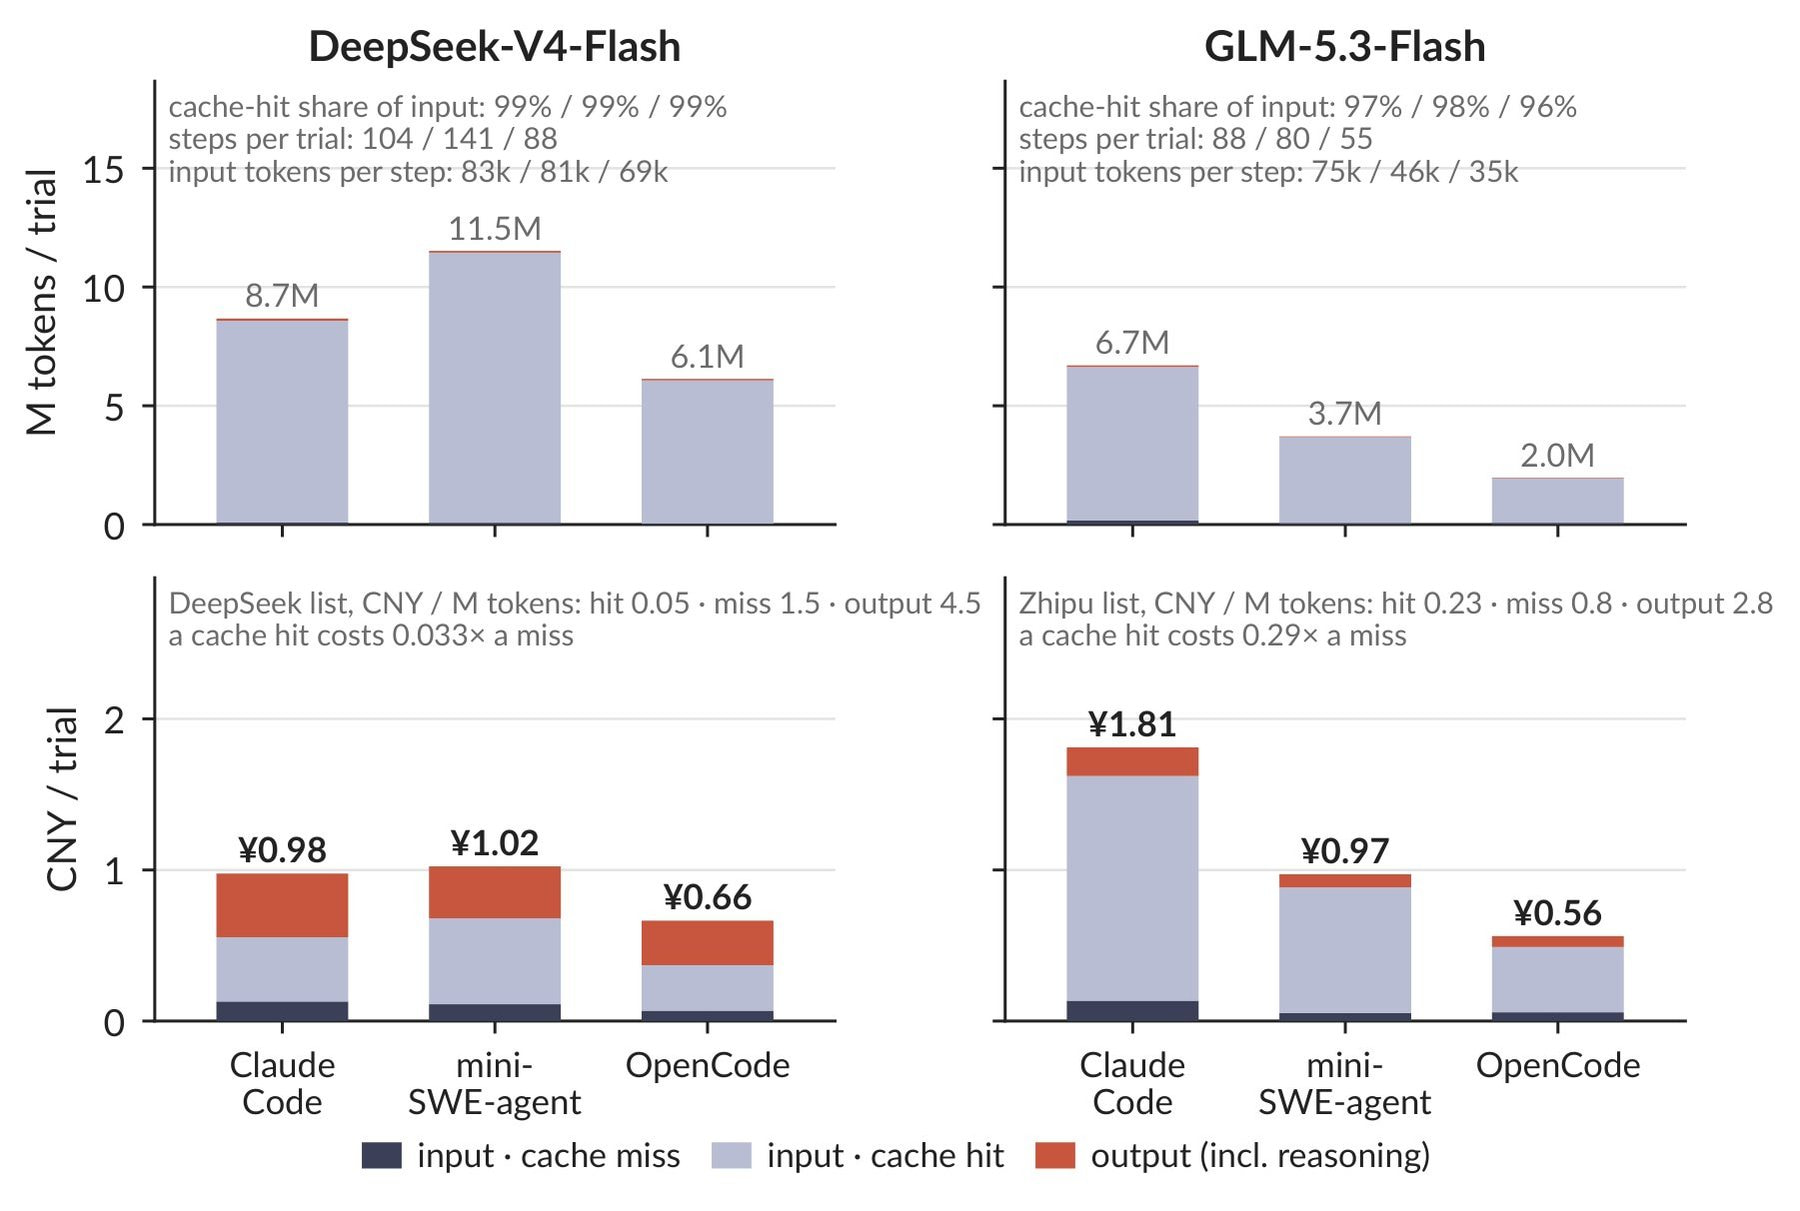
因此,短提示词只是省钱的一个条件。工具是否让模型少绕路,同样影响账单。缓存 Token 的优惠能缩小差距,但在该研究的计算中没有改变成本排序。
框架仍然会影响失败方式,OpenCode 就是例子
原文标题很容易让人读成「框架没有用」,实验却给出了一个明确例外:OpenCode 在大测试池中落后另外两者最多 9 个百分点,而且差距具有统计显著性。
约一半差距可以追溯到输出上限。当模型在单步推理中耗尽输出额度时,Claude Code 会提示它继续,OpenCode 则允许这一步结束,任务往往随之失败。
研究者给 OpenCode 补上类似的继续提示,没有改善整体结果。不过,同一道任务在重试时很少再次触发相同溢出,所以这次补丁实验也没能干净地验证原因。剩余差距没有明确解释,只观察到模型在 OpenCode 中更早停止工作。对于本地运行的模型,OpenCode 的时间限制也明显更紧,这是未受控变量。
其他失败同样与运行环境有关。mini-SWE-agent 缺少上下文管理,会撞上上下文窗口,但多发生在另外两套框架也做不成的任务上;OpenCode 的搜索工具首次使用时会尝试下载二进制文件,在离线环境中可能失败。
离线限制有具体原因:早期允许联网时,Deepseek 和 Qwen 模型的尝试中,有 71% 直接从 GitHub 获取正确补丁;Claude 模型几乎没有这样做。研究者丢弃了这些结果,再统一断网。这不能证明厂商用测试数据训练过模型,只能说明联网会干扰「独立解决任务」的测量。
推理模式也是尚未解释清楚的变量。关闭 thinking 后,Qwen3.6 在 mini-SWE-agent 中下降 11 个百分点,在 Claude Code 和 OpenCode 中的变化却仍处于噪声范围;HY4-Preview 在 Claude Code 中也下降 11 个百分点。原文承认,测试组合不够多,还无法解释这种依赖。
我的判断
我认同这项研究对跑分方法的提醒:判断框架是否有效,应该先知道同一配置重跑会波动多少。 没有这个基线,领先几个百分点很容易被包装成产品能力。
但把结论扩大为「复杂 harness 没价值」,证据还不够。研究主要依赖 SWE-bench Verified,Terminal-Bench 2.1 只有小规模交叉检查;Claude Opus 5 没有跨框架比较。它也没有回答日常交互、人工介入成本,以及长期仓库任务中的表现。
此外,断网暴露出的工具依赖、不同时间限制,都影响了比较条件。结果反映的是这些发布版本在该实验环境中的整体表现,不能把差距全部归因于提示词长短。
原文还提到,Claude Opus 5 在移除 Claude Code 的部分工具后成绩相同;一年前的版本能以不到一半的成本完成相近数量的任务,当时默认没有开启 Extended Thinking。这提示我们检查默认配置,但无法据此单独证明 thinking 不值得开。
与不断增加工具、规则和推理预算相比,先建立简洁基线更容易判断新增能力是否划算。不过,具体该删什么、保留什么,仍需任务数据。这项研究没有给出适用于所有团队的最优配方。
能拿来做什么
- 给前端或 Node 仓库选择编程 Agent 时,固定模型、任务、联网条件和预算,至少给关键配置安排重跑,同时记录通过率与费用。样本较小时,把结果作为筛选线索,别急着宣布某个框架领先。
- 排查 AI 编程账单时,先看系统提示词、工具定义、执行步数和缓存计费。删掉一段固定提示可能降低每轮成本,也可能让模型绕更多路,需要一起观察。
- 分析失败任务时,把补丁错误、输出截断、上下文溢出、时间限制和工具启动失败分开记录。换模型之前,先确认失败是否发生在模型真正开始解决问题之前。
- 做仓库修复评测时,明确是否允许联网获取已有补丁,并固定 thinking 设置。需要衡量独立修复能力时,应避免把检索到现成答案算作模型自行解题。