浏览器内运行开放模型,辅助查重GitHub议题
Already Filed通过浏览器内运行的开放模型分析仓库开放议题及最近30天关闭的议题,列出疑似重复项及相似的历史记录。提交者也能粘贴待发内容预先查重,最终判断由用户完成。
AI 深度解读
给 GitHub issue 留一句「Duplicate of #1234」很容易,难的是记得 #1234 在哪里。Already Filed 把这件事做成了浏览器里的检索工具:用开放权重模型读取 issue,找出可能重复的讨论,由维护者决定是否合并。
这篇实践最有价值的结论,是模型之外的三项调整:缩小搜索范围、选对任务提示、混合语义与关键词。在 zed 的历史重复记录上,正确原帖进入前三的比例达到 65%,关键词搜索则是 38%。但这个数字距离「自动判断重复」还有一段路。
为什么先缩小搜索范围,比换模型更管用
在 zed-industries/zed,维护者留下了 1,653 条重复关联。被指向的原帖,中位数早了 1,343 个 issue,时间相隔 64 天。工具要解决的,就是这种超出个人记忆范围的查找。
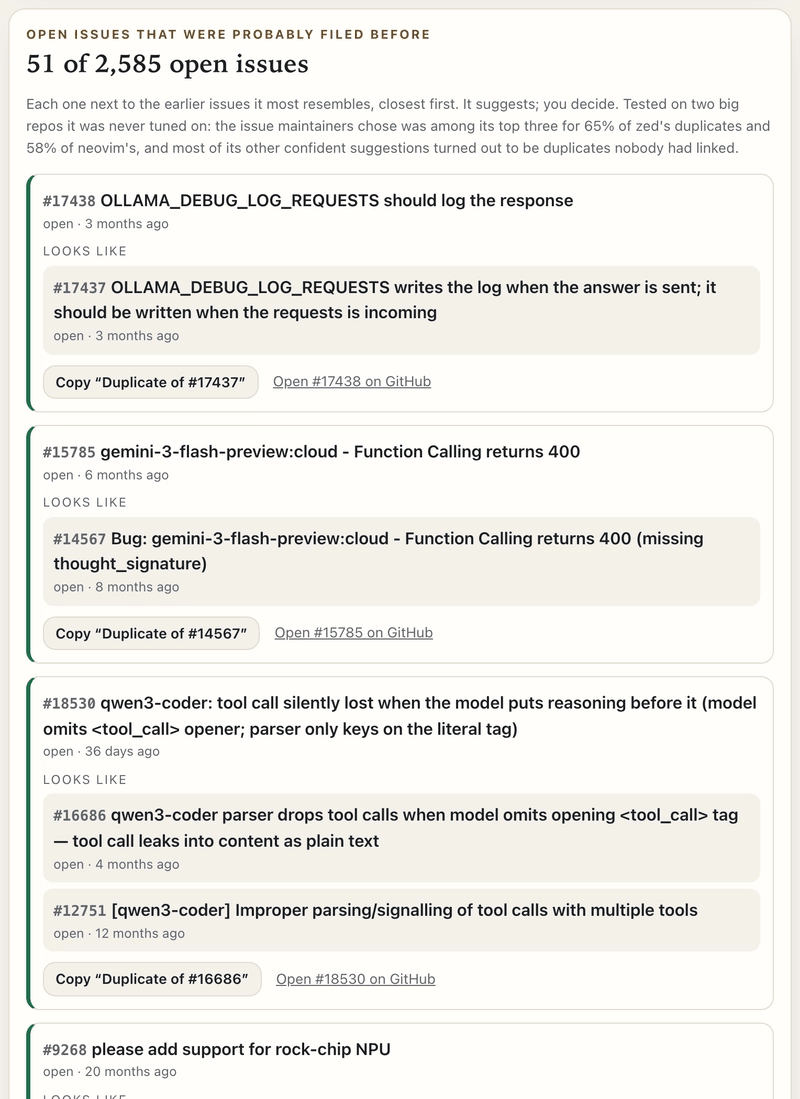
Already Filed 支持两种用法:扫描仓库,列出疑似重复的开放 issue;或者粘贴准备提交的内容,先查有没有人报过。它展示候选原帖,提供复制「Duplicate of #…」的按钮,最终决定交给人。
作者最初用 EmbeddingGemma 为每个 issue 生成向量,再与此前所有 issue 比较。在调参仓库 ollama 上,正确原帖进入前三的比例只有 42%;关键词算法 BM25 已经有 38%。为这点差距下载 197 MB 模型,吸引力有限。
第一步改进来自维护者的实际行为:重复关联中,91% 的原帖当时仍然开放,另外 7% 在此前 30 天内关闭。因此,搜索范围改为「仍开放,或最近 30 天关闭」,前三命中率便从 42% 升到 49%。
先找对候选集合,再讨论模型有多聪明。
第二步是任务提示。EmbeddingGemma 支持通过提示说明向量的用途。在标题实验里,sentence similarity 的前三命中率为 41%,clustering 为 40%,不加提示为 47%,document prompt 为 48%,检索提示 task: search result | query: 则达到 51%。将检索提示用于完整 issue 后,整体结果从 49% 升至 61%。
第三步是清洗和混合打分。大量 issue 共享「OS」「GPU」「Ollama version」等模板,容易把无关问题拉近。工具删除出现在超过 2% issue 中的重复行,同时去掉链接、图片,每段日志只保留前四行。
随后分别生成正文向量和标题向量,再加入关键词信号,按 0.7 × body + 0.3 × title + 0.1 × keywords 打分。原文对正文通道的描述包含标题与正文;标题还会单独编码一次。最终前三命中率达到 65%,第一名命中率从 29% 升到 46%。
关键词没有被淘汰。精确报错和模型名,仍然需要它兜住。
65% 是怎么测出来的,哪些地方不能直接外推
作者利用 GitHub 的 MarkedAsDuplicateEvent 获取维护者建立的重复关联,通过 GraphQL API 下载三个仓库的历史数据,再按 issue 提交顺序回放。
每次只允许检索当时已经存在的内容,检查维护者后来指向的原帖是否进入推荐列表。所有选择都在 ollama 上完成,然后冻结,再测试 zed 和 neovim。这比在同一个仓库上反复调参、同时报成绩更有说服力。
zed 的 1,653 条重复记录中,方案的前三命中率为 65%,BM25 为 38%;在只有一方命中的记录里,EmbeddingGemma 方案命中 518 条,关键词搜索命中 64 条。neovim 的 379 条记录上,两者分别为 58% 和 39%。
不过,neovim 上单独使用 EmbeddingGemma 达到 59%,完整混合方案反而只有 58%。固定权重并非处处占优。
更小的 bge-small 也很接近:模型体积约为六分之一,使用相同搜索范围和混合方法后,在 ollama、zed 上差距不超过 2 个百分点,在 neovim 上落后 2 至 4 个百分点。这支持的是整套检索方法的价值,不能只归功于 EmbeddingGemma。
还有一个容易混淆的指标:前三命中率衡量的是「已知重复问题能不能找到原帖」,不是页面上每条推荐的可信度。
作者在 ollama 上设置「likely」阈值,让从未建立重复关联的 issue 中有 5% 仍会触发推荐。迁移到 zed 后,它为 12% 的已知重复问题给出了正确原帖,同时在其他 issue 上触发 4%。
作者抽查了其中 30 条表面上的误报,判断 21 条确属同一问题,9 条相关,没有完全无关的。但这是作者判断,缺少维护者复核;正式指标仍把这 30 条全部算错。
浏览器本地运行,省下了什么,又付出了什么
Already Filed 是静态文件,没有构建步骤和后端,采用 MIT 许可。EmbeddingGemma 为 300M 参数模型,通过 transformers.js 以 4-bit 运行,优先使用 WebGPU,没有 GPU 时回退到 WASM。WASM 版本保留未量化的 token 表,因为对应运行时缺少量化查表支持。
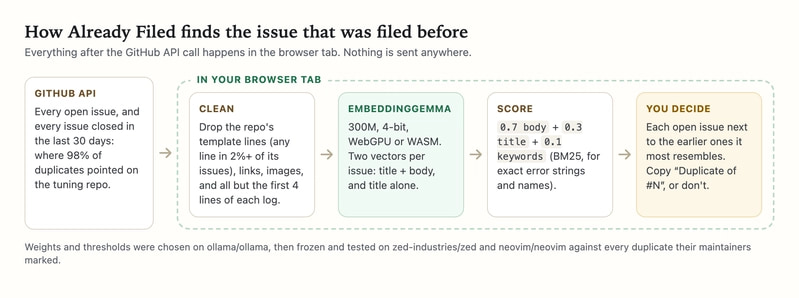
实时读取使用 GitHub REST API,并跟随 API 返回的分页链接。作者曾在大仓库中按页码翻页,超过第 10 页后遇到 422。这是值得保留的工程细节:分页规则不能靠小仓库测试推断。
ollama 快照包含 2,711 条开放及近期关闭的 issue,8-bit 向量约占 4 MB;其中 2,585 条开放 issue 被标出 51 条疑似重复,快照处理约需六秒。
实时运行是另一笔时间账:模型首次下载 197 MB 后,作者笔记本读取 2,714 条 issue 约需五分钟,包括 45 秒获取数据、四分钟 GPU 编码和数秒比较。快照与实时结果不能混为一谈。
本地方案省去了托管模型调用费用和服务端部署。按作者描述,issue 内容只在浏览器处理;私有仓库可提供 token 访问。固定的模型文件也有利于复现实验,避免模型变化后相似度阈值失效。不过,托管 API 是否发生变化,仍取决于具体服务和版本策略。
下面的命令用于重放测试,检查文章中的结果:
git clone https://github.com/VanshajPoonia/already-filed
cd already-filed && npm install && npm test
要留意 npm test 的首次成本:两个测试仓库约 38,000 条 issue,在 M4 上约需两小时,之后使用缓存。npm run tune 可查看 ollama 上的调参过程,node scripts/audit.mjs zed-industries/zed 30 可输出作者检查的误报样本。
原文标题写 23,000 条,末尾又说明三个仓库共测试 49,690 条;它们与两个测试仓库约 38,000 条的统计范围没有完整对齐,不宜直接当成同一个规模数字。
我的判断
我认可它把检索结果交给人确认,也认可用真实维护记录、按时间回放来评估。与安装 GitHub App 或 Action 的自动化方案相比,网页工具适合先体验效果;持续处理每条新 issue,则是另一种工作流需求。
局限也很明确:三个仓库不足以证明它适合所有团队。模板、语言、报错密度和维护习惯都可能改变效果,正文裁剪还可能丢掉日志后半段的线索。
65% 的历史前三命中率,支持辅助查找,不支持自动关闭。
此外,历史重复关联并不完整。抽查结果提示标签可能漏标,却不能据此推算整体推荐准确率。五分钟的运行时间也是作者设备上的实测,缺少跨设备对照;本地免费指没有模型调用账单,计算和等待仍由用户承担。
能拿来做什么
- 维护开源前端组件库或 Node 工具时,可以先用它整理待处理 issue,让维护者逐条确认候选原帖,尤其适合积压较多的仓库。
- 给依赖项目提交 bug 前,可以粘贴草稿检查候选讨论,先看是否已有解决办法或相关 PR。
- 自己实现重复检测时,可以先复现搜索范围、模板清洗、任务提示和混合评分,再决定是否需要更大的模型。
- 让 AI 编程助手协助修改检索逻辑时,可以把按时间回放的历史数据作为验收依据,同时观察前三命中率和高置信推荐,避免只看几个演示案例。