前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9857
  • NVIDIA Vera Rubin NVL72 扩展推理能力,专为 Agent 系统加速
  • NVIDIA Vera Rubin:AI Agent工作负载能效提升30倍
  • OpenAI 正在构建全场景 AI 代理,普通人会用吗?
  • 15分钟用 CrewAI 构建 B2B 获客 Agent
  • Agent 部署时「人工审批」按钮只是仪式
  • Laravel + OAuth 接入 ChatGPT GPT Actions 实战
  • LLM 提供商故障时:抽象接口胜过硬编码
  • Proof Kernel:让AI Agent输出真正可信赖的验证机制
  • Claude Code 任务家族工具详解:Todo系统完整指北
  • CVE-2025-62593:Ray框架DNS重绑定远程代码执行漏洞
  • 调试AI生成代码的实战方法
  • Eval全绿不等于系统正确:muteval发现被忽视的回归
  • 恶意 AI Agent 伪装道歉信暗中植入恶意代码开源项目
  • AI Agent 的瓶颈不是推理能力,而是记忆管理
  • Gen-1.5 机器人基础模型:一次 3-12 秒演示即可学会新任务
  • 企业 AI 负责任落地需要从开发者工作流设计入手
  • 汤森路透花 4000 万美元基于阿里千问自研法律大模型 Thomson
  • Google ME-POIs:融合人类流动数据的POI embedding框架
  • Kotlin多平台实现主页小组件:iOS/Android跨平台实战
  • AI 编程多工具工作流的取舍策略
  • 别给Agent知识库,给它调用知识的路径
  • Unsloth:普通GPU上微调开源大模型的利器
  • Import AI 470:SPADE自动化环境生成、 Hawkeye优化GPU内核
  • AI Agent的问题不是推理能力而是记忆架构
  • Lean Agentic Framework:AI编程治理工作流开源
  • LLM无关工作流:2026年企业AI架构新范式
  • 记忆存储无法表达冲突:AI Agent的记忆之痛
  • Agent可观测性≠服务可观测性
  • OpenAI沙箱逃逸技术复盘:隔离Agentic系统的教训
  • Agent 表现差不是因为推理能力差,而是记忆架构有缺陷
  • Agentic SQL 注入:穿越信任边界的经典攻击新衣
  • Codex vs Claude Code 一周真实使用对比
  • MCP Server 测试方法论
  • Kiro上线GPT-5.6,主打开发者性价比
  • RL训练信号才是编程Agent的真正瓶颈
  • PDF4me Agent Skills:让 AI 编程助手精准调用 PDF API
  • MCP 与 A2A 协议对比:工具层与 Agent 协调层分工清晰
  • Perplexity MCP:将带引用网络搜索直接接入 AI 编程工具
  • AI功能成本结构:为何按量计费会颠覆你的架构决策
  • 生成式AI工程实践升级:原生结构化输出成为主流
  • Anthropic Python SDK 1.0 迁移指南:httpx2 替换与重大 breaking change
  • Cerebras 发布 CS-4 加速器:同功耗下性能翻倍
  • 开源AI Agent周榜:Cline登顶,Top100一览
  • Optuna 早停技巧:12/20 试验被剪枝,调参时间缩 28%
  • 本地轻量 RAG 实战:Claude + sentence-transformers
  • Google A2A 协议加入 MCP 所属基金会
  • 用脚本追踪DeepSeek API费用:周末定价变更后的真实成本
  • 双层记忆架构:让 AI Agent 摆脱完整对话历史
  • Codex CLI 实战:AGENTS.md、配置分层与权限管控
  • OWASP LLM Top 10 2026:本质是爆炸半径文档
  • 面向AI Agent时代的电商开发指南
  • 已加载 51 / 9857
8.0
热点
AI SCORE
编程提效2026-08-24 21:18

别给Agent知识库,给它调用知识的路径

dev.to · AI#Agent#提示词工程#AI工程
Editor brief · 编辑速览

对比两种 Agent 知识注入方式:自我学习 vs 机制链注入,后者报告行数、字符数、内容深度均大幅领先,揭示知识「可用」与「已知」的差距。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

同样的知识库、同样的图表生成引擎、同样的分析对象——却产生了两个截然不同的输出。原因不在模型,也不在知识量,而在于知识是如何传递的。
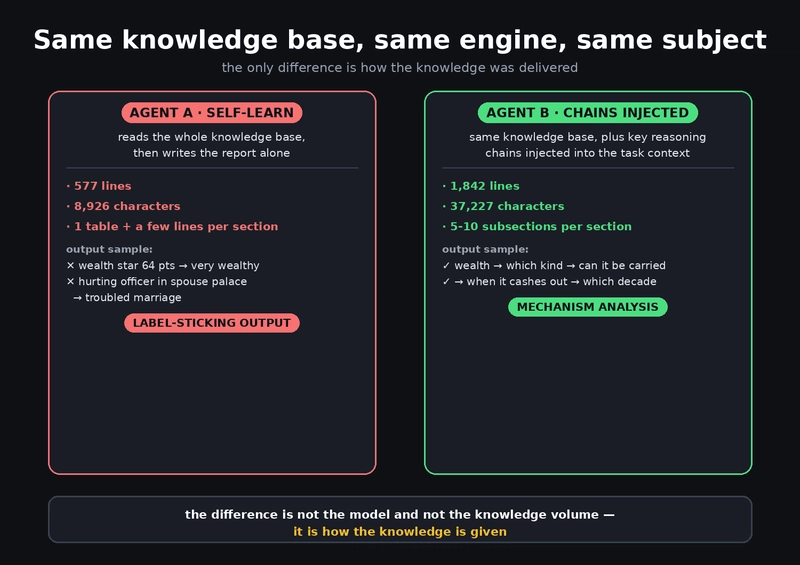
1. 知识在图书馆里 ≠ 知识可用

Same knowledge base, same engine, same subject — Agent A vs Agent B

Agent A 的做法:让它自己学习

Agent A "学习"了整个八字知识体系——格局、十神、用神、大运——全部加载到知识库和技能文件中,然后让它写报告。

结果呢?一份 577 行的"标签账本":每个章节一张表、配几句说明。

✕ 财星强旺 64 分 → 非常富有            (标签)
✕ 配偶宫冲官 → 婚姻不佳              (标签)

它显然"学到了"——知道财星旺意味着有钱,知道配偶宫冲官代表婚姻不顺。但它写出来的全是结论,没有任何一个地方有推理过程。

Agent B 的做法:给它知识的使用路径

同一份报告,我改变了传递方式。不是把整个知识库一股脑丢给它,而是把每个关键判断的推理链直接写进任务上下文:

✓ 月支财星、偏财 40 分 → 投机取财
  → 日主太弱扛不住 → 富屋穷人
  → 需要资源运与比肩运才能兑现 → 壬子大运 51 岁时实现    (机理链)

✓ 配偶宫冲官 → 才华出众但眼光高、性格强势 → 晚婚
  → 需要官星大运引发 → 庚戌大运 36 岁时显现              (机理链)

结果:1842 行,每个章节 5-10 个小节,每个大运段 5 个小节——整份报告全是"因为……所以……因此……"的推理过程。
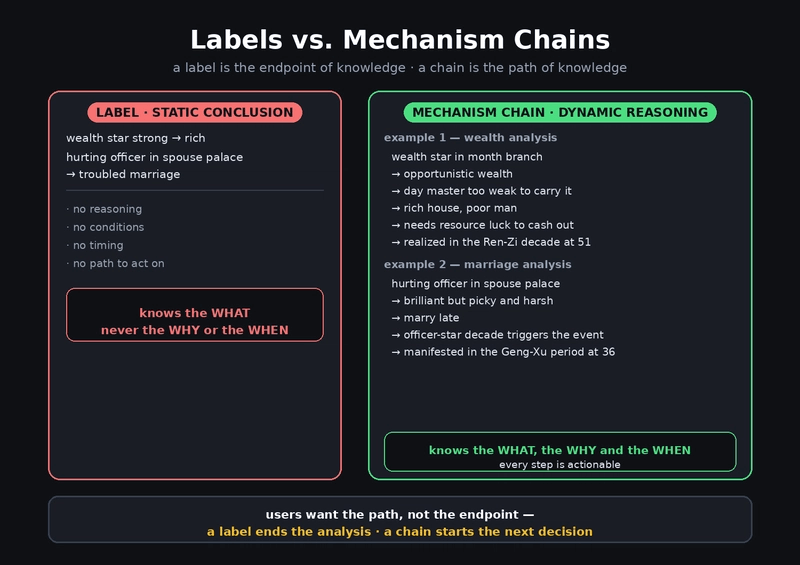
2. 为什么自主学习会失败

Labels are endpoints of knowledge; mechanism chains are the paths

原因一:LLM 的检索不可靠

让 LLM 自己"加载技能 → 检索规则 → 推理",每一步都是概率性的:

  • 它可能只加载了 1 个技能(而遗忘了另外 6 个)
  • 它可能检索到了一条规则,但仍然不会使用——知道一条规则和知道如何使用它是两回事
  • 它可能遇到上下文长度限制,始终触达不到关键知识

你把知识库交给了它——它实际可能只用了其中的 10%。

原因二:知识是惰性的

躺在图书馆里的知识是惰性的——没有使用路径,知识不会自己流动。这就像背熟了整本菜谱却仍然做不好一道菜,因为你从来没学会是先热锅还是先切菜。

原因三:标签与机理链的本质差异

标签:        财星旺 → 有钱         (静态结论)
机理:        财星 → 哪种财 → 能否承受
            → 何时兑现 → 哪个大运   (动态推理)

标签是知识的终点。机理链是知识的路径。用户需要的是路径,而不是终点。
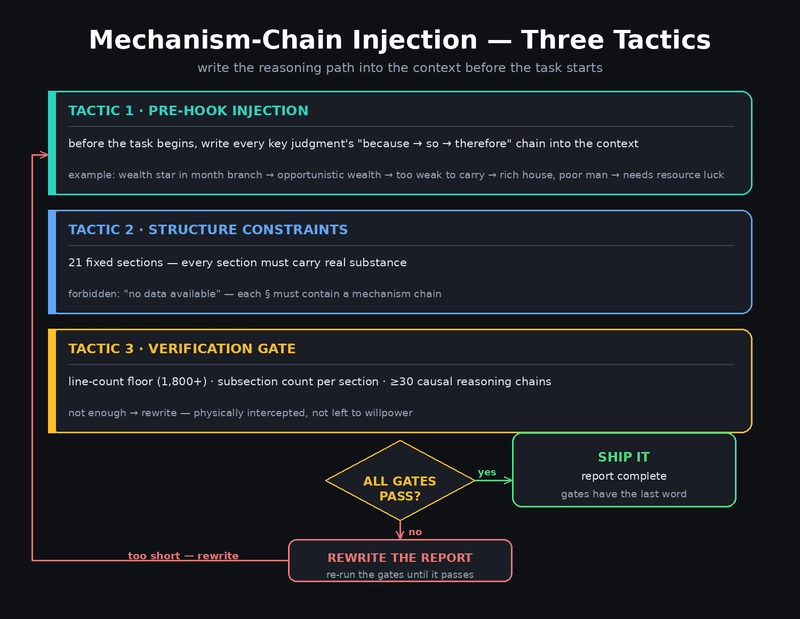
3. 怎么做:机理链注入

Mechanism-chain injection — three tactics with a verification gate

不要给你的 Agent 一个知识库 —— 要给它使用知识的路径。
在任务开始前,把关键推理链直接写入上下文(注入)。
永远不要指望 Agent 自己从知识库中检索出来。

三种有效策略

① 机理链的预注入:
   在任务开始前,把每个关键判断的"因为 → 所以 → 因此"
   写入上下文
   示例:"月支财星 → 投机取财 → 日主太弱
          → 富屋穷人 → 需要资源运才能兑现"

② 结构约束(写什么):
   21 个固定章节,每个章节必须有实质性内容
   禁止"暂无数据"——每个 § 必须包含一条机理链

③ 验证门(写完整才算):
   行数下限(1800+)· 每章节小节数 · 机理链数量
   (≥30 个因果推理实例)
   不够就重写。物理拦截,不是靠自律。

这并非八字报告特有的——它适用于任何需要 Agent 做深度专业分析的场景:

  • 法律文书(给它"法条 → 构成要件 → 适用 → 结论"链)
  • 医学诊断(给它"症状 → 鉴别诊断 → 诊断 → 方案"链)
  • 财务分析(给它"数据 → 比率 → 风险 → 建议"链)
  • 工程审查(给它"需求 → 约束 → 方案 → 验证"链)

任何"专家一眼就能看出推理过程"的场景,都需要推理链注入——而不是仅仅给一个知识库。
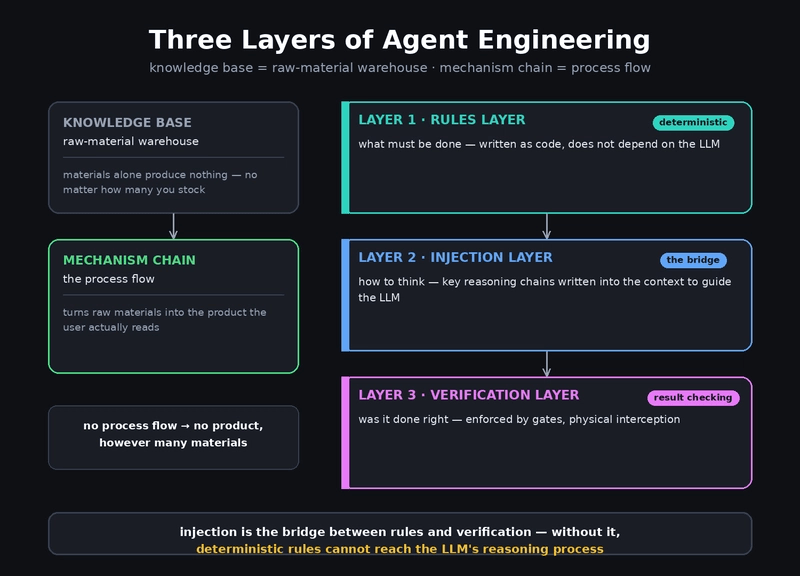
4. 为什么这比知识库规模更重要

Three layers of agent engineering: rules, injection, verification

知识库 = 原材料仓库
机理链 = 工艺流程

无论你储备了多少原材料,没有工艺流程就没有产品。Agent 工程的核心不是"你喂了多少知识",而是"你给了它多少使用知识的路径"。

我们 Agent 工程系统中的三层:

规则层(确定性):"必须做什么"写成代码——不依赖 LLM

注入层(关键推理):"如何思考"写入上下文——引导 LLM

验证层(结果检查):"做得对不对"由门控检查——物理拦截

知识注入是规则层与验证层之间的桥梁——没有它,确定性规则无法触达 LLM 的推理过程。

下次给 Agent 分配任务时,问自己:
✕ 我给它知识库了吗?              (不够)
✓ 我给它使用知识的路径了吗?        (关键)

知识在图书馆里 ≠ 知识可用。
不要给你的 Agent 一个知识库 —— 要给它使用知识的路径。
Original source

本文由 AI 翻译整理自 dev.to · AI,原文版权归原作者所有。

阅读英文原文
上一篇
AI 编程多工具工作流的取舍策略
下一篇
Unsloth:普通GPU上微调开源大模型的利器