英伟达四节点开发套件支持本地集群调试
DGX Spark HPC 开发套件以四台 GB10 设备直连,提供合计 512GB 内存和 20TB NVMe 存储,无需额外网络交换机。配套 HPC SDK 安装指南将支持 GPU 加速编译与 MPI 工具,方便科研团队在扩展到大型系统前验证任务分布和通信。
AI 深度解读
英伟达在 SC26 宣布的 DGX Spark HPC 开发套件,是把四台 DGX Spark 组成一套本地科研开发集群。它想解决的问题很具体:服务器配额有限时,研究人员可以先在桌边完成开发、调试和通信排查,把大系统留给正式计算任务。
这套方案的价值在于提前验证多节点程序。512GB 内存、20TB 存储,以及最高 7000 亿参数模型的部署能力很抢眼,但原文没有提供性能实测,不能据此判断模型跑得多快、科学计算能提速多少。
四台机器组成的集群,解决什么问题
按照原文介绍,套件由四台搭载 GB10 Grace Blackwell 超级芯片的 DGX Spark 组成。四个节点通过 NVIDIA ConnectX-7 网络适配器直接互联,不需要额外购买网络交换机。
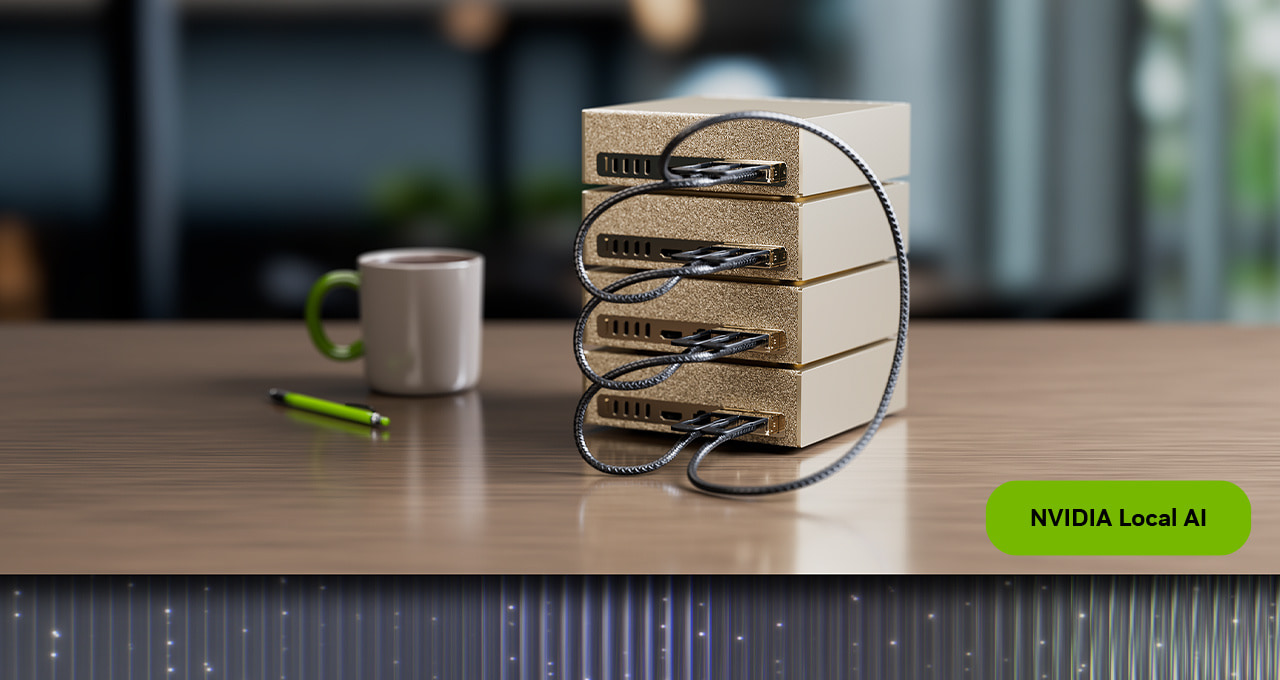
整套集群提供 512GB 内存和 20TB NVMe 存储空间,可以把模型和科学计算任务分配到不同节点上。这里的「节点」就是参与协同计算的一台机器,程序需要安排每台机器处理哪些数据,以及它们如何交换结果。
四节点集群的主要用途,是把分布式开发和调试搬到本地。
原文描绘的使用场景是:科研人员不必为每一项开发任务等待服务器配额,先自行完成开发和调试,再把正式生产任务交给服务器。这是产品希望带来的工作方式变化,报道没有给出实际节省了多少排队时间。
能部署大模型,不等于已经证明好用
原文称,这套设备可以在本地部署 DeepSeek V4.1 等参数量最高达 7000 亿的 AI 模型。不过,报道没有说明对应的量化精度、运行配置、上下文长度,也没有提供生成速度或并发测试。
这些缺失会直接影响判断。同样叫「部署成功」,能够加载并完成一次推理,与能够支撑日常交互或持续服务,使用体验可能差很多。
512GB 也是整套集群的内存总量。报道没有解释模型如何跨节点放置、内存如何被程序使用,因此不能直接把它理解成一台机器上可随意使用的连续内存。
对 AI 开发者来说,7000 亿参数可以作为进一步了解方案的线索,还不足以成为采购结论。
HPC SDK 要补上的是多节点开发工具
英伟达还将推出 NVIDIA HPC SDK 安装指南,为 DGX Spark 集群提供 GPU 加速的 C、C++、Fortran 编译器、库,以及消息传递接口(MPI)工具。
MPI 可以理解成多台机器之间交换计算数据和协调任务的一套接口。科学程序拆到四个节点后,除了检查计算结果,还要检查数据分配是否合理、节点间通信是否正常。
这也是小集群的另一层用途:在扩展到更大型系统之前,先暴露任务划分和通信问题。但原文只说可以提前排查,没有证明四节点上的性能表现能直接推算到大型集群。
设备目前正在 SC26 展出。报道列出的购买渠道包括宏碁、华硕、戴尔、技嘉、新华三、惠普、联想、微星和 xFusion 等 OEM 合作伙伴,也可以购买公版机器及配套设备。原文没有公布价格和具体交付安排。
我的判断
我更认可它作为科研开发环境的定位。对于经常等待服务器配额、又确实需要验证多节点程序的团队,本地四节点设备有明确用途;如果工作主要是单机应用开发,这个优势就未必用得上。
与直接在远程服务器上调试相比,本地集群提供了另一种资源安排方式,但是否划算,仍取决于设备价格、使用频率和维护成本。报道没有给出这些数据,也没有提供对照测试,目前只能把减少等待、提高开发效率视为产品定位,不能当作已经验证的收益。
这是一则设备发布消息,还不是性能评测。
对以前端和 Node 开发为主的读者,关联最直接的是本地 AI 模型服务;C、C++、Fortran 和 MPI 工具链则主要面向科学计算,不必因为它带有 AI 标签就默认适合自己的项目。
能拿来做什么
- 如果团队的科研任务经常卡在服务器配额上,可以先梳理哪些开发、调试和通信检查能移到本地,再评估四节点设备的利用率。
- 如果准备运行 DeepSeek V4.1 等大模型,应要求供应方提供目标配置下的量化精度、上下文长度、生成速度和并发结果,再判断能否支撑实际服务。
- 如果正在开发 C、C++ 或 Fortran 科学程序,可以关注 NVIDIA HPC SDK 安装指南,用四节点环境检查任务分配和 MPI 通信,再到目标大系统验证扩展效果。