Oracle 到 ClickHouse 的实时同步实战
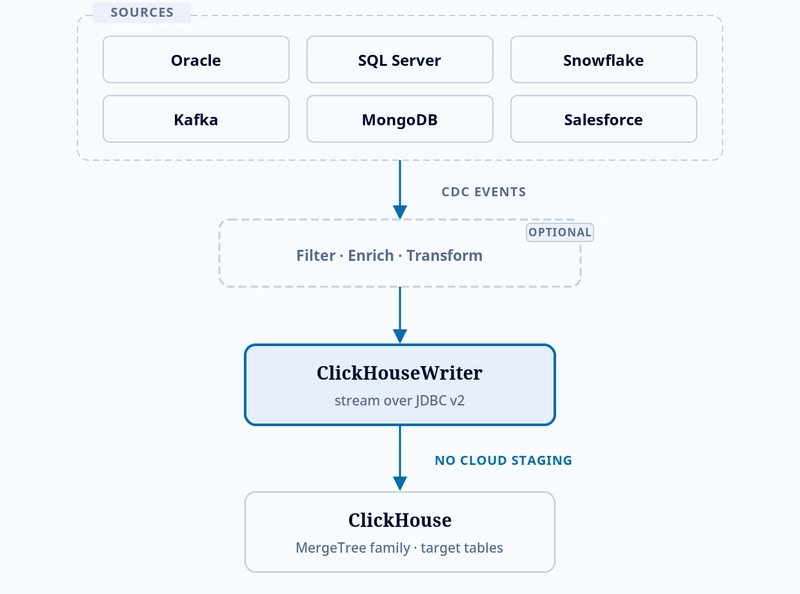
文章围绕 Striim ClickHouseWriter 讲解 Oracle CDC 管道,覆盖补充日志配置、MergeTree 引擎选择、批次写入机制和吞吐调优。数据经 JDBC 直接写入 ClickHouse,无需中间对象存储。
AI 深度解读
Oracle 里的订单不断新增、修改、删除,怎样让 ClickHouse 持续拿到可分析的数据?作者用 Striim 的 ClickHouseWriter 搭了一条 CDC(变更数据捕获)链路,示例表是 TPCH.ORDERS,重点落在日志完整性、表引擎、失败恢复和批量写入。
它最有用的结论是:接通数据只是第一步,真正决定结果是否正确、查询是否省心的,是更新和删除怎样落表。原文给出了配置与运行输出,但没有吞吐对照实验,生产性能方面需要带着这个前提看。
先确认日志里有没有足够的数据
ClickHouseWriter 接收 Striim 的变更事件,再通过 JDBC v2 client 直接写入 ClickHouse。批次在内存中序列化,不经过 S3、GCS 或 ADLS 等对象存储。Oracle、SQL Server、Snowflake、Kafka、MongoDB、Salesforce 等来源共用这条写入路径。
Oracle 的麻烦在于,redo log 默认不会提供复制端想要的全部列值。作者先执行 ALTER DATABASE ADD SUPPLEMENTAL LOG DATA;,再对目标表执行 ALTER TABLE TPCH.ORDERS ADD SUPPLEMENTAL LOG DATA (ALL) COLUMNS;。
这里要区分数据库级最小补充日志与表级全列补充日志。直接在数据库级启用 SUPPLEMENTAL LOG DATA (ALL) COLUMNS 会覆盖所有表,大库需要考虑额外日志量。
完整列值有两个用途:补齐 UPDATE 中没有改变的字段,以及缩小删除扫描范围。Writer 会收集批次里的分区键、排序键值,追加 IN (...) 过滤条件;如果任何相关列缺失,整个批次的裁剪优化都会关闭。
UPDATE 和 PKUPDATE 要用 before-image,也就是修改前的行,才能找到目标库里尚未更新的旧记录。原文称 INSERT、DELETE 使用 after-image,这是其事件模型下的处理约定。
不过,原文对日志要求有矛盾:前面强调全列日志是必要条件,后面又说 Striim 允许主键列或最小补充日志,并建议启用 optimizedMerge。能确定的是,补齐字段和扫描裁剪都依赖可用列值;最小日志能覆盖哪些更新场景,文中没有讲清。
选表引擎,就是选择谁来承担更新成本
CDC 的表引擎选择,会把成本分配给写入、后台合并或查询。
MergeTree 配合 MERGE 模式,由 Striim 合并同一 ORDER BY 值的批内事件,按删除再插入应用最新快照。查询端更容易直接读取当前状态,代价是每批删除带来的写入开销。optimizedMerge 用于补齐部分行镜像;默认 APPEND_ONLY 则保留所有事件,适合变更审计。
作者建议一般 Oracle OLTP 表从 ReplacingMergeTree 开始:所有操作都变成 INSERT,附带递增的 __STRIIM_VERSION 和删除标记 __STRIIM_ISDELETED。后台按 ORDER BY 键保留最高版本,删除也是一条墓碑记录。
代价在读取端。后台合并前会存在多个版本,查询当前状态需要处理去重和删除标记。
CollapsingMergeTree 使用 __STRIIM_SIGN = +1 表示状态、-1 表示撤销,后台抵消配对记录,要求 before-image,而且对顺序敏感。
CoalescingMergeTree 要求 ClickHouse 25.6+,适合每次只改少数字段的部分镜像更新。它把 NULL 当作「该列没有变化」,因此真实业务 NULL 会发生语义冲突。例如取消订单时把 SHIP_DATE 清空,就不能直接套用这一约定。作者建议此类表改用 MergeTree + MERGE 和 optimizedMerge。
它的删除仍需策略处理,默认 LightweightDelete,也可选 MutationDelete。SummingMergeTree 与使用 SimpleAggregateFunction 列的 AggregatingMergeTree 则面向追加式聚合目标,不承担普通 CDC 的 UPDATE、DELETE 语义。
配置能跑起来,还要让查询和恢复对得上
下面这段完整 TQL 把 Oracle 事件送入 ReplacingMergeTree,同时配置恢复、DDL 处理和批量刷新:
CREATE OR REPLACE APPLICATION Oracle_To_ClickHouse
  RECOVERY 30 SECOND INTERVAL
  USE EXCEPTIONSTORE TTL : '7d';

CREATE FLOW SourceFlow;

CREATE OR REPLACE SOURCE OracleSource USING Global.OracleReader (
  Tables:                '"TPCH"."ORDERS"',
  connectionProfileName: 'admin.Oracle_CP',
  SendBeforeImage:       true,
  DictionaryMode:        'OnlineCatalog',
  FetchSize:             1000,
  CDDLAction:            'Process'
)
OUTPUT TO CDCStream;

END FLOW SourceFlow;

CREATE OR REPLACE TARGET ClickHouseTarget USING Global.ClickHouseWriter (
  connectionProfileName: 'admin.ClickHouse_CP',
  Tables:                '"TPCH"."ORDERS",tgt.orders_rmt',
  TableEngine:           'ReplacingMergeTree',
  UploadPolicy:          'eventcount:10000,interval:30s',
  DeleteStrategy:        'LightweightDelete',
  CDDLAction:            'Process',
  TargetTableDefinition: '{"tgt.orders_rmt": {"Order By": "(order_id)"}}'
)
INPUT FROM CDCStream;

END APPLICATION Oracle_To_ClickHouse;
重点看 TargetTableDefinition:order_id 是去重依据,必须符合业务记录身份。还可配置 Partition BY、Primary Key 和 Settings。CDDLAction 的 Process 自动转换 DDL,Ignore 跳过,Halt 则刷新待处理事件后停止。
下面的查询解决多版本记录如何读出当前状态的问题:
-- 使用 FINAL 在查询时执行合并,开销更高
SELECT * FROM tgt.orders_rmt FINAL
WHERE __STRIIM_ISDELETED = 0;

-- 使用子查询选择最高版本
SELECT * FROM tgt.orders_rmt
WHERE __STRIIM_VERSION = (
  SELECT MAX(__STRIIM_VERSION) FROM tgt.orders_rmt o2
  WHERE o2.order_id = tgt.orders_rmt.order_id
)
AND __STRIIM_ISDELETED = 0;
注意两种写法都过滤了 __STRIIM_ISDELETED。作者称第二种更适合大表,但没有执行计划或耗时对照,不能据此认定它必然更快。
恢复检查点每 30 秒记录一次,只有 ClickHouse 确认 INSERT,或完整 DELETE + INSERT 周期后才推进。失败后重放未确认区间:原文称版本引擎靠版本去重,MergeTree MERGE 靠重新压缩、应用事件及清理 staging tables 实现幂等。
这是至少一次投递加幂等处理。作者称其具有「有效的 exactly-once 语义」,但文中没有故障注入结果,也没展开跨删除、插入期间的并发可见性。
吞吐调优首先看 UploadPolicy:达到 10000 个事件或 30s 就刷新。过于频繁的小批次会产生大量 parts。原文给出的 TOO_MANY_PARTS 默认门槛是每分区 300 个活跃 parts,建议先增加 eventcount,再考虑 parts_to_throw_insert;该默认值仍需按实际版本和配置核对。
ParallelThreads 默认 1,按目标表分配 Writer,同一张表始终交给同一实例。单表扩容需要用 ROUTER 按排序键哈希分配到 N 个 Writer,不能只增加线程数。
批次失败重试采用 2s → 32s 指数退避并加入 jitter;认证失败会刷新凭据。单条 SQL 的连接重试另由 ConnectionRetryPolicy 控制,原文配置为:
initialRetryDelay=10s, retryDelayMultiplier=2, maxRetryDelay=1m, maxAttempts=10, totalTimeout=10m
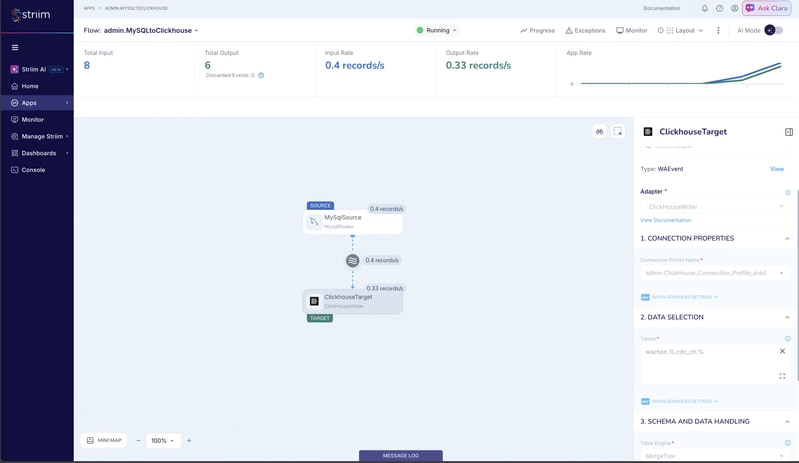
监控可用 mon -v <AppName>,检查 Table Write Information 中的事件数量、批次大小及上传、合并耗时。原文展示了接受 29 个事件的输出,最后一批 3 个事件、564 字节,这能说明指标形式,不能证明持续生产吞吐。
我的判断
这篇最有价值的是把数据正确性放到了引擎选择里。只追加的写入路径通常更容易组织,但版本去重、墓碑过滤和后台合并的成本仍然存在。团队已有统一查询层时,ReplacingMergeTree 比较容易约束;BI 工具直接查表时,就要认真评估遗漏过滤条件的风险。
恢复后结果可幂等,不等于查询始终看不到中间状态。
原文把 MutationDelete 描述为立即物理删除,并关联到 GDPR 擦除要求,这个结论给得过满。文中没有说明同步等待设置、备份、副本及其他数据副本的清理,单靠这一配置不能证明完成合规擦除。对 LightweightDelete 的短暂可见性描述也缺少时序条件。
此外,文中出现了 Oracle 类型映射标题,却没有实际映射表;不能据此确认日期、精度和空值转换。整篇更适合作为配置与机制说明。关于吞吐更高、查询更快的判断,作者没给对照数据,仍是经验性建议。
能拿来做什么
- 给 Node 数据服务或看板接入 CDC 时,先定义「当前状态」的查询契约,把去重和墓碑过滤放进统一查询入口,减少调用方各写各的风险。
- 用同一主键的连续更新、删除、排序键变更和真实 NULL 构造验收数据,再模拟批次失败重放,同时核对最终记录与恢复期间的查询结果。
- 排查延迟时,先用
mon -v <AppName>区分批次等待、上传和合并耗时,再调整UploadPolicy;单表吞吐不足时,单独评估ROUTER分流后的顺序与键归属。 - 让 AI 辅助生成配置或 SQL 时,明确提供表引擎、
ORDER BY、NULL 语义和删除标记约定,再人工检查它是否遗漏当前状态查询条件。