AI 编码如何围绕规格组织交付
文章将规格驱动开发分为规格优先、独立上下文评审、角色化智能体团队、先规划后执行和测试优先五类。核心做法是在生成代码前明确需求,再依据规格、自动检查和人工评审验收。
AI 深度解读
AI 写代码越快,团队越容易把没有讨论清楚的需求直接做成产品。这篇文章的结论是:生产项目需要先约定书面规格,再让 Agent 实现,并用可执行检查和人工审核确认结果。所谓「AI 软件工厂」,真正吃紧的环节会转向需求与验证。
作者按工作方式梳理了五条路线,从一份 Markdown 加测试,到多角色 Agent 和独立审查。对前端、全栈开发者,最有用的不是工具清单,而是判断自己的项目需要多少流程,以及哪些判断仍然得由人负责。
为什么代码能跑,还不能算需求完成
原文认为,vibe coding 适合原型、内部脚本和可点击演示。Andrej Karpathy 在 2025 年 2 月提出这个词时,描述的就是可以暂时忘掉代码细节、靠持续对话做出东西的方式。
问题出在项目开始长期维护以后。
需求藏在聊天记录里,下一位开发者读不到;Agent 遇到空白会补出看似合理的假设;审核者只能看 diff,却不知道改动原本应该满足什么;最后,Agent 还会在它觉得完成时停止。能运行,只证明程序在某些条件下没有失败。
规格驱动开发(SDD)把书面规格设为共同依据:实现前先达成一致,Agent 按它开发,审核者按它验收。代码和规格冲突时,由人决定改哪一边。
规格的价值,是让实现意图能够被独立检查。
原文引用 Thoughtworks 的 Birgitta Böckeler,将它分成三个层次:
- Spec-first 为当前任务写规格,代码完成后通常就放下。
- Spec-anchored 持续维护规格,让它跟着功能演进。
- Spec-as-source 只由人修改规格,再重新生成代码。
她在 2025 年 10 月观察时,工具几乎都停留在第一层。原文称,如今一些工具开始追求持续维护与偏差检查,但第三层最难兑现。生成过一次代码,并不能证明以后都能只维护文档。
五种路线,分别补上了哪个缺口
第一种是先把需求拆成设计和任务,再写代码,适合范围较大的功能,以及需要客户确认范围的项目。
按原文截至 2026 年 11 月 17 日的资料,GitHub Spec Kit 使用 MIT 许可,约有 150,000 stars,支持超过 40 个编程 Agent,包括 Claude Code、GitHub Copilot、Codex CLI、Gemini CLI 和 Cursor。它先建立项目原则 constitution,再按 specify、plan、tasks、implement、converge 推进。最后的 converge 会对照规格检查代码,把漏项重新放回任务列表。
Kiro 官网称其由 AWS 构建和运营,提供 IDE、CLI 和 Web 应用,把需求、设计、任务分别保存为 requirements.md、design.md、tasks.md。它也支持缺陷修复规格;Quick Spec 可以一次生成三份文件,省掉中间审批关卡。
OpenSpec 来自 Fission-AI,使用 MIT 许可,约有 75,000 stars,2.0 于 2026 年 11 月 11 日发布。它为每项变更建立独立目录,放 proposal、specs、design 和 tasks,完成后归档进持续维护的规格,定位比 Spec Kit 更轻,也面向已有代码库。
代价是文档可能比问题还大。Böckeler 的测试中,Kiro 把一个小缺陷扩成了 4 个用户故事、16 条验收标准;她也认为 Spec Kit 的大量 Markdown 文件审核起来繁琐。
第二种路线是让不了解聊天历史的 Agent 审查规格,也就是 Elephant-Goldfish Model,简称 EGM。
「大象」保留项目上下文,协助起草;「金鱼」只看文档及其引用的代码。如果它无法理解某个决定,就可能暴露出文档遗漏的前提。人处理反馈、批准设计后,才进入实现。
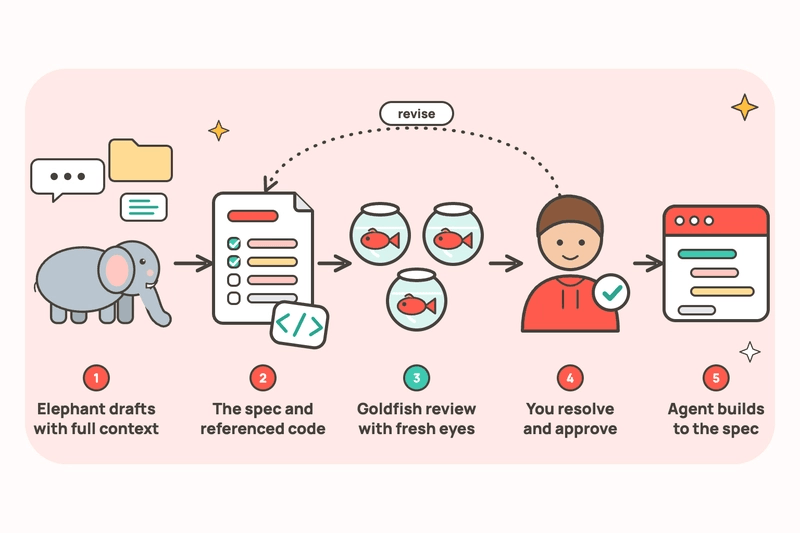
原文称,EGM 于 2026 年 9 月在 Google 的 GitHub 上开源,使用 Apache 2.0 许可,约有 20,000 stars,但不是 Google 官方支持的产品。它源于 Dave Rensin 在 2026 年 4 月的文章,可运行于 Claude Code、Codex CLI、ChatGPT 和 Codex 桌面应用、Antigravity、Claude Cowork。
审查分五步:简化检查、理解检查、设计批评、再次简化、实现就绪检查。另有 bootstrap,自底向上为旧代码写 README;drift report 则比较设计文档与当前代码,原文建议最好每周运行。
第三种是 BMAD Method,让分析师、产品经理、产品负责人、UX 设计师、架构师、开发者等角色产出简报、PRD、故事和架构文档,party mode 允许多个角色讨论草稿。它使用 MIT 许可,约有 55,000 stars;截至原文日期,6.12 是稳定版本,7 处于 preview alpha。
它适合连产品问题都还没想清楚的新项目。但角色来自提示词,不能据此认定模型获得了对应的专业能力。
日常开发,为什么可以先从计划和测试开始
第四种路线最轻:Agent 先读代码、提出计划,人修正计划,再开始编辑。
原文介绍,Claude Code 的 plan mode 可以读取文件、执行命令,但在计划获批前阻止编辑。上下文工程(context engineering)则负责整理模型应该看到的内容,包括项目记忆文件、聚焦的会话和以后可以重新载入的笔记。
这里有几个具体做法:让 Agent 先追问到足以写出规格,把规格存成文件,再换新会话实现;CLAUDE.md 保持简短,只记录无法从代码推断的信息;没有例外的硬规则,放进 hooks 和 permission rules。原文还提到,/code-review 会让未见过聊天记录的新子 Agent 检查 diff。
第五种是测试先行。先描述期望行为,确认测试失败,再让 Agent 写足够通过测试的实现。测试把「完成了吗」变成可以运行的检查。
原文引用 Kent Beck 用 Agent 开发 B+ tree 库的经历:遵守 red-green-refactor,每次推进一个测试,同时留意 Agent 是否陷入循环、添加未要求的功能,或者禁用、删除测试。
这适合计算、业务规则、数据转换和缺陷修复。但测试表达的是可观察行为,无法完整解释产品意图、架构取舍和体验质量。测试也要审核,尤其要看 Agent 有没有为了通过检查而削弱断言。
我的判断
我赞同原文把五种方式视为可以组合的做法。一个功能可以先写简短规格,交给新会话审查,再按计划实现,最后用测试验收。没必要先选一个庞大框架,再把所有任务塞进去。
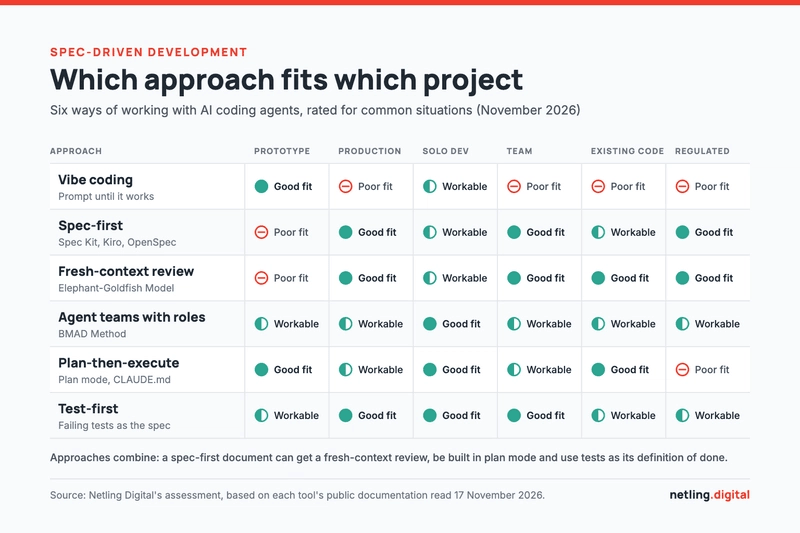
但这篇文章更接近选型经验整理,没有提供统一任务上的对照实验。stars、文档数量和角色数量,都不能证明交付质量更好。Böckeler 的工具测试、Beck 的开发经历,也不足以推导一般团队的收益。
EGM 的价值在于检查文档能否脱离聊天独立成立。不过,新会话只能减少共享上下文的影响,不能保证模型不再犯同类错误;多轮审查还会增加时间、token 和反馈筛选成本。它要求能够启动新子 Agent,而设计阶段不改生产代码的约定,原文也承认没有强制机制保障。
作者团队 Netling 使用 Claude Code,客户项目先由人批准规格;认证、支付、权限、合并、数据库迁移、生产数据和架构决策,都不会只交给 AI。这是他们声明的实践边界,文章没有给出相关缺陷率或效率数据。
先选能留下规格、运行检查、明确验收责任的最轻流程。
规格是否长期有用,最终还取决于有人维护它。否则,团队只是把过期的聊天记录换成了过期的 Markdown。
能拿来做什么
- 给跨会话的前端或 Node 功能,在仓库里留一份短规格,写清目标、边界、验收行为和待确认问题,让下一次会话能够接着做。
- 在熟悉的代码库中,先让 Agent 阅读并提交计划;遇到数据模型、服务边界等昂贵决定,再增加独立会话审查,检查规格是否遗漏前提。
- 对计算逻辑、数据转换和可复现缺陷,先确认测试能失败,再交给 Agent 修复;审核时同时检查实现、断言以及被删除或跳过的测试。
- 接手旧项目时,先核对现有行为与文档,再引入规格流程;如果采用持续维护的规格,就安排定期偏差检查,避免文档逐渐失真。