Workers AI 披露跨请求 KV 缓存泄露
Cloudflare 披露,Workers AI 上 GLM-5.3 的配置不匹配触发了 SGLang 缺陷,导致 KV 缓存页跨请求暴露。文章围绕该问题及其修复展开。
AI 深度解读
Cloudflare 的一次模型服务事故,把「长上下文支持」背后的隔离问题暴露了出来:请求拿到了 HTTP 200,回复也通顺,内容却可能混进其他用户的数据。受影响的是 Workers AI 上的 GLM-5.3,根因是缓存容量配置错误,叠加 SGLang 在分离式推理中的拒绝流程漏洞。
这份复盘值得程序员读,不只是因为它涉及 AI 安全。它揭示了一个熟悉的问题:分布式系统里,一端认为任务已经完成,另一端却没有写完数据,而接口成功把这种分歧藏了起来。
为什么超过容量的请求会读到别人的内容
Cloudflare 披露,问题存在于 2026 年 8 月 27 日至 9 月 9 日,共影响 155 条响应,触发它们的提示词都超过 681,280 tokens。受影响的模型标识是 @cf/zai-org/glm-5.3,其他 Workers AI 模型未受影响。
他们排除内部测试和研究者请求后,认为剩余请求的时间与数量符合普通长上下文使用,没有发现蓄意利用的证据。这里应当保留「没有发现」的边界,不能进一步写成确定无人利用。
理解事故,先看 KV cache。模型处理提示词时,会保存后续生成需要反复读取的中间结果,避免每生成一个 token 都重新计算前文。它并不是聊天记录的原文副本,但读取错误的缓存,仍可能让输出带出其他请求的信息。
Cloudflare 使用 SGLang,将推理拆成两部分:prefill GPU 处理提示词、生成 KV cache,再通过 Mooncake 使用远程直接内存访问(RDMA),把缓存传给 decode GPU,由后者生成回复。
GPU 上的缓存采用固定大小的内存页。请求结束后归还页面,下一个请求取得页面并覆盖旧内容。页面当时不会在请求之间清零,因此隔离依赖引擎正确管理页面归属、写入范围和释放时机。
配置错误出在这里:GLM-5.3 对外提供 1,048,576-token 上下文窗口,但 prefill KV pool 只能容纳 681,280 tokens。
这两个数字并不会自动保持一致。上下文长度是配置值,KV pool 则是 SGLang 启动时,根据加载模型权重后剩余的 GPU 显存计算出来的。量化、并行方式等配置变化,都可能改变实际容量。
一个被拒绝的请求,为什么还能走完整条流水线
请求超过缓存池容量时,SGLang 的调度器确实拒绝了它。Req.set_finish_with_abort 记录待返回的错误,并把提示词替换成单 token 占位内容,让请求经过正常批处理流程后退出。
在单节点部署中,这条路径能够向客户端返回错误。但在 prefill/decode 分离模式中,两端接入队列检查的是 req.finished()。拒绝原因存在 to_finish,没有进入 finished_reason,所以 finished() 仍返回 False。
请求已经被拒绝,却仍被后续流程视为存活。
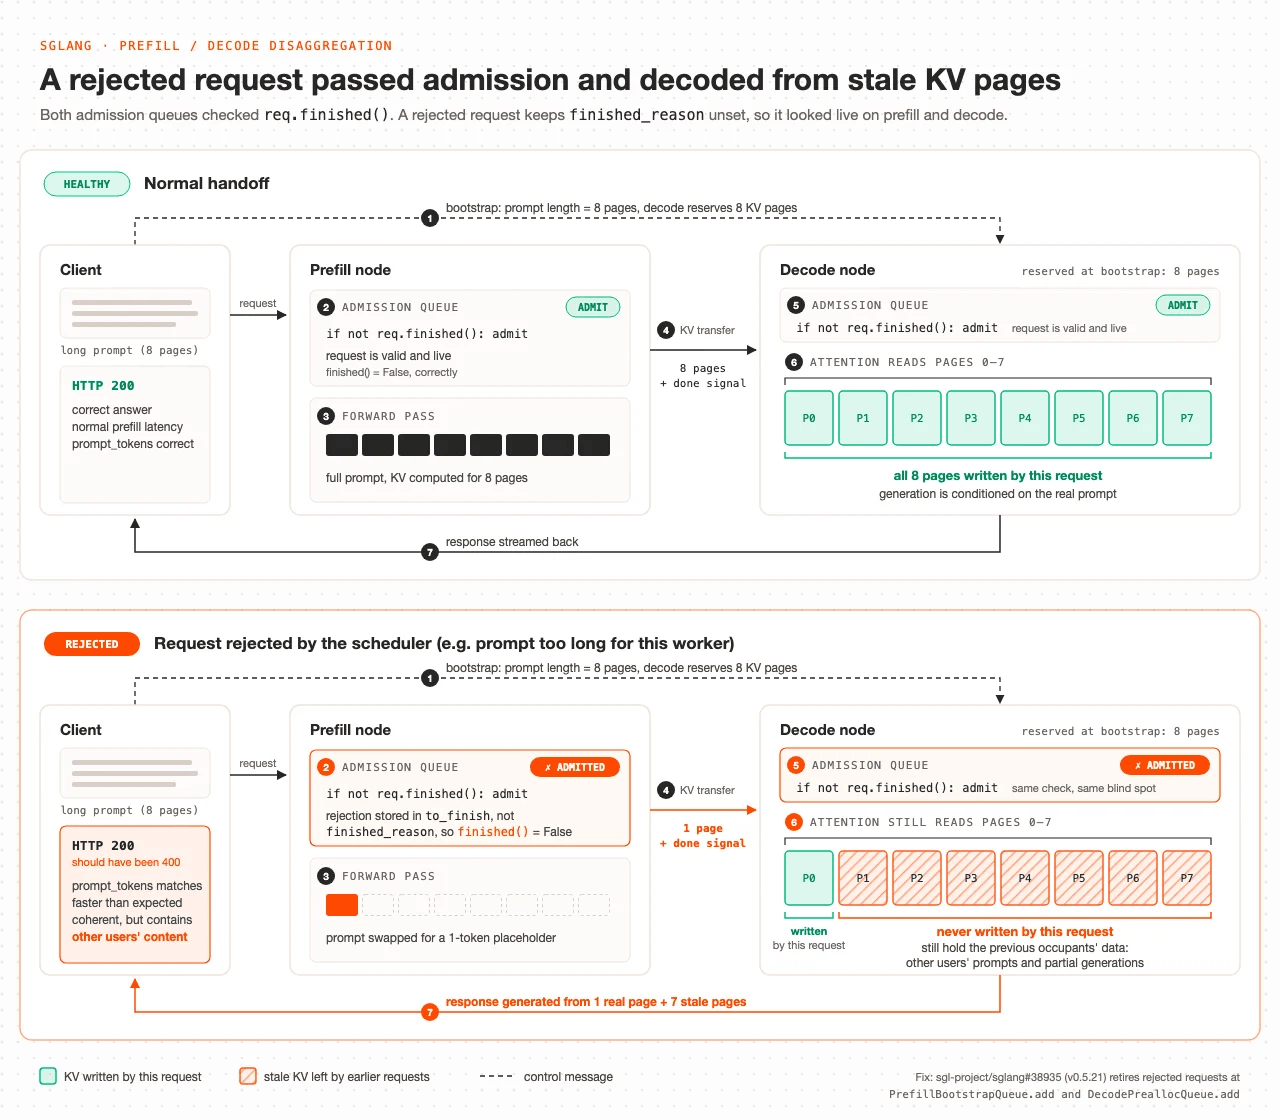
原文用 8 页缓存说明后果:decode 根据原始提示词长度预留 8 页,prefill 却只处理占位 token,传来 1 页缓存,然后发出「传输完成」信号。
decode 信任这个信号,开始读取全部 8 页。只有 P0 被当前请求覆盖,P1 到 P7 仍保留此前请求的数据。
最终客户端收到 HTTP 200,而非预期的 HTTP 400;prompt_tokens 对应原始长提示词,回复也可能通顺,只是到达速度比完整 prefill 应有的速度更快,并混入别人的内容。原文强调,超过阈值的请求都会走到这条错误路径,它不依赖偶然的竞态时机。
HTTP 成功、流式输出正常、内容通顺,都不能证明请求隔离正确。
Cloudflare 上线前已经知道容量不匹配,但长上下文压测只检查了 HTTP 状态、流式响应是否包含错误帧以及性能,没有验证输出内容和连贯性。他们据此推测引擎可能通过流式处理等机制消化容量差异,这个推测没有得到验证。
修容量只是止血,错误必须在交接前结束
研究者 Gadi Evron 于 9 月 8 日通过 HackerOne 报告问题。Cloudflare 次日上午复现,在宣布安全事件后的 40 分钟内下线模型,并于 9 月 9 日恢复服务。
修复分成两层。
第一层是调整配置,使缓存池容得下完整上下文。他们参照 GLM-5.2 配置释放显存,将 prefill KV pool 扩大到约 204 万 tokens,约为 1,048,576-token 上下文的两倍。合法请求由此不再触发这条容量拒绝路径。
第二层是修正引擎:带有待处理拒绝状态的请求,必须在分离式接入队列结束,并返回原始错误,不能继续进行 bootstrap、内存分配或 KV transfer。Cloudflare 提出的 #38704 还加入了 decode 对预留与传输 token 数的核对。
相关修复 #36988 已于 9 月 6 日合入 SGLang main,当时尚未发布;随后上游合入更早拒绝请求的 #38935。补丁在 v0.5.20 发布,v0.5.21、v0.5.22 继续补强。原文建议分离式部署使用 v0.5.22 或更高版本,或按需回移补丁。
Cloudflare 使用研究者复现脚本及自有 canary-marker 测试验证后,才恢复模型。
后续加固还处理了另一类风险:请求中止时,已发出的 RDMA 写入无法撤回。如果 decode 立即释放页面,迟到的写入就可能落入新请求的缓存。
因此,他们在两端延迟释放页面,限制 Mooncake 单次传输批量,并调整负载均衡器:客户端断开时,保留 prefill 连接直到处理完成,保留 decode 连接直到首个 token 出现,再关闭连接,减少传输中途的中止。
检测也在推进。--disaggregation-enable-kv-checksum 检查交接缓存的完整性,--kv-canary 用于发现并记录潜在损坏。但它们尚未覆盖全部模型架构,不能只看参数开启,还要确认日志里确实发生了验证。
我的判断
这份复盘最有价值的,是把配置责任和引擎责任都讲清楚了。容量检查应当阻止错误配置上线,引擎也必须安全处理被拒绝的请求。任何一层都不能默认另一层永远正确。
相比只在代理层限制输入长度,直接读取运行中引擎的实际容量更可靠,因为代理不知道模型加载后还剩多少显存。相比只扩大缓存池,在交接前终止错误请求更耐用,因为未来的量化或并行配置调整仍可能改变容量。
不过,原文没有给出清零、校验和、页面标签等方案的完整性能对照。不能据此认定某一种方案已经兼顾全部安全与性能要求。
Cloudflare 的页面标签原型更接近长期方向:每次页面重新分配时改变标签,请求保存预期标签,在 decode 读取前核验归属。他们称测试中吞吐和尾延迟开销低于 1%,但这个结果来自 8 月中旬的 GLM-5.2 测试,原型随后因可靠性问题停用,也受限于特定 attention backend 和模型架构。
低于 1% 是特定原型的测试结果,不能当成通用生产承诺。
同样,形式化验证目前是后续计划。他们准备对基于 Mooncake 的 RDMA KV 传输协议建模,检查安全性质;这不能被解读成系统已经获得完整证明。
对普通前端或 Node 团队,直接价值主要在验收方法。除非自行维护推理集群,否则无需照搬底层补丁;但「只看接口成功」这条测试盲区,很容易出现在日常 AI 应用里。
能拿来做什么
- 给 AI 接口验收加入内容断言。长输入测试除了检查状态码、流是否结束和耗时,还应验证模型是否使用了输入中的关键事实,避免把通顺回答当作处理成功。
- 对维护自建 SGLang 服务的团队,每次修改权重、量化、并行方式或显存比例后,都应从启动日志核对 prefill 与 decode 的实际 KV pool,并与上下文长度比较。
- 在多租户 AI 服务中,用独立测试账号和人工构造的独特标记验证隔离,覆盖超长输入与异常退出路径,避免拿真实敏感内容做探针。
- 为 Node 网关配置断连取消策略时,先确认推理后端如何完成跨节点传输和页面回收。前端取消请求后的资源释放,需要与后端生命周期配合设计。