180 次调用揭示模型评测为何要重复
作者用 12 道任务对三个模型分别测试五轮,共完成 180 次调用,以观察输出波动。文章强调区分偶发失误与稳定复现的缺陷:前者可能通过重试解决,后者需要更换模型或调整流程。
AI 深度解读
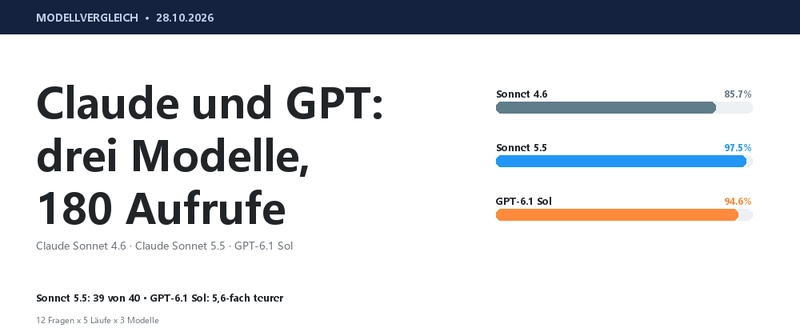
同一个问题问一次,测到的是一次输出;连续问五次,才有机会看见模型反复出错的位置。作者用 Sonnet 4.6、Sonnet 5.5 和 GPT-6.1 Sol 跑了 180 次调用,发现标价相同的模型,实际费用能差 5.6 倍,而更贵的输出未必更准确。
这组实验值得看的地方,是它把模型选型拆成了几个可检查的问题:约束能不能守住、错误会不会重复、完成同一任务到底花多少钱。但样本规模和测试范围,也限制了这些结论能推广多远。
五次重复,比一次答对多告诉了什么
作者准备了 12 道小任务,每题跑 5 次,比较 3 个模型,共 180 次调用。题目包括计算、概率、限制字数的定义,以及结构化输出和编码任务。
其中 8 道可以自动评分,另外 4 道编码和改写任务需要人工判断,没有进入准确率。还有 13 次调用因网络错误被排除,所以各模型参与评分的分母并不一致。
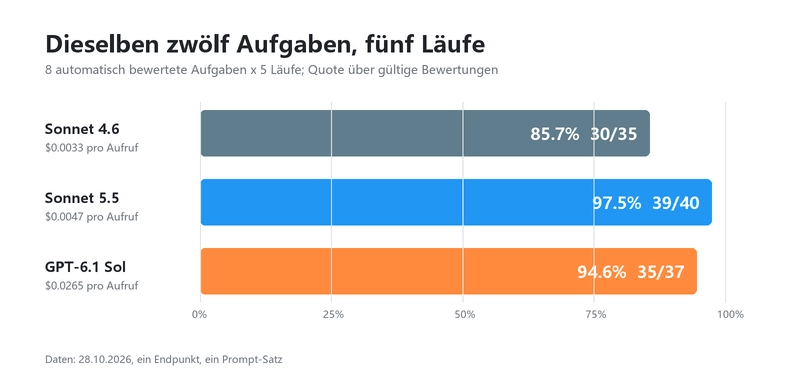
重复测试想区分两件事:偶发失误,以及同一个约束下反复失败。它们需要不同的处理办法。
例如,任务要求用最多 60 个字符解释 MoE,且不能使用德语单词「Experte」。作者展示的一组输出中,Sonnet 4.6 写了 65 个字符,Sonnet 5.5 写了 58 个,GPT-6.1 Sol 写了 48 个。
再看 Sonnet 4.6 的五次结果:65、62、68、66、70,全部超限。
对于允许编辑的说明文字,多写几个字可能无关紧要;对于自动检查长度的流程,每次输出都需要返工。这里真正测到的是:这个模型在这条提示和这道任务上,没有稳定遵守长度要求。
作者将原因解释为模型更重视定义完整性。这是一种合理推测,但实验没有直接证明模型内部如何权衡。也不能由此断言,所有短文案任务都会出现相同行为。
同样的 Token 单价,为什么账单差了 5.6 倍
作者使用的网关模型列表显示,截至 2026 年 10 月 28 日,Sonnet 5.5 和 GPT-6.1 Sol 的价格相同:每百万输入 Token 2 美元,每百万输出 Token 10 美元。
实际测量中,Sol 每次调用花费 0.0265 美元,Sonnet 5.5 为 0.0047 美元,相差约 5.6 倍。全文给出的单次调用费用范围是 0.0033 至 0.0265 美元。
单价相同,不代表完成同一任务的成本相同。
作者把差异归因于 Sol 花更多时间推算,并输出更多中间步骤。不过,原文没有列出逐次 Token 用量,也没有展开网关的具体计费明细,因此可以确认费用差距,成本构成还不能完整复核。
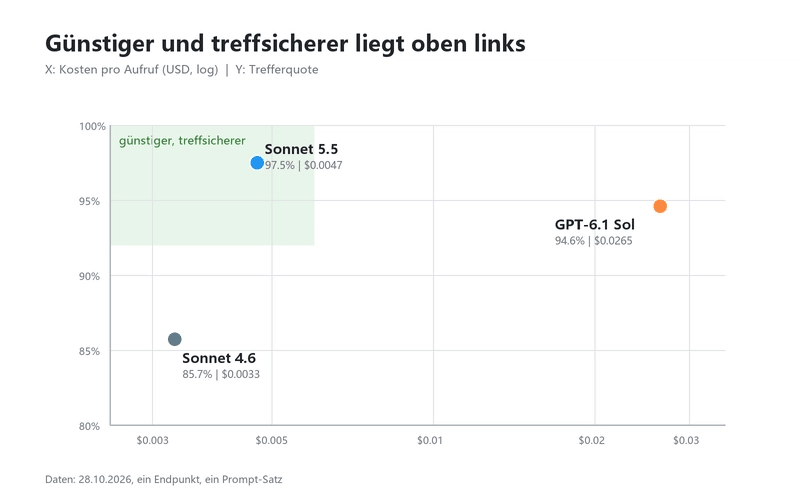
费用更高,也没有换来这组题上的全面优势。在一道要求求出椭圆切点横坐标平方的题目中,Sol 五次有两次回答 4/5,正确答案应为 16/5;另外两个模型均五次答对。原文没有提供完整题目,读者无法独立重算。
Sonnet 5.5 则在另一道概率题中,四次回答正确的 3/5,一次回答 3/10。任务涉及从 1 至 5 中取三个数,判断总和为偶数的概率。作者认为,错误来自把符合条件的奇偶组合数反了,但原文没有完整交代抽取规则。
作者据此给出 Sonnet 5.5 的自动评分结果:40 次中正确 39 次,并认为这类偶发错误用 Retry 就够了。这个建议需要单独审视:重试可以重新生成答案,却不会自动告诉流程哪一次需要重试。
换成工单抽取,准确率相同后该看什么
作者又做了一轮更接近业务形态的测试:从 20 张支持工单中,每张提取 5 个字段,共检查 100 个单元格。
三个模型全部答对,准确率没有拉开差距,耗时却明显不同:
- Sonnet 5.5 用时 7.5 秒。
- GPT-6.1 Sol 用时 29.3 秒。
- Sonnet 4.6 用时 37.9 秒。
比较最快和最慢的两个结果,每轮差 30.4 秒。如果每天运行 10,000 轮,累计耗时差超过 84 小时。
这里要区分累计耗时和业务等待时间。并发执行可以改变任务完成的墙钟时间,费用也取决于计费方式,不能直接把 84 小时理解成用户每天多等的时间。
作者因此偏向用 Sonnet 5.5 处理严格长度或格式约束的任务,把 Sonnet 4.6 留给后续会人工编辑的文本。这个取舍符合展示出来的结果,但 20 张工单仍然太少,无法覆盖缺失字段、含糊表达和复杂内容。
测试还仅限短输入的单轮文本,没有涉及长上下文、多轮对话、Tool 调用和图片。三个模型标示的上下文窗口分别为 200K、1M 和 922K Token,这些容量没有在实验中得到检验。
我的判断
我认同作者把「重复运行」放进选型流程。程序需要稳定满足验收条件,一次漂亮答案提供的信息太少。不过,五次测试只能暴露部分问题,不能证明某类错误已经稳定到足以推广为模型特性。
对限制长度的任务,作者反对只靠 Token 上限硬截断,这一点成立:Token 数不等于字符数,截断还可能留下半句话。但 Schema 不能和硬截断混为一谈。按实际字符规则校验长度,再触发改写,是另一种流程设计;原文没有比较这些方案。
「偶发错误只需 Retry」则证据不足。没有可靠的校验器,自动重试可能只是换一个答案。作者也没有测量重试后的恢复率和新增费用。
费用结论同样要留在具体任务内。原文一处称 Sonnet 5.5 是三者中调用最便宜的选择,却又给出最低 0.0033 美元、5.5 为 0.0047 美元的数据,文字口径没有解释清楚。能确认的是,本次测量里 Sol 比 5.5 贵约 5.6 倍。
这是一份有用的选型实验记录,还不足以成为通用模型排名。
能拿来做什么
- 给现有 AI 流程整理一组带明确验收条件的任务,每题重复运行,分别记录答案错误、格式违规和请求失败,避免只凭一次演示选模型。
- 在前端文案或 Node 文本处理流程中,按业务实际采用的字符计数规则检查长度;超限后要求改写,并记录需要返工的比例。
- 对工单字段抽取这类任务,同时记录字段正确率、耗时和单次实际费用。输入输出 Token 单价只能作为预算起点。
- 使用 AI 编程助手时,把代码能否运行、检查能否通过纳入验收。原文的 4 道编码和改写任务没有进入准确率,不能拿这份成绩推断编码能力。