Kubernetes 1.34补丁支持到期提醒
材料称Kubernetes 1.34于2026年10月27日结束补丁支持,生命周期外补丁仅属特殊例外。文章建议小型平台团队先盘点集群版本,再验证目标版本与现有清单的兼容性,并安排升级窗口。
AI 深度解读
Kubernetes 1.34 的维护期限,按原文给出的日历,止于 2026 年 10 月 27 日。到期后,集群不会自动停机,但团队不能再指望上游按常规流程提供安全更新和缺陷修复。真正需要安排的是升级验证,以及停止维护后由谁接手风险。
这篇文章的价值在于把版本生命周期变成了几项具体工作:盘点集群、选择目标版本、验证部署配置、预约变更窗口。不过,它提供的是维护政策和操作建议,没有团队升级实测;几个版本细节也需要带着问号读。
到期停止的是维护承诺,集群仍会继续运行
原文将一个 Kubernetes 次版本的支持周期拆成约十四个月:前十二个月常规修补,最后两个月进入维护模式(maintenance mode),之后结束生命周期(EOL)。
维护模式已经收紧了修复范围。只有分配了 CVE 编号、由 Security Response Committee 提供意见的漏洞,依赖问题及基础镜像更新,以及关键核心组件问题,才可能促成额外发布。其他缺陷,即使影响使用,也可能只能通过升级版本解决。
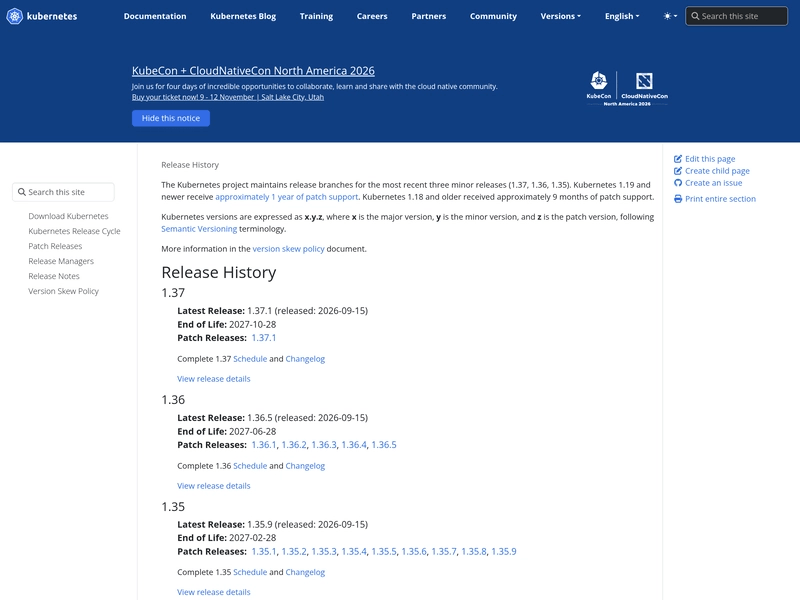
按原文记录,1.34 的最新补丁是 2026 年 9 月 15 日发布的 1.34.12,EOL 日期为 2026 年 10 月 27 日。到期后不久,向 release-1.34 分支拣选并回移修复提交的流程会关闭,常规补丁发布也随之停止。
服务还能运行,与版本仍有人维护,是两回事。
这里还有一个容易忽略的后果:停止维护不只是少修几个 Kubernetes 自身的 bug,也会影响依赖和基础镜像。仍在维护的分支,可以通过重新构建吸收底层系统库修复;分支关闭后,上游不再承诺继续提供这些构建。
镜像留在仓库里,扫描器仍会报告其中存在的问题。若团队继续使用,就需要明确由谁评估漏洞、准备替代镜像或安排升级。更新业务 Node 镜像,不能替代集群组件自身的维护。
选择目标版本,要一起看剩余寿命和升级路径
原文引用的是 2026 年 10 月 23 日的发布页快照,列出了以下版本:
| 分支 | 快照中的最新补丁 | 补丁发布日期 | 维护截止日期 |
|---|---|---|---|
| 1.34 | 1.34.12 | 2026-09-15 | 2026-10-27 |
| 1.35 | 1.35.9 | 2026-09-15 | 2027-02-28 |
| 1.36 | 1.36.5 | 2026-09-15 | 2027-06-28 |
| 1.37 | 1.37.1 | 2026-09-15 | 2027-10-28 |
更早的 1.33 已于 2026 年 6 月 28 日结束维护,最后补丁为 1.33.13;1.32 于 2026 年 2 月 28 日结束维护,最后补丁为 1.32.13。
这些数字的用途,是帮助团队估算下一次升级还剩多少时间。假如从 1.34 迁到 1.35,按文中日历,下一次维护截止日期就在 2027 年 2 月 28 日。兼容性验证可能更容易,但剩余窗口也更短。目标越新,留给后续维护的时间可能越长,需要验证的中间变化也越多。
作者建议,从 1.34 迁向 1.37 时,顺序阅读三个中间版本的发布说明,清理后续版本删除的用法,并在最终目标版本的预发布集群验证 manifests,也就是声明资源配置的 YAML 文件。
这里不能推出「可以直接从 1.34 跳到 1.37」。原文没有交代控制面、节点或具体发行版允许的升级跨度,也没有给出升级命令。最终版本的配置验证,与实际升级顺序,是两项都要确认的工作。
对挂载持久卷的集群,作者特别提出检查 Kubernetes v1.37 的卷相关变化,但没有说明具体改了什么。因此,这只能作为检查发布说明的提醒,不能直接当作兼容性结论。
停更后可能补发,但不能把例外写进计划
原文列出了三次 EOL 之后补发补丁的记录:
- 1.26.15 于 2024 年 3 月发布,通过更新 Go 处理多个 Go CVE。
- 1.25.16 于 2023 年 11 月发布,修复 CVE-2023-5528。
- 1.24.17 于 2023 年 8 月发布,修复 CVE-2023-3676 和 CVE-2023-3955。
它们说明,维护截止日期并不代表项目从此绝无可能处理该分支。语言工具链或集群自身出现严重漏洞时,项目仍可能决定破例。
但是否补发,由项目判断风险后决定,没有固定时间,也没有必然承诺。不能因为过去补过,就默认下一次严重漏洞也会有人兜底。
作者给小型平台团队的方案很朴素:从 API 获取所有集群的版本清单,选定一个目标版本验证配置,再把变更排进月度补丁日历。执行时逐个集群升级,完成后记录集群实际报告的版本。
这套流程的作用,是让下一次 EOL 提前出现在日历里。月度补丁日历也只是计划参照,原文明确说发布时间可能因修复严重程度变化,关键问题还可能触发计划外发布。预订窗口之后,仍需确认最终使用哪个补丁版本。
我的判断
我认同作者把版本维护当作持续工作来安排。对运行在 Kubernetes 上的前端服务和 Node 服务,应用发布成功,只能说明这次业务部署完成,不能说明承载它的集群仍处于支持期。版本清单、截止日期和升级负责人值得放进同一份记录。
但这篇文章没有升级耗时、失败率或版本之间的对照数据。「选一个目标版本」「贴着月度补丁窗口升级」都是流程建议,不能当作已经证明成本最低的方案。团队还要考虑预发布环境是否足够接近生产,以及存储、网络组件能否同步验证。
原文自身也有两处口径不够清楚。它一边说项目同时维护三个分支,一边在 2026 年 10 月 23 日的快照中,列出尚未到期的 1.34,以及 1.35、1.36、1.37,没有解释维护模式分支是否另行计数。它还说通常选每月 28 日作为日期,却给出 1.34 的截止日为 27 日,没有解释这个差异。具体操作应核对目标分支的发布记录。
此外,上游停止维护与云厂商停止支持未必是同一件事。原文没有覆盖托管 Kubernetes、发行版或商业延长支持,不能把上游日期直接当成供应商合同里的期限。
能拿来做什么
- 如果你参与维护前端或 Node 服务所在的集群,就从 API 导出实际版本,并补齐负责人、部署方式和支持截止日期,让升级任务有明确归属。
- 为选定目标版本准备一次预发布验证,检查部署 YAML 中的废弃用法;涉及持久卷时,再单独核对存储变化,不要只看应用能否启动。
- 把升级排进现有变更日历,同时确认允许的升级顺序、目标补丁版本和回退安排;每个集群完成后,用实际报告的版本更新清单。
- 遇到停更分支的镜像告警时,先分清问题属于业务镜像还是集群组件,再确定处理人,避免把等待上游例外补丁当作修复方案。