25个真实缺陷测试低价模型修复能力
作者在13个开源项目的25个真实缺陷上比较Claude模型,每个缺陷运行三次;Haiku与Opus分别完成52次和54次干净修复,前者成本据称低约95%。Opus在较难缺陷上更少破坏其他测试,而报告遗漏的边界情况仍会让多个模型共同失误。
AI 深度解读
Claude Haiku 5.5 能不能承担日常修 bug?作者把 Haiku、Sonnet 和 Opus 放进 25 个真实缺陷里,各跑三次:Haiku 和 Opus 分别拿到 52、54 次完整修复,前者成本约低 95%。这个结果支持先用便宜模型处理一部分任务,但还不足以证明两者能力相当。
对前端和全栈开发者,更有用的发现是:模型可能修好了报告里的例子,却漏掉相关场景,甚至破坏已有行为。选模型之外,怎么定义「修好了」,更值得花时间。
52 比 54,究竟是在什么条件下跑出来的
作者选了 13 个开源项目在 2026 年 8 月至 10 月修复的 25 个 bug,涉及 js-yaml、marked、zod 等 JavaScript 库,也包括 cachetools、Python-Markdown 等 Python 项目。
每次从上游修复前的提交开始,依赖提前装好,移除 Git 历史,避免代理直接查到补丁。输入只保留故障现象、复现方式和预期行为,删掉原因分析及修复建议。
运行环境统一为 Claude Code 2.1.295,使用 headless 模式,effort 为 medium。代理可以读写文件、运行项目测试,但不能安装依赖或联网。每个模型对每个 bug 跑 3 次,共 225 次。
评分也没有采用模型自己的说法。作者只保留库源码改动,丢掉代理新增的测试,再用维护者为该修复编写的测试和项目原有测试验收。新增用例全部通过、旧测试没有被破坏,才算一次「完整修复」(clean fix)。
这次比较衡量的是通过维护者验收的修复,而非模型能否消除一个报错。
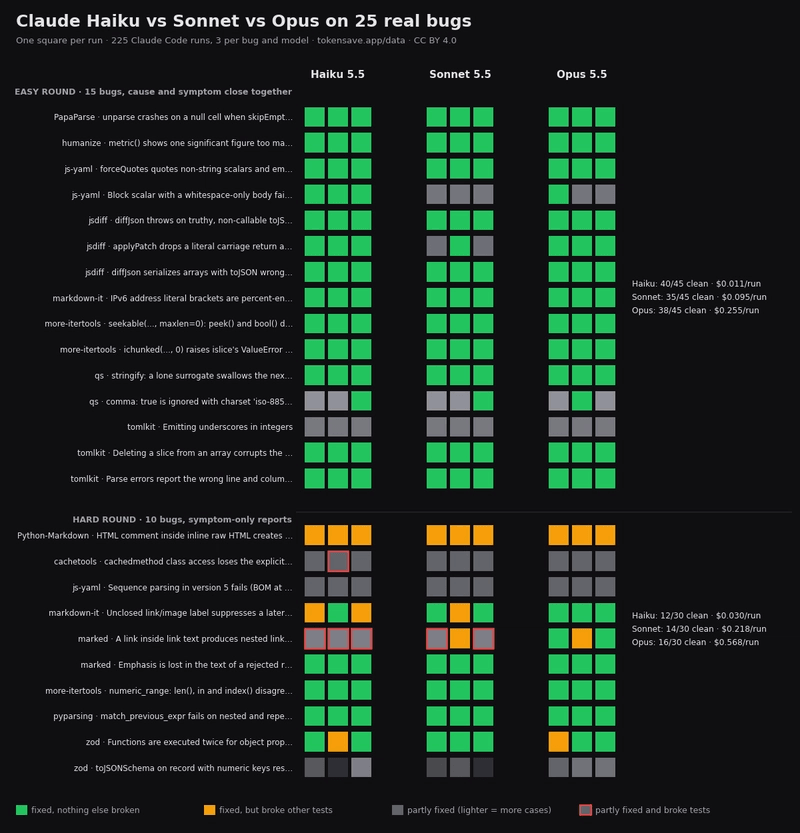
25 个 bug 中,Haiku 与 Opus 在 22 个上的完整修复次数完全一致。但这里的「一致」也可能是一起失败,不能理解成共同解决了 22 个 bug。
Opus 的优势,更多体现在少弄坏别处
作者把样本分成两轮:15 个简单 bug 的原因接近症状;10 个困难 bug 只暴露症状,根因往往藏得更远。
三个拉开差距的例子很具体:
- marked 的链接文本嵌套链接问题,Opus 完整修复 2/3 次,Haiku 为 0/3;Haiku 每次都破坏了对应示例的规范测试。
- markdown-it 的未闭合链接标签遮蔽代码片段问题,Opus 为 3/3,Haiku 为 1/3;Haiku 另外两次修好目标问题,却破坏了两个相邻测试。
- js-yaml 的块标量正文只有空白字符时,Haiku 为 3/3,Opus 为 1/3,Sonnet 为 0/3。
所以,价格更高并不保证每类问题都占优。Opus 在困难轮次里更稳的证据,是破坏其他测试的运行次数为 5 次,Haiku 为 10 次。
另一个 zod 缺陷需要在 JSON Schema 输出的多个位置处理数字记录键,三个模型都没完整解决。作者报告的跨三次运行用例通过数,Opus 为 14/24,Haiku 为 9/24,Sonnet 为 5/24。这能提示局部修复能力有差别,但仍不能算交付成功。
报告没写到的场景,三个模型一起漏了
困难轮次里,有三个 bug 的所有运行都出现了同一种问题:处理了报告中的情况,却没覆盖维护者补充验证的情况。
cachetools 的报告只展示了一种通过类调用缓存方法的方式,维护者还检查了其他装饰器变体,所有模型都漏了。js-yaml 的报告提到文件开头的 BOM,维护者还测试了多文档流中每个文档前的 BOM,也没有模型处理完整。
Python-Markdown 更典型:每次都修复了报告中的 HTML 注释,却破坏了其他行内 HTML 后注释的 3 至 5 个维护者测试。
作者据此认为,升级模型没有补回这些遗漏,阅读维护者测试更有用。不过要分清实验条件:代理可以运行项目测试,维护者针对修复新增的测试用于事后验收。原文没有展示「提前给出完整验收测试」的对照实验。
复现步骤描述的是一个已知失败入口,未必覆盖修复需要守住的全部边界。
我的判断
我赞同把便宜模型作为部分任务的起点,但不赞同把这组结果概括成「Haiku 已经等于 Opus」。
总体完整修复率的 Fisher 精确检验为 p = 0.86;按整个 bug 重采样,Haiku 减 Opus 的差值,其 95% 区间是 −11 至 +5 个百分点。没有检出差异,也仍然排除不了约 10 个百分点的差距。只看困难轮次,区间扩大到 −33 至 0 个百分点,10 个 bug 很难支撑稳定结论。
唯一明确显著的差异,是 Sonnet 总体通过的测试用例比例低于 Opus,配对置换检验 p = 0.006。作者估计,要验证两模型差距在 ±10 个百分点以内,需要每个模型在不同 bug 上运行数百次。
「约便宜 95%」是本次实验结果。原文没有给出包含人工审查、返工的总成本对照,也没有足够信息把这个比例直接套到一般团队。
实验还存在具体限制:tomlkit 的复现报告由作者根据上游 issue 补写,所有运行都只通过同样的 20/29 个用例;Windows 下 zod 的 CLAUDE.md 符号链接未解出,相关运行缺少项目指令;计时测试因负载下随机失败而未计入破坏项。项目公开,也无法排除模型训练时见过相似代码。
作者经营发布这些测量的 TokenSave,并声明没有 Anthropic 的支持或额度。这些结果适合形成选型假设,尚不足以成为通用排名。
能拿来做什么
- 给前端或 Node 依赖库修局部 bug 时,可以先用 Haiku 尝试,并以新增回归用例和原有测试共同验收;「原因接近症状」仍是作者的经验归纳。
- 遇到解析器、序列化输出或需要改动多个位置的问题,可以优先考虑 Opus。此次困难轮次中,它破坏已有测试的次数更少,但仍需要审查。
- 写 AI 修复任务时,除了复现步骤,还应列出关联调用方式、输入变体及邻近语法。报告中的单个示例不适合作为唯一验收标准。
- 把审查时间留给边界和回归。困难轮次中,各模型有 47% 至 60% 的运行未达到完整修复标准,模型给出补丁只是验收的开始。