对账 Agent 实测:高价模型未显优势
作者用含十处陷阱的合成财务数据测试三个模型,报告称三者均完成正确对账,Fable 成本最高且耗时最长。测试预先提交提示词、答案和评分代码,并保留运行日志,但结论仅覆盖该任务。
AI 深度解读
同样一笔月末对账任务,Claude Fable 5.1、Opus 5.5 和 Sonnet 5.5 都算对了,价格和耗时却拉开了差距:小规模测试中,Sonnet 的单次成本中位数为 $0.087,Fable 为 $0.70,接近 8 倍。
RanThis 的这组测试值得程序员看,不只是因为便宜模型打平了贵模型。它更具体地展示了:工具怎么调用、对话跑多少轮、缓存如何计费,以及输出能否被程序解析,都会影响 Agent 的实际可用性。不过,这仍是一组人工数据上的小样本实验。
三个模型到底完成了什么任务
作者让模型替一家小型代理公司完成 10 月对账,输入是三份 CSV:包含 9 月和 10 月记录的发票表、10 月银行流水,以及银行卡收单报告。模型需要回答十个问题,包括未结清发票数量、应收总额、多付款项、在途结算款、手续费、最大欠款客户,以及无法匹配发票的银行入账。
数据中藏了十类陷阱:备注栏里的部分贷项通知、已取消发票、扣除电汇手续费后少付的三笔跨境转账、把数字零写成字母 O 的付款编号、一笔转账支付两张发票、部分付款、重复付款后已退款、重复付款但未退款、周五生成而周一才到账的结算款,以及没有对应发票的公司入账。
贷项通知可以理解为对原发票金额的冲减。难点不只是加减,而是先判断哪些金额应该算进去。
模型不能一次看到整份文件,只能使用三个工具:list_files 列出文件,read_file 每次最多读取 25 行,calculate 做精确十进制计算。Agent 循环持续运行,直到模型不再请求工具。
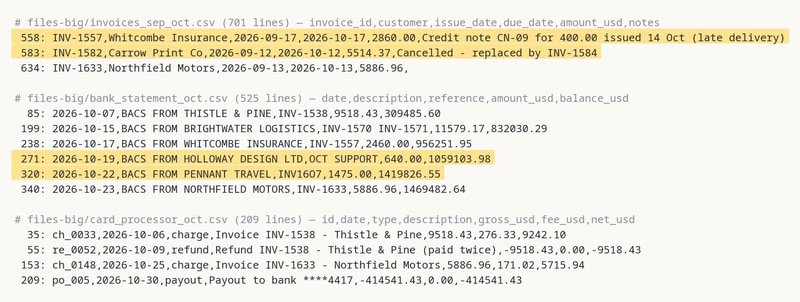
第一轮有 140 张发票,三个文件合计约 300 行,至少需要读取 13 次。结果全部算对后,作者再封存第二轮题目:700 张发票、约 1,430 行,至少读取 58 次,并把陷阱记录移到文件深处。
作者称,提示词、答案和评分代码都在调用模型前提交,测试通过 Python 脚本于 2026 年 10 月 28 日运行。评分由代码完成,每题一分,金额精确到分,回复必须解析为一个 JSON 对象。日志显示,每次运行都读完了三个文件,没有跳页。
这次测试证明的是三个模型都能完成这套任务,无法据此排出通用能力高低。
成本为什么能差到八倍
测试使用 claude-fable-5-1、claude-opus-5-5 和 claude-sonnet-5-5,均采用默认配置,没有显式设置 effort 或 thinking。
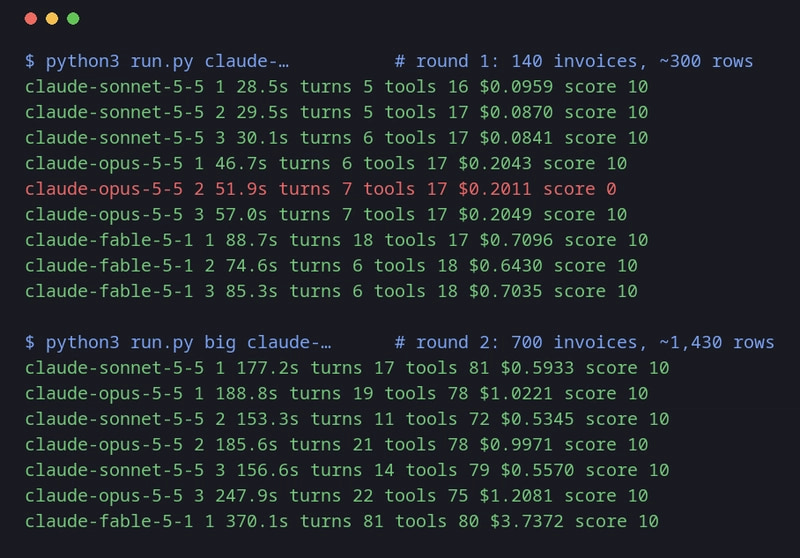
第一轮每个模型运行三次,第二轮 Sonnet、Opus 各运行三次,Fable 只运行一次。原文报告如下:
| 模型 | 第一轮成本中位数 | 第二轮成本中位数 | 第一轮耗时 | 第二轮耗时 |
|---|---|---|---|---|
| Sonnet 5.5 | $0.087 | $0.56 | 30 秒 | 2.6 分钟 |
| Opus 5.5 | $0.20 | $1.02 | 未提供 | 未提供 |
| Fable 5.1 | $0.70 | $3.74,仅一次 | 85 秒 | 6.2 分钟 |
差距有两层来源。第一层是单价。按原文列出的每百万 token 价格,Fable 的输入、输出、缓存读取分别为 $10、$50、$0.25;Opus 为 $4、$20、$0.20;Sonnet 为 $2、$10、$0.10。缓存写入按输入价格的 1.25 倍收费,输出费用包含 thinking tokens。
第二层是工具调用方式。Sonnet 和 Opus 会规划读取,一轮请求 8–10 页;Fable 在四次有日志的运行中,有两次逐页读取。第二轮 Fable 发起了 80 次工具调用,经历 81 轮模型交互,其他模型完成同样任务用了 11–22 轮。
工具调用次数和模型交互轮数不是一回事。一轮提出多个读取请求,可以减少后续往返;但原文没有说明这些请求是否真正并行执行。
每轮请求又会带上整段对话,历史内容不断增长。第二轮 Fable 累计重新读取了 380 万缓存 token,Sonnet 和 Opus 的中位数分别约为 60 万、80 万。
缓存把账单压了下来,却没有消除长循环的代价。Fable 这 380 万 token 按缓存价约为 $0.94,按完整输入价则约为 $38。作者估算,不使用缓存时,该次运行的总费用约为当前的十倍。
两轮英文测试总计 $11.58,其中第一轮 $2.93,第二轮 $8.65。另有一次 Opus 运行被 shell 超时打断后重跑,中断部分的费用没有计入。
算对数字,为什么仍可能交付失败
第一轮 Opus 的一次运行先返回九个字段的 JSON,随后发现遗漏,又补发一个完整的十字段 JSON。第二个对象里的答案全部正确,但评分程序只接受一个对象,于是整次运行记零分。
这对接入 Node 服务或自动化脚本的开发者很直接:业务答案正确,仍可能因为输出格式不符合约定而失败。
另外,提示词要求「只输出一个 JSON 对象」,Fable 和 Opus 却经常附加说明。这些说明对人工复核有价值,但也暴露了两个需求之间的冲突:程序需要稳定结构,人需要知道模型做了哪些判断。
例如,三笔电汇手续费造成的少付款,到底继续计入应收,还是作为费用核销?作者的答案将它们视为客户仍然欠款。Opus 在第二轮说明,如果核销这三笔差额,未结清发票会降至 111 张,应收总额变为 $527,322.32。
这是业务口径,不能只靠算术决定。同一测试的越南语版本中,Sonnet 三次运行有两次选择核销,因此各丢两分,并在备注里说明了原因。
模型对自身行为的描述也需要核对。Sonnet 第二轮提醒自己是手工加总,可能漏读,但日志显示它实际调用了 21 次计算工具。解释可以辅助审阅,执行记录才适合用来确认它做过什么。
我的判断
我认可作者的选型顺序:先让便宜模型跑真实任务,再根据失败证据升级。这个实验里,Sonnet 已经达到答案要求,Fable 增加的成本没有换来可观察的准确率收益。
但标题里的「八分之一成本」只对应第一轮;第二轮约为七分之一,而且 Fable 只有一次运行。作者认为再跑两次约增加 $7.50,结论也不会改变。省下实验费可以理解,但单次结果无法提供稳定性范围。
测试也没有覆盖真实银行格式、缺失数据、模型自行打开文件、Claude 应用,包括 claude.ai 和 Claude for Excel。作者没有测试较低 effort 的 Fable,也没有测试 high effort 的 Opus 5.5。默认配置比较有实际参考价值,却不能回答各模型调优后的性价比。
此外,把文件扩大五倍,主要增加了读取负担,陷阱仍是原来的十类。准确率继续打平,可能说明任务的判断难度已经不足以区分模型,不能推出复杂任务也会打平。
与先用规则或程序完成匹配、再把疑难项交给模型相比,原文没有提供对照数据,因此也无法证明整套对账都交给 Agent 更划算。作者认为 Opus 的判断说明最清楚,这同样是小样本中的观察,没有独立的解释质量评分。
能拿走的是一套评测思路,而不是一张长期有效的模型排名。
能拿来做什么
- 给文件处理类 Agent 建一份固定评测集,提前写好标准答案和金额容差,并把业务正确性与输出可解析性分别记录,避免一次格式错误掩盖全部结果。
- 在 Node Agent 循环中同时记录工具调用次数、模型交互轮数、缓存 token、耗时和实际费用。对能够独立读取的分页,检查是否可以一轮请求多页,再用日志确认效果。
- 将结果和判断依据放进约定好的结构,例如分别保存应收金额、核销选择和异常记录;接收端校验完整响应只能解析为一个 JSON 对象,再进入后续流程。
- 从 Sonnet 或 Opus 开始测试团队自己的任务,加入缺字段、编号错误和业务口径冲突等真实案例。只有当前模型出现可复现失败,才升级模型或调整 effort,并重新比较准确率与成本。