Claude Code 长会话仍需管理成本与细节
文章区分上下文窗口容量与使用额度,指出窗口扩大并不意味着长会话没有成本。结合 Claude Code 文档讨论历史上下文的费用、自动压缩可能丢失细节,以及长会话和模型选择导致的意外支出。
AI 深度解读
Claude Code 很少撞满上下文窗口,为什么额度还是用得快?作者的回答是:窗口装得下,不代表携带这些内容免费;自动压缩能继续对话,也可能丢掉关键细节。真正要管理的是输入、输出、缓存和任务边界。
这篇值得读的地方,是把「省 token」落到了日常操作:规则文件怎么拆、MCP 怎么选、何时清空会话,以及哪些信息必须写进文件。不过,文中的价格和模型规则要按原文口径看,作者的个别实验也不能直接当成团队收益承诺。
窗口够大,为什么还会用完额度
原文先区分了两件事:上下文窗口决定一次能处理多少内容,使用额度决定还能消费多少计算资源。作者引用的 GitHub 问题「Instantly hitting usage limits with Max subscription」已有 1,499 条评论,但额度耗尽不等于窗口装满。
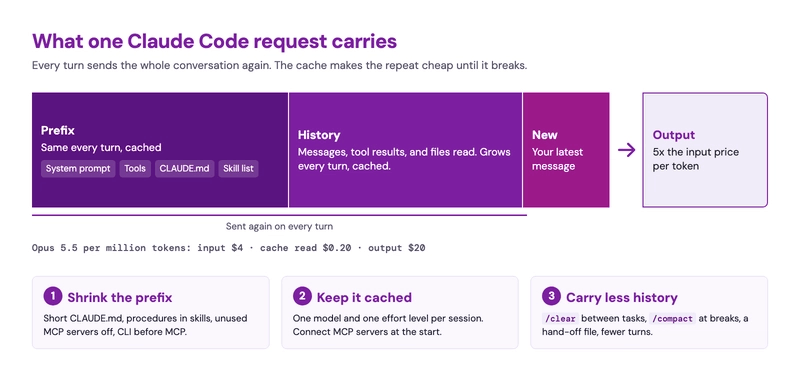
模型调用通常不保留上一次请求的内部状态。你看到的是连续聊天,模型收到的则是当前请求携带的历史材料,包括消息、读过的文件、工具结果、规则和工具定义。
Claude Code 的请求可以分成三部分:相对稳定的前缀、不断增长的历史、最新输入。随后产生输出。按原文列出的价格,Claude Opus 5.5 输入为每百万 token $4,输出为 $20,相差五倍;缓存读取为 $0.20,只有普通输入的 5%。
省钱不能只盯着上下文长度,还要看缓存是否命中,以及模型生成了多少内容。
作者称,订阅套餐额度内的主会话缓存保留一小时,API key 或 usage credits 场景保留五分钟。切换模型、增减 MCP server、间隔超过缓存寿命,都可能让后续请求重新支付处理费用。压缩则会破坏会话历史部分的缓存,系统提示和项目上下文可能继续命中。
长输入还可能影响质量。作者引用 Chroma 在 2025 年 7 月对 18 个模型的测试:输入变长时,可靠性会下降。但他也承认,那是 2025 年的模型,只能提供方向,不能据此推算当前模型的准确率。
先用 /context 看窗口被什么占据,再用 /usage 看消耗,比凭感觉删提示词更有用。
每轮都要带的东西,应该尽量少而稳定
作者把常驻规则拆进三个文件:~/.claude/CLAUDE.md 放全局习惯,./CLAUDE.md 放项目事实,./CLAUDE.local.md 放不进 git 的私人备注。原文引用的建议是每个文件控制在 200 行以内。
这里的重点不是凑行数,而是减少无关要求。提交规范可以常驻,偶尔执行的长流程适合放进 skill:启动时只加载名称和描述,使用时才读取完整 SKILL.md。必须强制执行的限制,则应交给 hook 或 deny rule,不能指望多写几个「IMPORTANT」解决。
MCP 也要区分加载成本和选择成本。Claude Code 现在默认延迟加载工具定义,但工具太多仍会增加选错的机会。原文引用的工具搜索文档称,超过 30 至 50 个工具后,选择准确性会下降。作者在 2026 年 11 月测过一个含 39 个工具的服务,按字符数除以四估算,定义约占 34k tokens;这只是粗估。
他的做法是按项目配置:claude mcp add 默认使用 local scope;--scope user 留给每天跨项目使用的服务;--scope project 写入团队共享的 .mcp.json。其余通过 /mcp 或 disabledMcpServers 关闭。
作者个人偏好 CLI 优先,因为 gh、aws、gcloud 不增加 MCP 工具列表。但命令输出照样进入历史。把 10,000 行日志先过滤成错误片段,通常比让模型逐行读更直接;托管 MCP 的免安装和跨客户端访问便利,也有实际价值。
缓存要求稳定前缀。下面这段 API 示例解决的是:把不变的风格指南标记为可缓存内容。
import anthropic
client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    system=[
        {
            "type": "text",
            "text": open("style_guide.md").read(),  # 内容较大,保持不变
            "cache_control": {"type": "ephemeral"},  # 长间隔可加 "ttl": "1h"
        }
    ],
    messages=[{"role": "user", "content": "Review this paragraph: ..."}],
)
usage = response.usage
print("written to cache:", usage.cache_creation_input_tokens)
print("read from cache:", usage.cache_read_input_tokens)
重点看 cache_control 和 cache_read_input_tokens:按原文说明,五分钟内执行两次,第二次应看到缓存读取。前缀必须逐字节一致,改动会影响后续部分的命中。
作者默认使用 Sonnet、medium effort,复杂规划才用 Opus。这里有个容易混淆的地方:effort 是思考投入的行为信号,max_tokens 才是输出硬上限。原文也指出部分新模型切换 effort 默认保留缓存,因此「会话中任何设置都不能改」应理解为保守习惯,不能当成所有设置的统一机制。
/compact 能续聊,文件才能可靠交接
/compact 会总结当前会话,适合同一任务中的自然停顿;/clear 清空对话,适合切换任务。压缩有两笔代价:生成摘要需要计算,摘要还会丢信息。
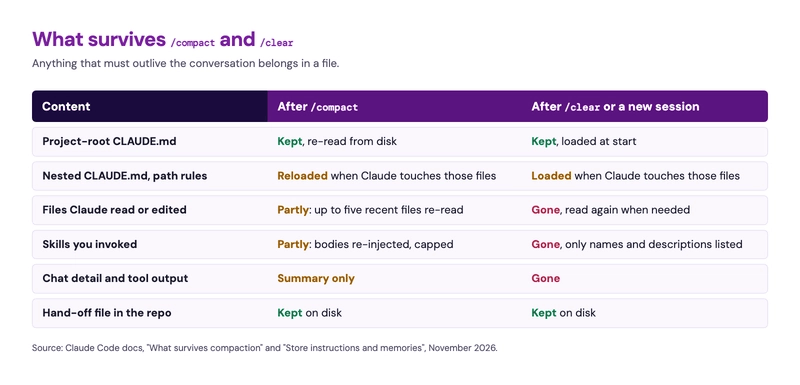
按原文描述,压缩后 Claude Code 会重新读取项目根目录的 CLAUDE.md、最多五个近期文件,并在容量限制内恢复 skill 正文。工具输出和粘贴进聊天的细节,只能依靠摘要保留。
作者引用过一个案例:开发者贴入的标记代码在压缩后丢失,Claude 随后开始猜测选择器。这不是大规模实验,却揭示了明确风险:模型还能继续工作,不代表它仍拿着原始材料。
必须准确保留的规格、报错和决策,应当写进文件。
作者使用 HANDOFF.md 记录目标、已完成内容、未解决问题、决策依据、禁止修改范围和下一条验证命令。清空或关闭会话前更新它,新会话再读取。文件能重新读取,也能人工核查;一句「记住前面的要求」没有这种可靠性。
自动压缩也不只发生在窗口快满时。原文称,一小时缓存场景下,超过约 200K tokens 的空闲会话,也可能在缓存到期前压缩。可用 /autocompact 500k 调整提前压缩阈值,通过 /config 或 DISABLE_AUTO_COMPACT=1 关闭自动压缩,手动 /compact 仍可使用。
作者还建议,两次纠正都失败后,执行 /clear 重写任务描述。/clear oauth-migration 可以给旧会话命名,随后用 claude --resume <name> 恢复;claude --continue 则重开最近会话。不过,缓存过期后恢复完整历史,也会重新产生处理成本。
我的判断
我赞同把任务边界和文件交接放在前面。这比单纯追求大窗口更适合代码维护:原始证据可读取,当前目标清楚,下一步也能验证。
但「短会话更好」「medium 往往够用」主要是作者经验,原文没有给统一任务、统一质量标准下的对照数据。跨模块重构可能确实需要较长历史,频繁清空后重新探索,也未必划算。
子代理同样不能自动等同于省钱。作者一次让四个子代理各抓一页,模型用量花了 $3.81;另一次主会话通过一次批量 CLI 调用抓取 12 页,另外支付 Zyte API 费用。两次工作量和费用口径不同,能支持「先考虑批处理」,还不足以证明批处理总比并行代理便宜。
原文最初发布于 Zyte,也推荐 Zyte MCP。其产品页抽取结果曾比原始 HTML 小 29 倍,筛成七个字段后小 77 倍,另一页约小九倍,但统计的是字符数。方法值得借鉴,具体倍数取决于页面,不能直接换算成 token 或账单降幅。
能拿来做什么
- 下次修前端或 Node 问题时,先提供明确目标、相关文件路径和复现命令。
@引用会直接加载文件,默认上限为 25,000 tokens,应只引用当前需要的文件。 - 把冗长日志、DOM 片段和接口规格保存到文件,再让代理按需读取;选择器和字段名这类细节尤其不该只留在聊天摘要里。
- 对重复执行的检查生成脚本,对互不依赖的读取合并下达。先减少重复劳动,再决定是否需要子代理。
- 任务结束前写好交接文件,再清空或新建会话;同时用
/context、/usage检查规则、工具和历史中谁占得最多,据此调整。