用环境变量降低 Claude Code 探索成本
作者通过 205 次无界面会话测试发现,Claude Code 从 2.1.198 起让 Explore 子智能体沿用主会话模型。设置 CLAUDE_CODE_SUBAGENT_MODEL=haiku 和 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1 后,测试中探索成本下降约 60%,且获得相同答案。
AI 深度解读
Claude Code 的 Explore 子代理,可能已经不再使用你以为的便宜模型。作者测试了 26 个版本、205 次无头会话,发现从 2.1.198 起,Explore 会跟随主会话使用的模型;主会话用 Opus,代码搜索也跟着用 Opus,单次费用从 $0.18 涨到 $0.37。
作者用两个环境变量把 Explore 切回 Haiku,在配置实验中省下 60% 费用,并找到了相同答案。但这个配置会影响所有子代理,是否适合直接照搬,要看你把哪些工作交给了它们。
为什么一次代码搜索会贵一倍
此前有人观察到,Claude Code 内置的 Explore 子代理固定使用 Haiku。作者却在 2.1.318 中发现,Opus 主会话发起的 Explore 调用全部使用 Opus。
两种观察都可能成立,区别在版本。
作者先检查了从 2.1.0 到 2.1.318 的 18 个版本,再对中间的 npm 版本做二分定位,最终把变化点锁定在:
- 截至 2.1.197,测试中的 Explore 全部使用 Haiku。
- 从 2.1.198 起,Explore 使用与主会话相同的模型。
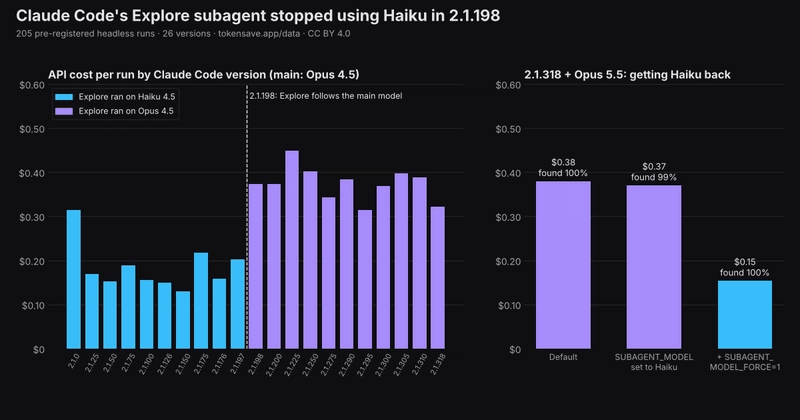
在作者的 Opus 实验里,一次委派代码搜索的费用从 $0.18 增至 $0.37,涨幅为 105%。这里的关键是:你没有主动升级搜索模型,客户端默认行为的变化,也可能让相同工作变贵。
版本历史实验固定使用 Opus 4.5,因为低于 2.1.280 的客户端会被 API 拒绝使用 Opus 5.5。这也是复现实验时不能省掉的条件。
两个变量怎么配,为什么少一个不行
作者在 2.1.318、Opus 5.5 下,对 12 道问题各运行 3 次,比较三种设置。结果是:只设置 CLAUDE_CODE_SUBAGENT_MODEL=haiku,对 Explore 没有效果。
按照原文引用的文档解释,这个变量只提供默认值。要把指定模型应用到每个子代理,还需要 2.1.257 起支持的 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1。
下面这段配置可以放进 settings.json,用于同时指定模型并强制应用:
{ "env": { "CLAUDE_CODE_SUBAGENT_MODEL": "haiku", "CLAUDE_CODE_SUBAGENT_MODEL_FORCE": "1" } }
要看清第二个变量:FORCE 会作用于所有子代理,范围超过 Explore。
两项同时开启后,Explore 在 36 次运行中全部回到 Haiku,费用下降 60%,并找到了相同答案。这个 60% 来自配置对比实验,前面的 105% 来自版本变化对比,不应把两组百分比当作同一笔账互相换算。
文档还提到另一条路:定义一个名为 Explore、包含 model: haiku 的项目子代理。作者没有测试,不能把它当作本文已验证的替代方案。
这组实验能证明什么
作者让 Claude Code 在 undici、fastify、cachetools、Python-Markdown、anyio、zod 等开源仓库中回答「找出所有相关位置」的问题,并明确要求使用 Explore。
执行方式是无头命令 claude -p,限制只读工具,保存 stream-json 日志。模型身份来自子代理自己的消息,以及日志中按模型拆分的费用。相比根据主会话显示的模型猜测,这种证据更直接。
实验在 GitHub 预注册,随后有两次带日期的修订。其中一次修正了作者自己的二分脚本错误:识别 Haiku 的正则表达式无法匹配日志格式,导致最初误判变化发生在 2.1.176。查看原始日志后,作者确认 2.1.176 至 2.1.186 仍使用 Haiku,修复脚本并重新定位,错误探测记录也保留在数据中。
版本实验能证明实际调用了哪个模型,不能证明模型能力相同。
历史测试每个版本只有两道问题;配置实验的「答案相同」,也只覆盖所选题目。全部 205 次运行的模型、费用拆分、召回情况和答案按 CC BY 4.0 公开,提高了可核查性,但没有消除样本局限。
我的判断
我认同作者最有用的提醒:管理 AI 编程成本,不能只看主模型,还要看委派出去的任务实际用了什么模型。
但「搜索交给 Haiku 就够了」只能算这组实验支持的局部结论。测试来自一台机器、一个账号和固定提示方式,没有足够证据推广到复杂业务仓库,更不能推广到规划、修改代码等其他子代理任务。
直接开启全局 FORCE 的代价也在这里:搜索费用可能下降,其他子代理的模型也会一起变。项目级 Explore 配置看起来更有针对性,但本文没有验证它的行为。
作者还提到,上一轮实验中,要求使用子代理没有多找到内容,费用最高反而增加 221%。这支持先验证委派是否有价值,但不足以认定子代理普遍不划算。默认行为还可能继续变化,这份结果应当连同版本一起阅读。
能拿来做什么
- 在 Node 仓库里挑几道真实搜索题,例如找全某个 API 的调用点或配置读取位置,比较默认设置与双变量配置下的遗漏、答案和费用。
- 排查 Claude Code 升级后的费用变化时,记录客户端版本、主模型和子代理模型;需要复现时可用
claude -p与stream-json日志检查实际调用。 - 如果还把规划或复杂分析交给其他子代理,先评估全局
FORCE的影响。原文提到的项目级 Explore 配置可以另做验证,不能直接套用本文的省钱结论。