让 Agent 接收数据运维请求,工作流负责执行
作者提出将 Agent 用作数据流水线的交互入口,由确定性工作流保留执行控制权。文章以 AWS Step Functions 和 Amazon Bedrock AgentCore Gateway 为实现方向,讨论迟到数据和分区重跑等运维需求。
AI 深度解读
Agent 可以替你听懂「把昨天修正后的销售数据重跑一遍」,但不该接管加载顺序、失败重试和权限分配。作者给出的方案是:用 Amazon Bedrock AgentCore Gateway 把 AWS Step Functions 工作流开放成工具,让模型处理请求,让工作流负责执行。
这篇值得读的地方,是它把 AI 运维助手的边界讲得很具体:参数在哪里校验、权限如何限制、失败为什么可能被报成成功。对准备给现有数据平台接入 Agent 的团队,这些问题比选哪个模型更紧迫。
Agent 接手的是操作入口,不是流水线调度
作者长期维护数据流水线,喜欢它们的可预测性:给定计划、结构和步骤,每天按同一套规则运行。真正消耗人工的,往往是流水线周围的操作。
例如,Amazon S3 的文件迟到,API 临时限流,业务人员要求重跑某个分区。工程师需要确认文件、拼 JSON、启动执行、观察结果,再把状态回复给对方。Agent 很适合接住这些自然语言请求。
危险出现在下一步:为了省事,直接给模型 glue:StartJobRun、redshift-data:ExecuteStatement、lambda:InvokeFunction、s3:CopyObject 等权限。此时,步骤顺序、重试判断和执行进度都可能依赖模型上下文。一个运行 20 分钟的 Glue 作业还没结束,Agent 进程先退出,下游加载和失败通知由谁继续?
模型可以决定何时发起请求、填写什么参数,工作流必须决定执行过程。
作者使用的 MCP(Model Context Protocol)基于 JSON-RPC,通过 tools/list 发现工具,通过 tools/call 调用工具。AgentCore Gateway 用内置连接器 connectorId: "states" 暴露选定的 Step Functions 操作,生成输入 schema,并使用自己的 IAM 服务角色调用服务。按原文描述,这条路径不需要额外编写包装 Lambda。
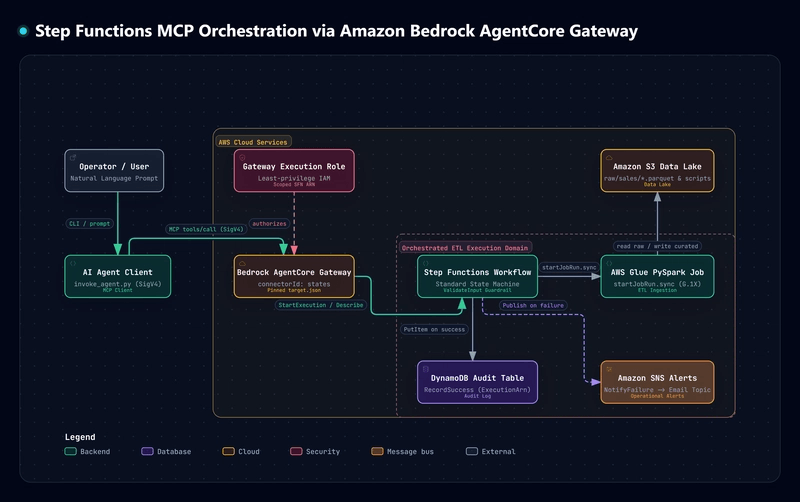
这套架构里,模型负责理解和汇报;Gateway 负责协议、身份和固定参数;Step Functions 负责状态转换、重试和失败处理;S3、Glue、DynamoDB、SNS 承担存储、计算、审计和通知。
边界能否成立,还取决于权限配置:数据服务只接受 Step Functions 执行角色的请求,Agent 不能绕过去直接操作。
一次补跑,为什么要把校验和失败状态写死
原文用修正销售文件举例:用户要求处理 raw/sales/2026-11-05/sales.parquet,Agent 把路径提取到 sourceKey,调用 StartExecution。状态机 ARN 已固定在 Gateway,模型不需要知道它。
这里有个容易漏掉的细节:StartExecution 的 input 是序列化后的 JSON 字符串。Gateway 生成的 schema 无法检查字符串内部的业务字段,所以工作流必须再次校验。
下面的 ValidateInput 在启动计算前拒绝不合要求的输入:
"ValidateInput": {
  "Type": "Choice",
  "Comment": "确保 sourceKey 已提供,且位于 raw/sales/ 前缀下并以 .parquet 结尾",
  "Choices": [
    {
      "And": [
        {
          "Variable": "$.sourceKey",
          "IsPresent": true
        },
        {
          "Variable": "$.sourceKey",
          "IsString": true
        },
        {
          "Variable": "$.sourceKey",
          "StringMatches": "raw/sales/*.parquet"
        }
      ],
      "Next": "StartGlueJob"
    }
  ],
  "Default": "FormatValidationFailure"
}
要看清 StringMatches 这一行:它检查的是路径模式,不能证明文件存在、内容正确,或该分区适合重跑。
通过后,StartGlueJob 使用 arn:aws:states:::glue:startJobRun.sync 启动 PySpark 作业并等待完成,临时错误采用指数退避重试。成功进入 RecordSuccess,向 DynamoDB 写入执行 ARN、文件路径、完成时间和状态。
失败路径尤其关键。作者明确提到自己早期草稿踩过的坑:如果 NotifyFailure 发完 SNS 通知后以 "End": true 结束,Step Functions 会认为错误已经处理,整次执行显示 SUCCEEDED。正确做法是继续进入 WorkflowFailed,用 "Type": "Fail" 结束。
Agent 拿到 executionArn 后,用 DescribeExecution 查询,直到状态离开 RUNNING;需要定位失败步骤时,再调用 GetExecutionHistory。
作者因此选择 Standard:Express 最长运行五分钟,Standard 最长一年;Standard 还支持上述执行状态与历史查询。Express 的日志异步发送到 CloudWatch,不能按同样方式提供这些查询能力。
提示词约束之外,还要锁住哪些权限
「只许运行销售流水线」写进系统提示词,仍然只是给模型的要求。原文真正依赖的是三层外部约束:Gateway 固定参数、IAM 限制资源、状态机校验输入。
首先,StartExecution、ListExecutions、DescribeStateMachine 使用 stateMachineArn。在 gateway/target.json 固定它后,Gateway 会从模型可见的 schema 中移除该参数,并在调用时注入。
其次,DescribeExecution、GetExecutionHistory、StopExecution 使用每次运行独有的 executionArn,无法提前固定,只能由 IAM 限制范围。两类资源格式不同:
- 状态机使用
arn:aws:states:<region>:<account-id>:stateMachine:<state-machine-name>。 - 执行实例使用
arn:aws:states:<region>:<account-id>:execution:<state-machine-name>:<execution-name>。
作者在 template.yaml 中把两组权限拆开,执行级权限限制到指定状态机名称下的 :*。用错 ARN 会出现一种迷惑性故障:启动成功,查询状态却报 AccessDeniedException。
Python 客户端 agent/invoke_agent.py 通过 SigV4 签名的 HTTPS 发送标准 MCP 请求。下面这段展示了启动参数:
mcp_start_request = {
    "jsonrpc": "2.0",
    "id": "req-start-1",
    "method": "tools/call",
    "params": {
        "name": "states_StartExecution",
        "arguments": {
            "name": f"sales-ingest-{uuid.uuid4().hex[:8]}",
            "input": json.dumps({"sourceKey": source_key})
        }
    }
}
注意 json.dumps:这里传的是 JSON 字符串,也就解释了为什么业务字段还要在状态机里检查。
生产环境还需要 TimeoutSeconds、Retry、Catch,记录 MCP 调用者和载荷,开启 CloudTrail 与 CloudWatch Logs,并隔离 dev、staging、production 的 Gateway target 和角色。限流、并发控制及幂等设计也不能省。截断、全量重载、昂贵集群启动等操作,作者建议通过 waitForTaskToken 回调等待人工批准。
我的判断
我认同这套职责划分。它把模型最擅长的语言转换留下,把执行正确性放回可检查的状态机和权限系统。相比直接开放底层连接器,故障后更容易回答「执行到了哪里」。
但这不是一份完整的效果验证报告。作者提供了 AWS SAM 部署结构和实现片段,没有给出与人工操作、直接工具调用方案的对照数据,也没有量化故障率和成本收益。
原文称 GPT-6.1 Terra 已在 Amazon Bedrock 正式可用,并转述了厂商对速度和成本的定位;文中没有独立测试结果。模型选择仍要用自己的请求测工具调用准确率、延迟和单次成本。
还有两个前提。第一,已有工作流得足够可靠;加上 Gateway 不会自动解决重复加载和半写入。随机执行名称也不能单独保证业务幂等。第二,Agent 仍可能对合法路径发起错误补跑,或在授权范围内错误停止执行,资源限制不能替代业务授权。
作者称常见工具循环约三到五次调用,但长任务轮询次数取决于耗时和退避策略,不能直接当成本预算。现成控制台或脚本已经够用时,自然语言入口是否值得增加一层系统,也需要团队自己判断。
能拿来做什么
- 给已有补跑流程增加 AI 入口时,先把请求压缩成明确业务参数,再调用可信工作流;不要让模型逐步拼装 Glue、S3 和仓库操作。
- 先做只读状态助手,只开放
ListExecutions、DescribeExecution、GetExecutionHistory,让业务人员查询分区是否完成,再评估启动和停止权限。 - 验收时实际触发非法路径、计算失败和重复请求,确认昂贵计算不会提前启动、失败不会显示成功,重复运行也不会破坏数据。
- 保留确定性入口:
02:00 UTC定时任务和 S3 上传触发交给 EventBridge;每秒数千事件交给 Kinesis、Kafka、Lambda 或 Express;单纯销售额查询交给 Athena、Redshift 或语义层的 text-to-SQL 工具。