两个真实 RAG 项目的检索与转人工实践
文章复盘文化媒体档案与社区教育公益机构的两个 RAG 助手项目,讨论不同内容、用户需求和风险下的检索设计。重点包括依据机构资料回答、提供来源链接,以及需要时转交人工。
AI 深度解读
给旧网站加一个 AI 聊天窗口,难点不只在模型怎么回答,还在它能找到什么、凭什么回答,以及答不上来时把用户交给谁。作者用黎巴嫩文化档案 HOMELand 和都柏林社区公益机构 CASPR 两个项目,讨论了这些更贴近上线的问题。
两个项目的共同结论是:先让回答有依据,再考虑让模型更聪明。不过,原文提供的是项目经验,没有检索准确率、人工咨询减少量或模型对照实验,效果需要分开看。
同样是问答,找文章和找服务差在哪里
HOMELand 自 2014 年开始出版,前身是 HOME Magazine,内容围绕黎巴嫩及其海外社群展开。档案有七个内容栏目:THEdiaspora、THEland、THEpeople、THEculture、THEdiplomacy、THEfuture 和 THEgood,还包括国家页面、访谈、作者资料和视频。
读者往往带着明确线索来:某个人、某个村庄、某个家族,或者发生在某个国家的故事。关键词搜索找不到,访问也就结束了。
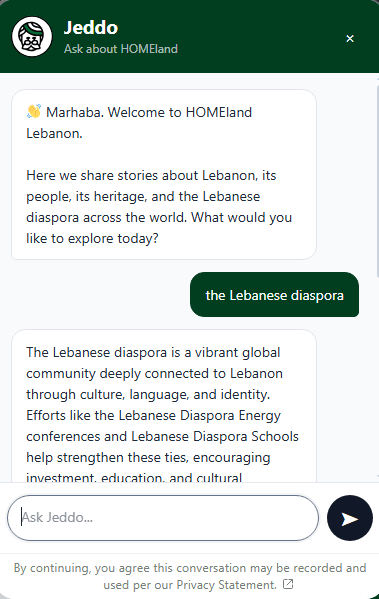
他们团队做的 Jeddo 是一个基于档案回答的 AI 向导。它用日常语言组织答案,并链接到支撑回答的文章或期刊;聊天组件可以从网站任意页面打开。
CASPR 的需求则偏向服务咨询。这家 Community After Schools Project 自 1995 年服务于都柏林东北内城区,目标是缓解社区的教育弱势。
它在三个地点为五所本地学校的 150 名小学生提供课后项目,通过 Community Employment 为 36 名本地居民提供带有 QQI 认证的儿童照护培训和 ECDL 培训,还与社区及公共机构协作为高风险儿童制定照护计划,并持续招募志愿者、募集捐款。
家长、志愿者和资助方反复提出相似问题,工作人员只能在活动间隙回答。聊天助手依据机构的服务、项目和已发布资料,帮助访客先找到合适的服务。
两种需求对检索提出了不同要求。档案读者提供的是人名、地名等明确实体;服务访客可能只描述自己的困难,连服务名称都不知道。检索必须接住用户的表达方式,不能只匹配网站自己的用词。
为什么先设计「不知道」,再调整提示词
RAG,即检索增强生成,可以理解为先从已有资料中找依据,再让模型组织回答。作者强调的重点不是接入了什么模型,而是限制回答范围,并把来源展示出来。
在档案场景里,来源链接让读者继续阅读原始文章;在服务场景里,资料依据帮助用户判断回答是否可信。作者认为,这比调整提示词更有助于建立信任,并提出「资料约束胜过更大的模型」。
这个方向有道理,但原文没有给出模型名称、检索方案或实验结果,不能据此认定换模型没有价值。
另一个更实际的建议是先设计兜底:没有可靠资料时怎么说明,什么时候应该转交人工,以及用户接下来如何联系工作人员。尤其是公益服务,编出一个看似合理的答案,可能比承认不知道更耽误事。
原文强调了人工接手的重要性,却没说明转接的触发条件、具体渠道,以及对话上下文是否会传给工作人员。这些仍然需要实施团队补齐。
部署方面,他们团队将聊天机器人作为独立服务运行,再通过组件嵌入现有 WordPress 网站。对维护存量网站的前端和全栈团队,这是可以参考的接入方式:网站负责入口,问答服务单独维护。至于身份认证、内容更新和运行成本,原文没有展开。
我的判断
我认同这篇文章的优先级:回答依据、检索适配和人工兜底,应该在上线前想清楚。一个能流畅聊天的组件,不等于一个能可靠解决问题的入口。
但它更像项目展示,尚不足以证明效果。作者称深层档案变得容易触达、重复咨询能即时处理、工作人员可以把时间还给孩子,却没有提供访问数据、节省工时或用户反馈。这些应当视为作者报告的收益,不能当作经过量化验证的结论。
和站内搜索、FAQ 相比,对话入口适合帮助用户整理模糊需求;对于已经知道标题、服务名称的人,直接搜索或清晰导航也可能更快。原文没有提供这些方案的对照。
还有一个边界:展示来源并不保证答案忠实于来源。上线时既要检查有没有引用,也要检查引用能不能支撑回答。
能拿来做什么
- 给内容站接入 AI 问答前,先收集真实的人名、地名和口语化问题,用它们检查检索是否能找到对应资料,别只用文章标题做演示。
- 在前端组件中同时设计答案、来源入口和无法回答时的下一步,让用户能继续阅读,或者找到人工联系方式。
- 维护 WordPress 等存量网站时,可以参考独立问答服务加嵌入组件的方式,并明确谁负责同步内容、更新服务信息。
- 评估试点时,分别记录检索是否命中、答案是否有依据、用户是否还需人工帮助,再判断它是否真的减少了重复工作。