让编程智能体跨会话保留项目经验
文章借编程智能体反复尝试失败命令的问题,拆解完整记录、经验提炼、知识整理和会话启动摘要四项记忆职责。同时区分上下文、持久化外部记忆与模型参数学习。
AI 深度解读
Agent 昨天花了半小时才找到正确的测试命令,今天换个会话,又把失败过的办法试了一遍。扩大上下文能缓解这个问题,却很难一直承担项目变化和会话增长带来的成本。
这篇文章给出的思路是:把经历、经验、知识关系和会话入口分开管理,再通过后台整理持续修正。对做 AI 编程工具的开发者来说,它最有用的地方,是把「让 Agent 记住」拆成了可以检查、更新和撤销的工程工作。
先分清:你要保留对话,还是复用经验
用户告诉 Agent「这个项目使用 pnpm」,至少存在三种不同的「记住」。
当前对话还保留这句话,属于上下文;系统把它写进下次能读取的文件,属于外部记忆;训练改变模型参数,则属于另一种学习机制。表现可能相似,工程手段却不同。
本文讨论的是外部记忆。开发者可以查看内容、追溯来源、修改结论,也可以撤销错误写入。它更接近一份需要维护的项目资料,而不是模型突然掌握了新知识。
对话压缩也不能直接等同于长期记忆。压缩通常服务于当前任务继续执行,长期记忆则要支持跨任务复用。一段摘要即使永久保存,也没有自动回答三个问题:内容是否过时、与其他记录是否冲突、什么时候应该读取。
先决定信息需要存活多久,再决定把它放在哪里。
作者按用途把记忆分成四层:
- Transcripts 保存完整经历,提供可追溯的记录。
- Memory notes 提炼有适用条件的经验。
- Knowledge representations 组织知识之间的关系。
- Injected context 为新会话提供少量起步信息。
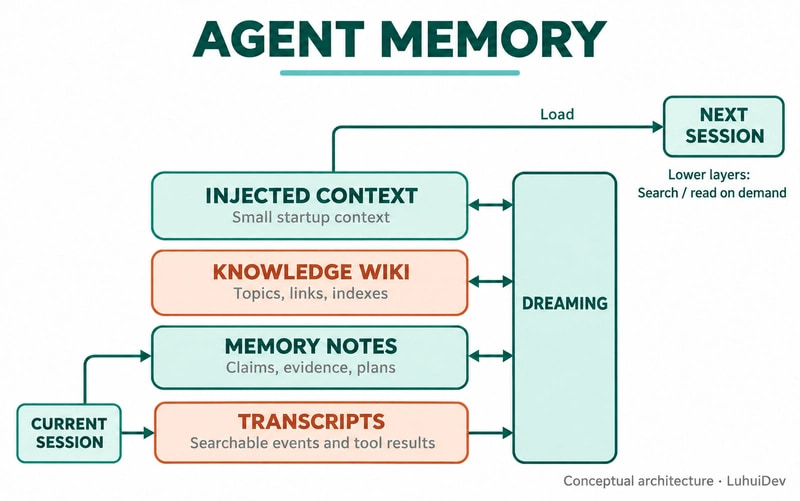
这不是四种数据库,也不是每条信息都必须依次经过的流水线。一个文件存储可以承载多层,一层也可以使用多个存储系统。小项目用一个只追加的日志目录、几份 Markdown 主题文档和一个简短索引,就能开始尝试。
测试通过了一次,能留下什么结论
外部记忆最容易出错的地方,是把一次观察写成长期规则。
原文用下面三条记录说明,测试失败和数据库之间究竟存在什么证据关系:
E17: Run pnpm test. It fails because the test database is unavailable.
E18: Start the test database provided by the project.
E19: Run pnpm test again. It passes.
要留意 E19:它记录了启动数据库后测试通过,却不能支持「任何测试失败都应该重启数据库」这样的结论。
日志里也可能同时出现工具反馈和 Agent 自己的解释。两者都被保存,并不代表证据强度相同。模型说了一遍、摘要又复述一遍,也不会让推断变成事实。
作者建议,事件至少附带时间戳、项目、版本或 commit 标识、事件类型和内容位置,并区分用户要求、工具观察和模型推断。这样,上层经验才能找到具体依据,而不是几段互相引用的文字。
对应到经验条目,更稳妥的表述是:在项目 A 当前的测试配置下,集成测试依赖可用的测试数据库;在第 42 次会话中,启动数据库后测试通过。
这条记录既保留了操作价值,也限定了使用范围。
作者自己的实现尝试让每条经验回答五个问题:结论是什么、适用于哪里、证据在哪里、何时验证、什么变化会使它失效。模型不必每次读完全部元数据,系统可以先按项目和版本过滤,再提供当前任务需要的内容。
这里的重点不是字段越多越好,而是结论能否回到证据。没有这条联系,记忆积累得越快,错误经验也可能传播得越快。
搜索负责找线索,入口负责告诉 Agent 去哪找
项目积累了数百条记忆后,只看文件名就很难知道该读什么。搜索可以找到相关片段,但未必能解释片段之间的关系。
例如「为什么本地通过、CI 失败」,可能同时涉及环境差异、数据库依赖和过去的配置决策。用户提问时使用的词,也未必出现在某条经验中。
主题页可以提前把这些关系连起来:testing 页面关联数据库配置,release 页面关联版本流程、回滚条件和部署记录。排查时先读主题页理解整体,再通过搜索定位具体版本、配置和日志。
作者没有主张把所有内容整理成 wiki。只维护 wiki 可能丢失细节,只依赖搜索又可能反复花成本重建关系。反复跨文档使用的关系,值得提前整理;偶尔查一个字段,直接搜索可能更便宜。
会话入口则应该更短。作者以 Claude Code 的 auto memory 为例,称新会话会带入 MEMORY.md 的开头部分,详细主题文件按需读取;原文没有给出具体截取长度。
作者测试系统里的入口采用了下面这种导航形式:
Current project: A
Test environment and commands: see testing.md
Release and rollback conditions: see release.md
Long-term writing preferences: see writing-preferences.md
要关注第二行:它指向 testing.md,没有把完整测试流程塞进每次会话。
入口内容该如何取舍?作者给出三个维度:使用频率、遗漏成本和长度。低频但漏掉会造成严重后果的规则,可能比高频出现的普通状态更值得占用空间。
入口写好之后,还要有人持续维护。作者把这项后台工作称为 Dreaming:在任务之外回看经历、检查结论、调整知识结构,让后续会话更容易取得有效信息。
其中有不少判断无法靠简单合并解决。同一教训出现三次,究竟是稳定规律,还是同一个错误重复发生?新旧记录冲突,究竟是环境变化,还是分别适用于不同项目?修正测试规则时,可能需要同步修改经验条目、测试主题页和入口索引。
Dreaming 的价值在于持续维护,难点在于每次整理都要有依据、可验证、可撤销。
我的判断
我认可这套拆分,因为它把「保存了多少」和「下次能否用对」分开了。日志承担追溯,经验承担复用,主题页承担关系组织,入口承担启动导航,各自的质量标准更容易明确。
但标题里的「Latest Anthropic」需要打个问号。原文混合了作者对 Anthropic 做法的理解、Claude Code 的产品例子,以及作者自己的实现建议,没有提供官方架构出处、明确版本或发布时间。适合把它当作工程设计参考,不能据此认定这是 Anthropic 最新公布的完整标准架构。
效果证据也有限。原文没有提供任务成功率、token 成本、检索准确率或维护开销的对照数据。主题页能减少重复探索、Dreaming 能带来累积价值,目前主要是作者的工程判断,不能直接写成已验证的性能收益。
和每次塞入大量历史相比,短入口加按需读取有明确的成本取舍;和纯搜索相比,主题页增加了预先组织关系的工作。团队应该选哪种,取决于重复任务有多少,以及谁来维护过期知识。
尤其是 Dreaming,原文尚未展开输入筛选、冲突处理、结论检查和安全回写的具体实现。因此,不能把「定期让模型重写所有笔记」当作已经成立的落地方案。
能拿来做什么
- 给日常 AI 编程项目建立简短入口,列出包管理约定,以及测试、发布文档的位置;把详细步骤留在对应主题文件中按需读取。
- 保存测试命令的执行记录,区分工具反馈与模型推断。遇到 pnpm test 失败时,把数据库状态、后续操作和验证结果一起留下,避免只记住一句修复口诀。
- 写入可复用经验时,至少交代适用项目、验证依据和失效条件。测试配置或依赖环境变动后,重新检查相关经验。
- 从日志、Markdown 主题页和索引开始,观察后续任务是否少走弯路。重复探索确实成为问题后,再投入更复杂的知识组织与后台整理。