业务 Agent 如何建立评测改进闭环
美团以商家 AI 助手的巡检任务为例,介绍业务 Benchmark 构建、评测器校准和错误分析方法。通过持续回归与模型选型,将评测体系完善和 Agent 能力优化连接起来。
AI 深度解读
商家让 AI 助手「巡检昨日投放」,它交出一份表格齐全、建议完整的报告,就算做对了吗?美团团队发现,报告看起来没问题,实际查询的却可能是今天的数据。评测如果只盯着最终回答,这种错误很容易漏过去。
这篇实践的核心,是把 Agent 评测做成一套能检查执行过程、复核证据、验证改动的工程流程。对正在做业务 Agent 的程序员,最有参考价值的不是某个评分公式,而是如何把「看起来能用」拆成可检查的生产要求,以及如何分清模型变强和评分规则修正。
测试题应该从业务流程里长出来
公开 Benchmark 能提供任务组织、环境构造和结果判定的方法,但不能直接证明广告助手可以上线。它们没有覆盖同样的投放规则、账户数据和操作权限。
美团团队采用两条路径构建自己的测试集:先从业务 SOP 拆出应有行为,再用真实 Bad Case 补充没预料到的失效模式。
第一条路径的重点,是把 Skill 还原成业务状态图,明确业务状态、数据依赖、条件分支、提前停止点、能力边界和跨 Skill 转交点。它描述的是「遇到什么情况应该采取什么动作」,不是一串必须从头执行到尾的工具调用。
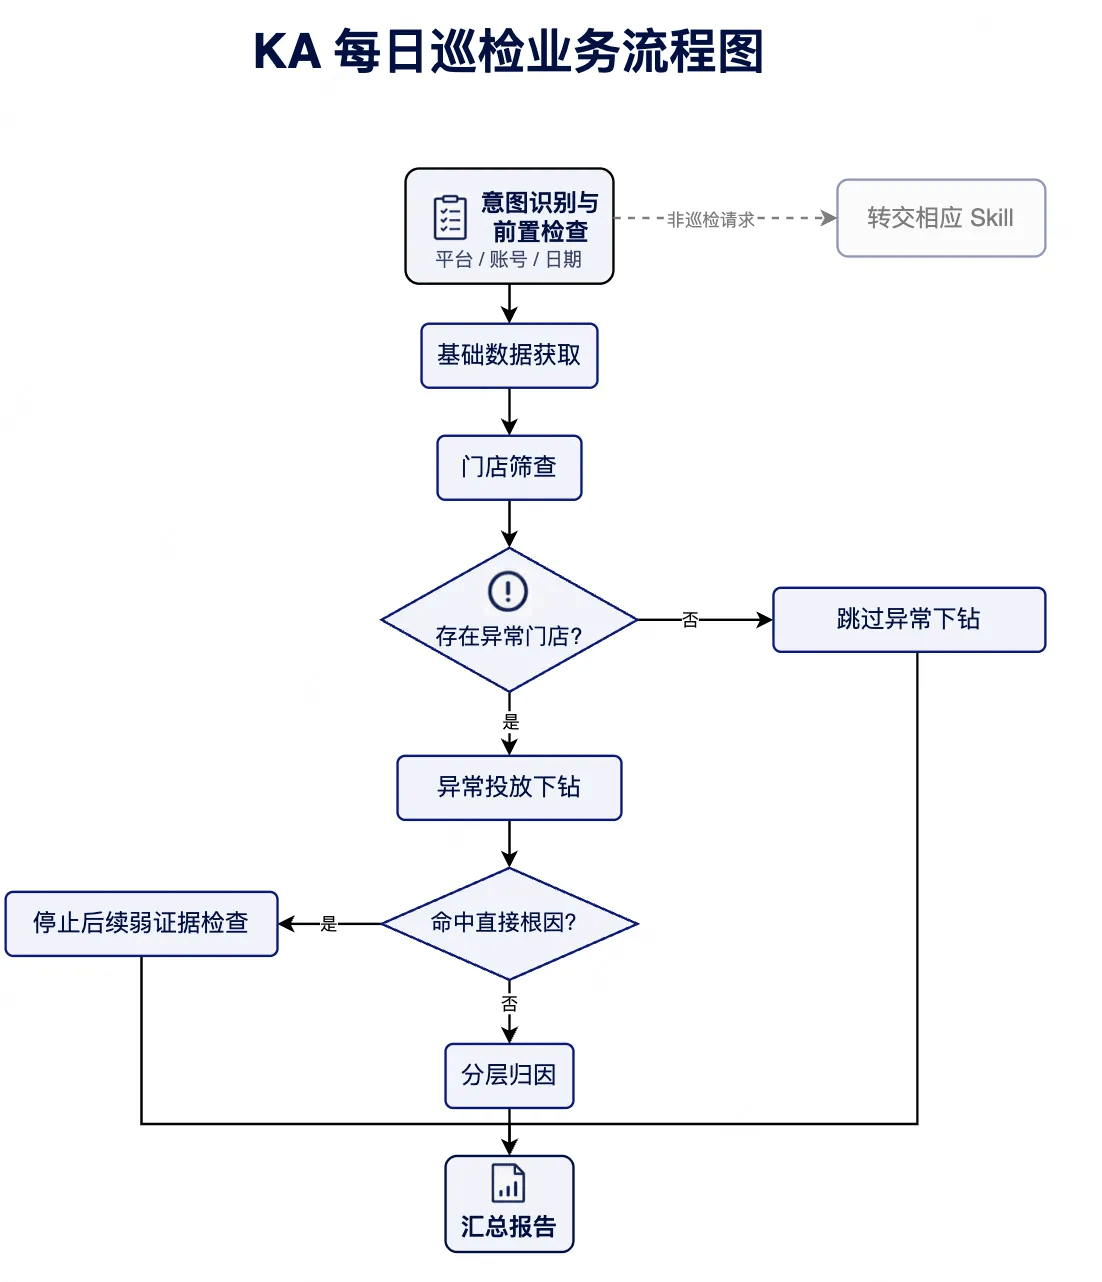
例如,没有异常门店时,应该跳过投放层下钻,但仍然生成报告;账户余额不足,只产生账户级预警;命中预算、余额、状态或时段等直接根因后,停止后续弱证据检查。用户实际要做日报复盘或计划编辑时,则转交相应 Skill。
这些分支同样需要测试。工具调得越多,不一定完成得越好。
第二条路径从错误出发,但不止保存一条失败对话。「查询昨日却用了今日数据」被抽象为日期理解与计算失效,再扩展到今日、昨日、历史日期和周末。这样补的是一类风险,而不是某个用户问法。
最终,他们为 KA 每日巡检设计了六类、共 41 个场景,再为每个场景补齐测试账号、运行日期、业务数据状态、权限和 Grader,形成 41 个可执行 Task。这里的 Task 不只是一道题,还包含运行条件和判卷标准。
任务成功要看证据,效率问题另外计分
巡检报告是否完整,只是检查的一部分。团队还要验证必要步骤是否执行、调用依赖是否正确、参数是否对应用户要求、结论是否忠实于工具返回,以及输出是否符合必要模板。
这些要求组成评分细则 Rubric,并分成两层。
必要步骤、顺序调用、正确工具、参数一致性与合规性、输出忠实性、完整性和必要模板,属于成功必需项。重复调用、规划效率、结论表达等,则用于质量分层和问题诊断,不直接决定任务成败。
任务是否做对,与任务做得是否高效,需要分开判断。
判定方式也分工:能从执行轨迹 Trace 精确取证的,由确定性 Grader 检查;需要理解业务语义和证据关系的,交给 LLM Grader。例如日期参数可以直接核对,「投放消耗下降」能否支持「投放效果变差」,则需要检查推理依据。
原文给出的检查项名称包括:tool_calls_dag 对应路径规划,no_hallucination 和 hallucination.* 对应工具与事实一致性,output_fields 和 output.* 对应输出质量,execution.conditional 检查条件分支。这些是该实践的实现命名,不是通用标准。
单次通过也不足以证明可靠。团队通过 Harness,也就是统一组织执行、采集和统计的运行框架,汇总多次 Trial,观察任务完成率、Pass@k、Pass^k,以及 Token、LLM 调用轮次、端到端时延和 TTFT(首个 Token 返回时间)。
Pass@k 关注多次尝试中能否成功,Pass^k 更关注连续执行能否稳定成功。一个 Agent 偶尔能做对,与用户每次都能依赖它,是两种能力。原文没有在正文中明确本次实验的 k 值,解读结果时需要保留这个信息缺口。
先校准判卷器,再用失败推动优化
评测结果不一定都是 Agent 的问题。
原文引用 OpenAI 对 138 道难以攻克的 SWE-bench Verified 任务的审计,其中 59.4% 存在任务描述或测试设计缺陷。这个比例对应特定审计样本,不能推广为整个 Benchmark 的缺陷率,但足以提醒团队:判卷器也需要验证。
美团团队先建立业务专家确认的校准集,覆盖 Good Case、Bad Case 和边界 Case,并分别检查 Trace 解析、确定性 Grader 和 LLM Rubric,避免总体一致率掩盖局部错误。
一个具体修正是把线性调用顺序升级为有向无环图 DAG。线性规则容易把合理的并行执行判成失败;DAG 只保留真实的数据依赖,互不依赖的步骤允许调整顺序。
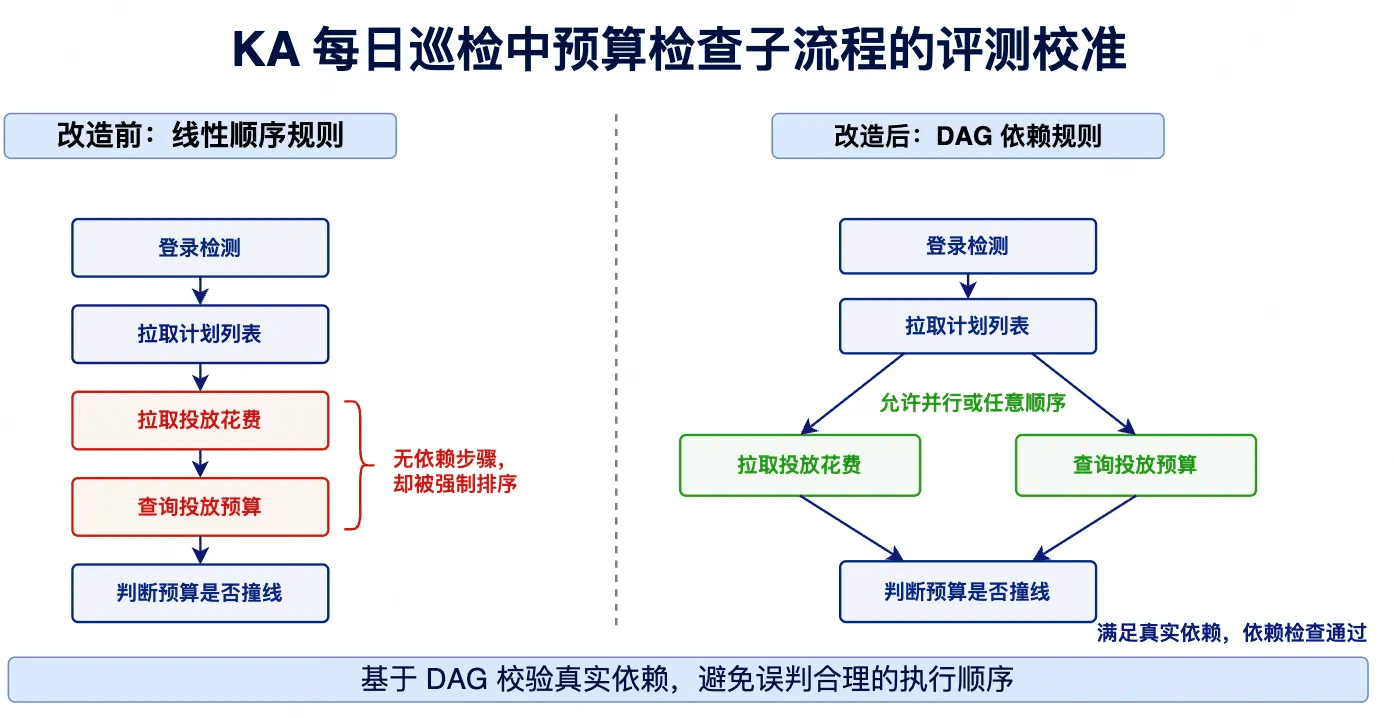
LLM Grader 则通过人工抽检确认语义判断是否符合业务标准。对于证据不足的高风险问题,允许返回「无法判断」。修改判定规则后,再回放历史样本,检查旧误判是否消除、是否引入新问题。
评分规则修正带来的分数上涨,不能记成 Agent 的能力提升。
确认评测可信后,才进入错误分析:先用原子检查项缩小范围,再查看对应的局部 Trace、参数和工具返回。只有证据冲突、问题随机出现或无法区分 Skill 与模型责任时,才进一步复现和做控制变量验证。
他们最终把确定性约束从模型判断中移出:平台、账号和参数红线归公共配置,业务分支与停止条件写入 Skill,解析、计算和筛选交给确定性代码。模型主要负责流程调度、条件理解和业务表达。
同一套 Benchmark 回归后,作者报告能力上限和执行效率提升,但 Pass^k 仍显著低于 Pass@k,说明稳定执行仍是瓶颈。具体提升幅度经过脱敏,不能据此推算其他团队能获得多少收益。
持续运行则由图灵平台承接:复用 Task 集、Evaluator 和 Pipeline,批量执行、采集证据、逐项判定,并支持人工质检和结果下钻。平台的作用是减少重复操作,业务标准仍然需要团队维护。
我的判断
我最认同的,是把业务规则、执行证据和最终交付放进同一套评测。相比只用 LLM 给回答打总分,这种方式更容易定位问题;相比把整条执行链写死,又能通过条件分支和 DAG 容纳合理路径。
但这里有几个前提:团队有可梳理的 SOP,工具调用和返回能够记录下来,还有业务专家参与校准。原文没有给出建设成本、人工投入或与轻量方案的对照数据,无法证明所有团队都需要完整复制这套平台。
它也不是纯粹的模型优化案例。配置治理、Skill 改写、确定性代码和评测规则都参与了改进,不能把结果全部归给模型能力。
真实账户数据持续变化,也是比较版本时的难点。复制模型、Prompt、Skill、工具和权限配置,并不等于固定了输入数据。日期、账户余额或活动状态变了,完成率变化就可能混入环境影响。
对于业务收益,作者的表述比较克制:当前商家数较少,缺少同期对照组,观察到的变化还可能受季节、活动和经营状态影响。因此,离线提升支持「任务做得更好」,尚不足以证明「投放收益由这次优化带来」。
能拿来做什么
- 为现有业务 Agent 选一条高频流程,把必要步骤、条件分支、停止条件和转交条件写成明确规则,再结合历史错误补题,不必先追求庞大的测试集。
- 在 Node 工具层记录调用参数、返回数据和关联 Trace,让日期、账号、权限与数据来源可以被直接核对;最终回答的评分只承担它适合检查的部分。
- 把稳定的日期计算、解析和筛选交给确定性代码,修改 Skill 后同时验证目标问题是否修复、正常分支是否退化,并观察 Token 与耗时。
- 每次比较模型或 Skill 版本时,固定任务与判定标准,核对运行日期和业务数据状态;重复执行检查稳定性,并用人工抽检校准 LLM Judge。