用语法分析给244个小工具自动分类
Simon Willison 让 AI 借助 tree-sitter 分析其 244 个工具,提取 JavaScript API、依赖库和 Web API 主机信息。网站据此增加分类标签云,方便按技术要素检索工具。
AI 深度解读
244 个用 AI 辅助写出来的小工具,积累到一定规模后,麻烦就从「怎么做」变成了「怎么找」。Simon Willison 的办法是让 Fable 5.2 配合 tree-sitter 分析代码,再按 JavaScript API、依赖库和 Web API 主机整理标签。
这篇短记录值得看的,是一个很具体的整理思路:工具叫什么、解决什么问题之外,还可以按「代码用了什么能力」来浏览。但它展示的是功能上线,没有提供识别准确率或效率对照。
工具多了,可以按实现能力来找
截至 2026 年 11 月 11 日,作者的工具集合已有 244 个,而且还在增长。这些工具通过 vibe coding,也就是主要借助 AI 对话生成代码的方式积累而来。
作者一直想改善浏览方式。这次新增的入口不是逐个重写工具介绍,而是从实现中提取共同特征:用了哪些 JavaScript API、哪些库,以及哪些 Web API 主机。
这种分类能回答另一类问题。比如你记不住某个工具的名字,却记得它用到了剪贴板;或者想找一个使用 Pyodide 的现成案例。按技术标签进入,会比逐个翻工具更直接。不过,原文没有测量实际查找速度。
tree-sitter 负责分析什么,模型又做了什么
作者在每周额度重置前,还剩一些 Fable 5.2 credits,于是让它着手完成这项工作,并使用 tree-sitter 分析代码。
tree-sitter 是代码解析工具,可以把源码转成有结构的语法树,供程序定位调用、导入等代码结构。相比只搜某个字符串,这提供了更明确的分析依据。
但原文没有公开实现代码,也没交代具体识别规则。例如,API 换个变量名调用后能否识别,动态拼接的服务地址怎样处理,模型是否参与逐个工具的分类,都没有说清。
可以确认的是作者让模型借助代码解析工具完成了整理,不能据此断言所有标签都经过了准确性验证。
标签云展示了什么,也限制了什么
首页现在按不同类别展示标签云,标签大小对应数量,点击后可以查看相关工具。
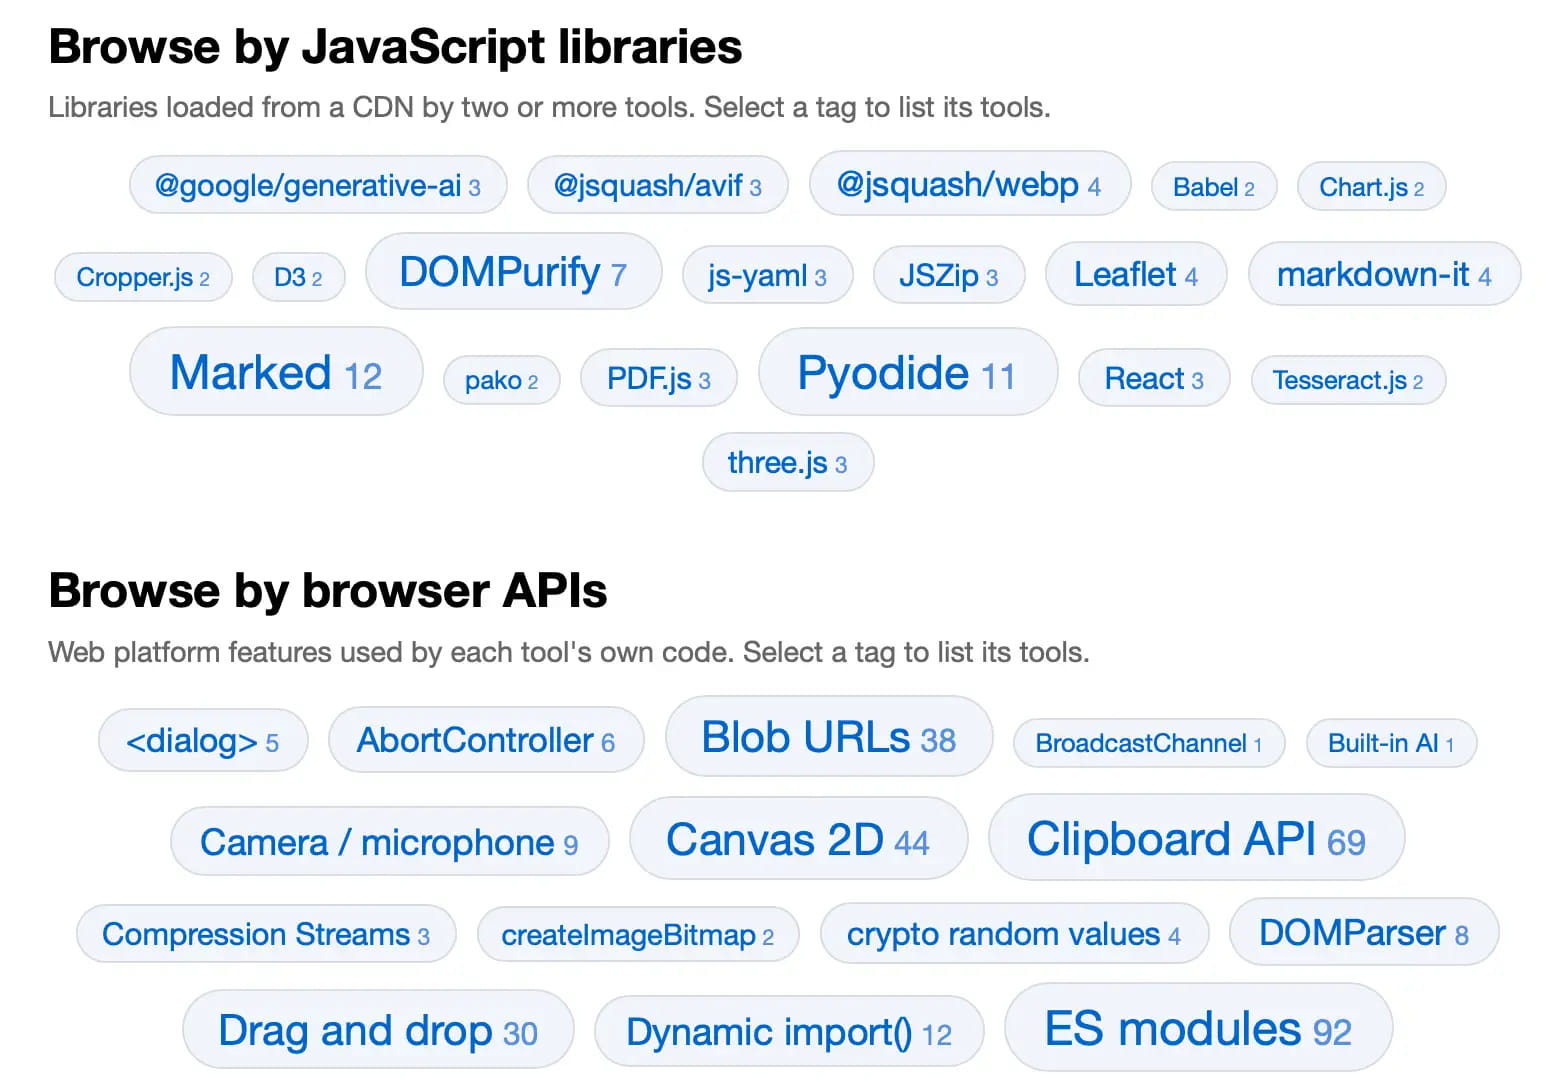
截图里,浏览器能力的分布很直观:ES modules 出现在 92 个工具中,Clipboard API 为 69 个,Canvas 2D 为 44 个,Blob URLs 为 38 个,Drag and drop 为 30 个。它让读者能快速看出,这批工具常用哪些平台能力。
库标签则有明确筛选条件:只展示至少被两个工具通过 CDN 加载的库。 其中 Marked 对应 12 个工具,Pyodide 为 11 个,DOMPurify 为 7 个,React 为 3 个。
这个口径影响解读。标签云展示的是作者工具集合中的使用情况;库标签还受 CDN 加载方式和至少两次使用的门槛限制。它不能代表整个前端生态的流行度,也不能当作完整依赖清单。
截图还说明,浏览器 API 标签针对的是工具自身代码使用的平台功能。这能帮助读者理解统计范围,但具体如何排除第三方库内部调用,原文没有解释。
我的判断
我认同这种整理顺序:先利用代码中已有的信息,再建立可浏览的入口。对于不断积累的小工具,依赖和 API 是有价值的检索线索,也能帮助开发者寻找可参考的实现。
不过,技术标签只能补充用途分类。想找「图片压缩工具」的人,未必知道该点 @jsquash/webp;熟悉实现的人,才更容易利用这类入口。
与手工标签相比,自动提取有减少维护工作的潜力,但作者没有给出耗时、误报、漏报或维护成本的对照数据。Fable 5.2 的剩余额度解释了这次工作的契机,不能证明换成其他模型或规则脚本就做不好。
能拿来做什么
- 如果你维护前端小工具集合,可以保留用途介绍,再增加浏览器 API 和依赖库入口,让读者既能按需求找,也能按实现找。
- 如果你积累了不少 AI 生成的代码,可以先提取 Clipboard API、Canvas 2D、Pyodide 等具体线索,用来寻找旧实现和参考案例。
- 如果准备自动生成标签,先明确统计口径,并抽查识别结果;尤其要区分自身代码调用、第三方库调用,以及 CDN 依赖是否覆盖完整。