把 Agent 评测接入 CI,拦截行为退化
文章演示使用 Agents CLI v1.13.0,将固定案例上的回答与工具调用评测接入项目 CI,通过退出码决定拉取请求检查是否通过。它针对的是提示词改动导致行为变差、普通单元测试却仍通过的问题。
AI 深度解读
Agent 的代码能跑,不代表回答没有退步。改一行 instruction,单元测试可能照样通过,回答质量和工具调用却已经变差。作者用 Agents CLI v1.13.0 做了一个小实验:给评测设置最低分,再让失败结果通过退出码拦住 PR。
这套做法值得看,原因在于它把「上线前看看回答行不行」变成了仓库里的自动检查。但真正需要琢磨的,是评测集够不够用,以及平均分能不能守住你的业务底线。
单元测试通过,为什么还要检查回答
原文引用的 Kaggle AI Agents Intensive with Google 第 5 天白皮书《Prototype to Production》提出,Agent 的任何版本都应通过自动评测后再交给用户。作者演示的是其中的合并前阶段,后面还有 staging 和 production。
单元测试可以检查函数是否按预期执行;Agent 还需要检查它面对具体请求时,回答是否合适、工具是否用对。评测(eval)的做法,是准备一组已知问题,让 Agent 逐个作答,再按指标评分。
Agents CLI 是用于在 Google Cloud 上构建、评测和部署 Agent 的命令行工具。v1.13.0 的关键变化,是让 eval run 和 eval grade 输出明确的 RESULT: PASS 或 RESULT: FAIL,并用退出码表达结果。
评测结果只有接入合并规则,才会成为真正的质量门槛。
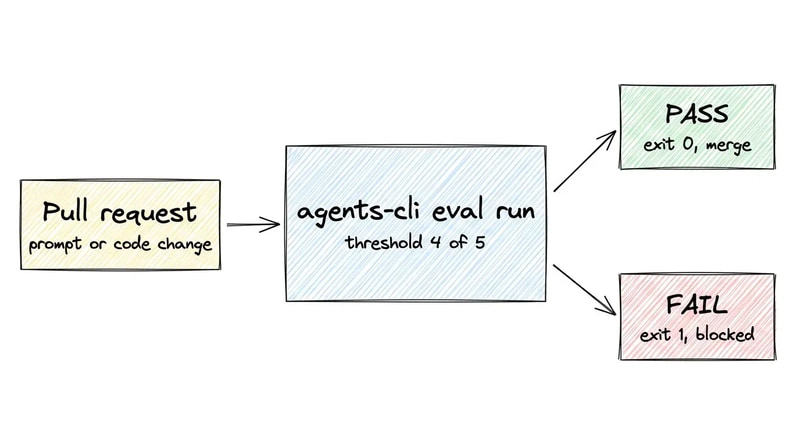
CI 原本就能读取退出码:0 表示成功,非零表示失败。因此,无须额外插件或日志解析器,就能把评测变成流水线的一步。
三个用例能证明什么,又漏掉什么
作者从新建项目开始。使用 Google Cloud 时,需要开启 Vertex AI API,并通过 gcloud auth application-default login 准备本地凭据;也可以使用 Gemini API key。
初始化依次运行 uvx google-agents-cli setup、agents-cli create gate-agent -y,再执行 cd gate-agent && agents-cli install。其中,uvx 可以直接运行尚未安装的 Python 工具,-y 接受默认选项,install 安装项目依赖;setup 还会安装 CLI 及供编程 Agent 使用的 skills。
脚手架自带的 tests/eval/datasets/basic-dataset.json 只有三个用例:打招呼、查询天气、询问法国首都。最后一个提供了参考答案。
评分指标 custom_response_quality 使用大模型裁判(LLM-as-judge),由另一个模型阅读回答,给出 1 到 5 分。Agent 和裁判都通过 .env 中的 Google Cloud 项目调用 Gemini,也可以按文件注释切换到 GEMINI_API_KEY。
作者先运行 agents-cli eval run --fail-under custom_response_quality=4,将门槛定为四分。这个命令串起两个阶段:eval generate 生成回答,eval grade 负责评分。
原始 instruction 下,三个用例全部有效,没有出错:mean_score 为 5.0000,stdev_score 为 0.0000,pass_rate 为 1.0000。结果通过,echo $? 返回 0。
随后,作者把 instruction 从 You are a helpful AI assistant designed to provide accurate and useful information. 改成 Answer in one word. Never call tools.。
脚手架里的占位单元测试仍然通过,评测却失败了。问候回答变成含糊的 Anything,天气回答 Foggy 跳过了工具调用,两个用例都只有 2.00 分;Paris 仍然符合参考答案,保住了五分。
于是平均分降到 3.0000,pass_rate 降到 0.3333,退出码变成 1。失败输出列出 case 0 和 case 1,Next: 指向包含回答和评分的 HTML 报告,并提示用 agents-cli eval compare 比较两次运行。
这里要分清两个数:pass_rate 表示单个用例得分至少为四分的比例;门槛比较的是平均分,并不按通过率判定。另外,只要任意用例执行出错,也会返回 1,防止评测自身坏了还放行。
接上 GitHub Actions,还差一步才能拦住合并
临时试验可以用 --fail-under METRIC=SCORE。要交给团队长期使用,作者把门槛写入 tests/eval/eval_config.yaml:
thresholds:
  custom_response_quality: 4  # 裁判按 1-5 分评分
要看的是 custom_response_quality: 4:它设置的是该指标可接受的最低平均分。配置提交后,CI 直接运行 uvx google-agents-cli eval run 即可,门槛、提示词和数据集都能随代码一起版本管理。
接着运行 agents-cli scaffold enhance --cicd-runner github_actions,生成 .github/workflows/pr_checks.yaml。原有流程已经包含 Google Cloud 认证、单元测试和集成测试,再在集成测试后加入评测步骤:
      - name: Eval gate
        env:
          GOOGLE_GENAI_USE_ENTERPRISE: 'true'
          GOOGLE_CLOUD_PROJECT: ${{ vars.CICD_PROJECT_ID }}
          GOOGLE_CLOUD_LOCATION: global
        run: uvx google-agents-cli eval run
要注意 GOOGLE_CLOUD_PROJECT 这一行:它引用 GitHub 仓库变量 CICD_PROJECT_ID,需要事先配置。由于 .env 不提交到仓库,这一步显式提供三个环境变量,让 Gemini 客户端使用指定项目和 global 区域。
但工作流报红,还不等于禁止合并。需要在分支保护规则中,把 PR Checks 的 test job 设置为必需状态检查。
还有一个容易卡住团队的细节:生成的工作流只针对提交到 main、且修改了 app/、tests/、deployment/ 或 uv.lock 的 PR 运行。作者提醒,设为必需检查时,应删除 paths: 块,否则跳过工作流的 PR 可能一直等待检查结果。
我的判断
这个实验足以说明:一行 instruction 的退化,可以逃过占位单元测试,也可以被现有评测抓住。但它没有证明这套评测比认真编写的行为测试更全面,也没有提供不同裁判、不同数据集的对照结果。
三个用例适合演示接线,离业务质量保障还有距离。尤其当前门槛看平均分,高分用例可能抵消关键用例的低分。对必须调用工具、必须遵守输出约束的要求,确定性断言更直接;模型评分适合补充检查回答是否准确、有用。两者可以一起用。
稳定性也不能只看一次运行。错误 Agent 在不同运行中回答过 Foggy 和 Unknown,平均分分别为 3.00 和 2.67;正常 Agent 的三次运行都是 5.00。这些是作者观察到的结果,样本还不足以证明长期稳定。门槛要留余量,但留多少,原文没有给出校准办法。
平均分达标,只能说明当前评测集达标。
作者建议把每次生产故障补成新用例,这个方向合理。不过,每加入一个用例都会改变均值,团队也应重新检查门槛是否仍能表达原来的质量要求。至于运行成本、耗时和裁判偏差,原文没有给出数据,接入前仍需自己测量。
能拿来做什么
- 如果你正在开发带工具调用的 Node 或全栈 Agent,可以先整理真实请求、预期回答和工具使用要求,再用自己的指标名及评分尺度设置
--fail-under。 - 修改 instruction、工具描述或 Agent 行为时,把评测结果与单元测试一起检查;遇到失败,结合 HTML 报告和
agents-cli eval compare定位具体退化。 - 把稳定的门槛写入仓库,并同时检查 GitHub Actions 的必需状态检查和
paths:配置,确保失败结果能实际阻止合并。 - 将线上答错、漏调工具的请求补进数据集,每次扩充后重新观察分数分布,避免沿用一个已经失去代表性的平均分门槛。