Gemini 决策模型主打低延迟批量判断
Gemini Decisions API 可在单次处理中评估最多 1000 个封闭式问题,支持文本、图像、音频和视频。据谷歌称,返回结果耗时 150—250 毫秒,成本约为 Gemini 3.5 Flash-Lite 的五分之一。
AI 深度解读
Google 想把 AI 的一类常见工作单独做成产品:面对固定选项,快速判断该选哪一个。Gemini Decisions API 背后的 Gemini Decision 1,号称一次可处理最多 1,000 个独立问题,耗时 150 至 250 毫秒。
对做 AI 应用的程序员来说,它的价值在于路由、分类、评分这些高频判断。但速度、价格和置信度能否兑现,还要看具体任务。原文给出了 Google 的产品数据,没有提供独立实测。
只做固定选项,为什么还需要专门的模型
Gemini Decisions API 面向封闭式决策,也就是答案范围预先确定的任务:判断是或否、从多个选项中选择,以及按量表评分。
它背后的 Gemini Decision 1 直接为选项打分,返回概率和置信度。输入可以包含文本、图片、音频、视频和 PDF,一次最多处理 1,000 个独立问题。
这里的「独立」很关键。原文没有说它能把 1,000 步存在前后依赖的推理压进一次调用,也没有说明批量问题之间如何共享上下文。可以确认的能力,是围绕输入材料集中完成大量预设判断。
Google 给出的厨房照片示例,把三种题型放在了一次处理中:有没有污渍,置信度为 0.95;应该采取哪种清洁行动,选项得分为 98%;严重程度按量表评分,结果为 1.19,满分为 2。
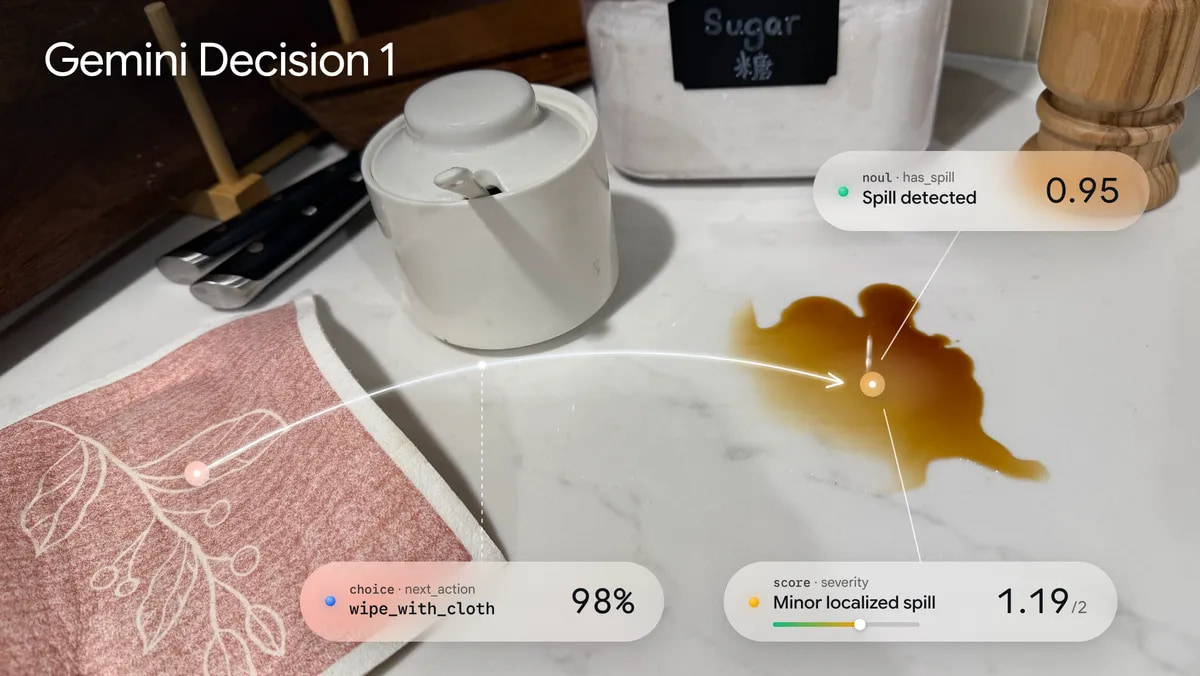
这种接口适合答案范围明确、程序需要继续执行下一步的环节。不过,示例中的 0.95 和 98% 都不能直接当成模型在真实业务中的准确率。
便宜、快速之外,置信度是否可信更关键
Google 宣称,API 返回结果需要 150 至 250 毫秒,价格为每百万输入 tokens 0.10 美元,不收输出 token 费用。按 Google 的比较,它约比 Gemini 3.5 Flash-Lite 便宜 5 倍。
这组数字对高频分类和路由很有吸引力,但原文没交代延迟对应的输入长度、问题数量和模态,不能据此认定「1,000 道多模态问题都能在 250 毫秒内完成」。同样,没有输出费用,也不等于输入材料很长时总成本仍然很低。
Google 称,内部已经把它用于 Gemini Notebook 的动态模型路由、Stitch 的设计原型制作,以及 Google Search 的安全检查。按原文描述,API 已通过 Google AI Studio 提供,OpenRouter、LangChain、Vercel 等平台的集成正在陆续推出,不能把它们都理解为已经可用。
基准图则宣称,Gemini Decision 1 在 agent 路由、推理、多模态理解等类别领先,并拥有最低的 Top-1 ECE,即一种衡量置信度与实际正确率是否匹配的校准误差。
返回一个概率很容易,让这个概率值得信任才是关键。
例如,模型长期给出接近 90% 置信度的判断,实际正确率也应接近这个水平,程序才有依据设置自动执行或人工复核的阈值。
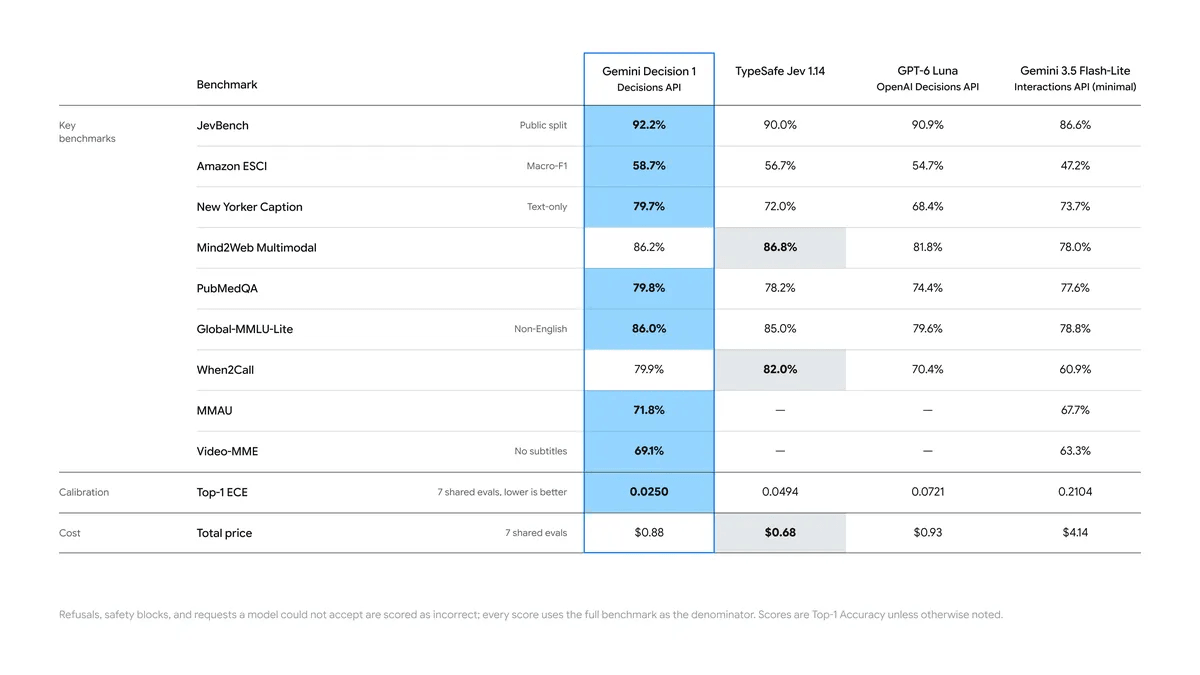
不过,原文没有展开测试集、评测条件和具体误差数值,这张图目前只能作为 Google 的性能主张。
我的判断
专门优化固定选项判断,这个方向有实际需求。用通用聊天模型做分类,往往还要处理输出格式、选项提取和调用成本;专用接口直接输出选项分数,更贴近程序消费结果的方式。
但是否值得替换现有方案,要看问题有多复杂。规则明确、输入结构稳定时,普通代码就能完成判断;需要理解图片、语义或模糊表达时,模型才更有用。已有通用模型配合结构化输出,也仍是需要比较的方案。
原文提到 Jev 率先推出类似产品,随后 OpenAI、Cloudflare、Microsoft 跟进,说明这正在成为一个产品类别。但报道没有提供它们之间的详细对照,也没有作者或独立团队的实测,暂时不足以判断谁更划算、谁更可靠。
能拿来做什么
- 如果 AI 应用已有模型路由,可以抽取真实请求,用相同选项比较 Gemini Decision 1 与现有方案的选路质量、端到端延迟和总费用,再决定是否接入。
- 对围绕同一份图片或 PDF 的多项独立检查,可以尝试合并调用,验证批量处理能否减少请求开销,同时检查遗漏和误判是否增加。
- 在 Node 服务中消费概率或置信度时,应先用标注样本验证分数是否可靠,再设置自动处理与人工复核的阈值;不要直接照搬厨房示例里的 0.95 或 98%。