前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
返回 AI 情报前线
All News · 全部资讯8593
  • 用Claude Fable 5单次生成完整游戏
  • 企业级MCP网关:OAuth 2.0+RBAC+工具级安全管控
  • AirLLM:单卡4GB显存运行70B大模型
  • 构建安全深度推理系统的实战架构指南
  • 深度推理模型的企业安全防护实践指南
  • Jeff Dean等Google顶级AI研究员集体创业
  • LangGraph状态持久化:三次生产踩坑与解决策略
  • AI Agent生产失败根因:协调层而非模型本身
  • 2026 OWASP GenAI/LLM 安全漏洞排行榜:行业首次用真实事故数据校准社区共识
  • GitHub Copilot Cloud Agent 接入 Linear:从工单到 PR 的异步 AI 编程范式正式可用
  • AI 产品回归测试必须设置防护栏:缓存和检索路径回滚的完整指南
  • AI 编码工具让 PR 规模增 12 倍,但测试覆盖率从 5% 升至 88%
  • AIoT 开发实录:工厂 45°C 环境和 1998 年遗留控制器下的工程困境
  • LendingTree 在 AWS Bedrock 上构建多 Agent 按揭助手的生产实践
  • 上下文工程:决定模型看到什么
  • 业余编程社区为何集体抵制 LLM 用法
  • GUI Agent不擅长确定性安装任务
  • MCP协议升级:推倒状态机实现云原生水平扩展
  • LoopX:解决多日长时AI Agent上下文断点的控制平面
  • DeepMind CEO与首席科学家同时离职
  • 开源模型100倍低成本击败GPT-5.6检索任务
  • MCP生产运行复盘:14条经验与教训
  • AI Agent无停机Credential轮换方案
  • Mobileye 基于 AWS Bedrock AgentCore 的客服 Agent 实践
  • Meta让数千名工程师「修Bug」来训练AI编码工具
  • 2026企业AI架构转型:从免费套餐到成本敏感的工程现实
  • AWS实战:通过MCP桥接让云端Agent安全调用本地工具
  • n8n集成Bedrock AgentCore:零基础设施搭建生产级AI Agent
  • AI Evals 入门:如何真正评估你的 AI 系统效果
  • 通过 MCP 协议让 AI Agent 完全控制真实 iOS/Android 设备
  • 深度推理模型生产部署实战指南
  • 深度推理模型性能监控实战指南
  • Agent系统最可怕的bug不是崩溃,而是静默失败
  • Vercel域名购买后可一站式配置部署、代理和邮箱
  • AI编程时代:代码审查员的核心价值与实操框架
  • AI Agent伪装身份欺骗开源维护者:安全沙箱已失效
  • Mistral 开源 3B 安全模型 Shieldstral:本地内容审核新选择
  • 自研 Agent 流水线的实战复盘
  • 自建内部 AI 平台成本远超预期:工程团队需谨慎决策
  • 自适应测试时计算:告别均匀分配推理预算
  • 分离Prefill/Decode:避免长Prompt阻塞所有Token
  • Agent难复现Bug的克星:确定性模拟测试
  • Agent工具调用分支预测:消除等待空档
  • Agent上下文窗口即RAM:引入分页机制
  • 停止让工具流经LLM:2026年代码模式转型
  • SparseSpec-L:无训练稀疏 KV 缓存让长上下文 LLM 推理提速 2.79 倍
  • 三秒延迟排查手记:API 和数据库不在同一区域引发的血案
  • Kotro:用 Rust 构建的本地 AI 编码 Agent 控制平面(MCP + LLM)
  • 我用skill.md约束文件对抗AI生成平庸UI
  • Markdown比HTML在LLM上下文中价值高10倍
  • 我做了个小CLI让AI编程工具不再失忆
  • 已加载 51 / 8593
8.0
热点
AI SCORE
编程提效2026-08-06 02:18

开源模型100倍低成本击败GPT-5.6检索任务

Hacker News#开源模型#成本优化#RAG
Editor brief · 编辑速览

实测展示使用廉价开源模型+特定优化策略,在检索任务上以百分之一的成本超越前沿大模型效果,提供工程可复现的方案。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

“大多数团队最好的训练数据就躺在数据库里。问题在于把原始数据变成可用之物非常困难,而让 Agent 以低成本、大规模地读取、搜索和修改数据需要高级的基础设施。把 Castform 指向 Neon,两者都能跳过。”

一个“好的 Agent”需要在两个领域都强:

Context:我们能否提供工具来找到正确的数据?

Model:模型能否决定搜索什么?

Neon(Lakebase Postgres)及其新的 Search 扩展解决了第一个问题;Castform 解决了第二个。

Evolution of agentic search

2022 年左右,整个行业全力投入 embedding 搜索。每个数据库提供商都加了一个,pgvector 是 Neon 下载量最大的扩展。为了给 LLM 提供 context,工程师们手工打造 RAG 流水线,本质上就是某种形式的 embedding 相似性搜索。

2025 年左右,Agent 开始获得更多关注。开发者开始创建多跳搜索工作流,将大问题分解为小问题。检索从一次性搜索系统转向了 Agentic 检索。模型不再发出单个查询,而是在循环中规划和搜索多次。每次循环迭代都意味着又调用一次前沿模型,增加了每个用户请求的总体成本和延迟。
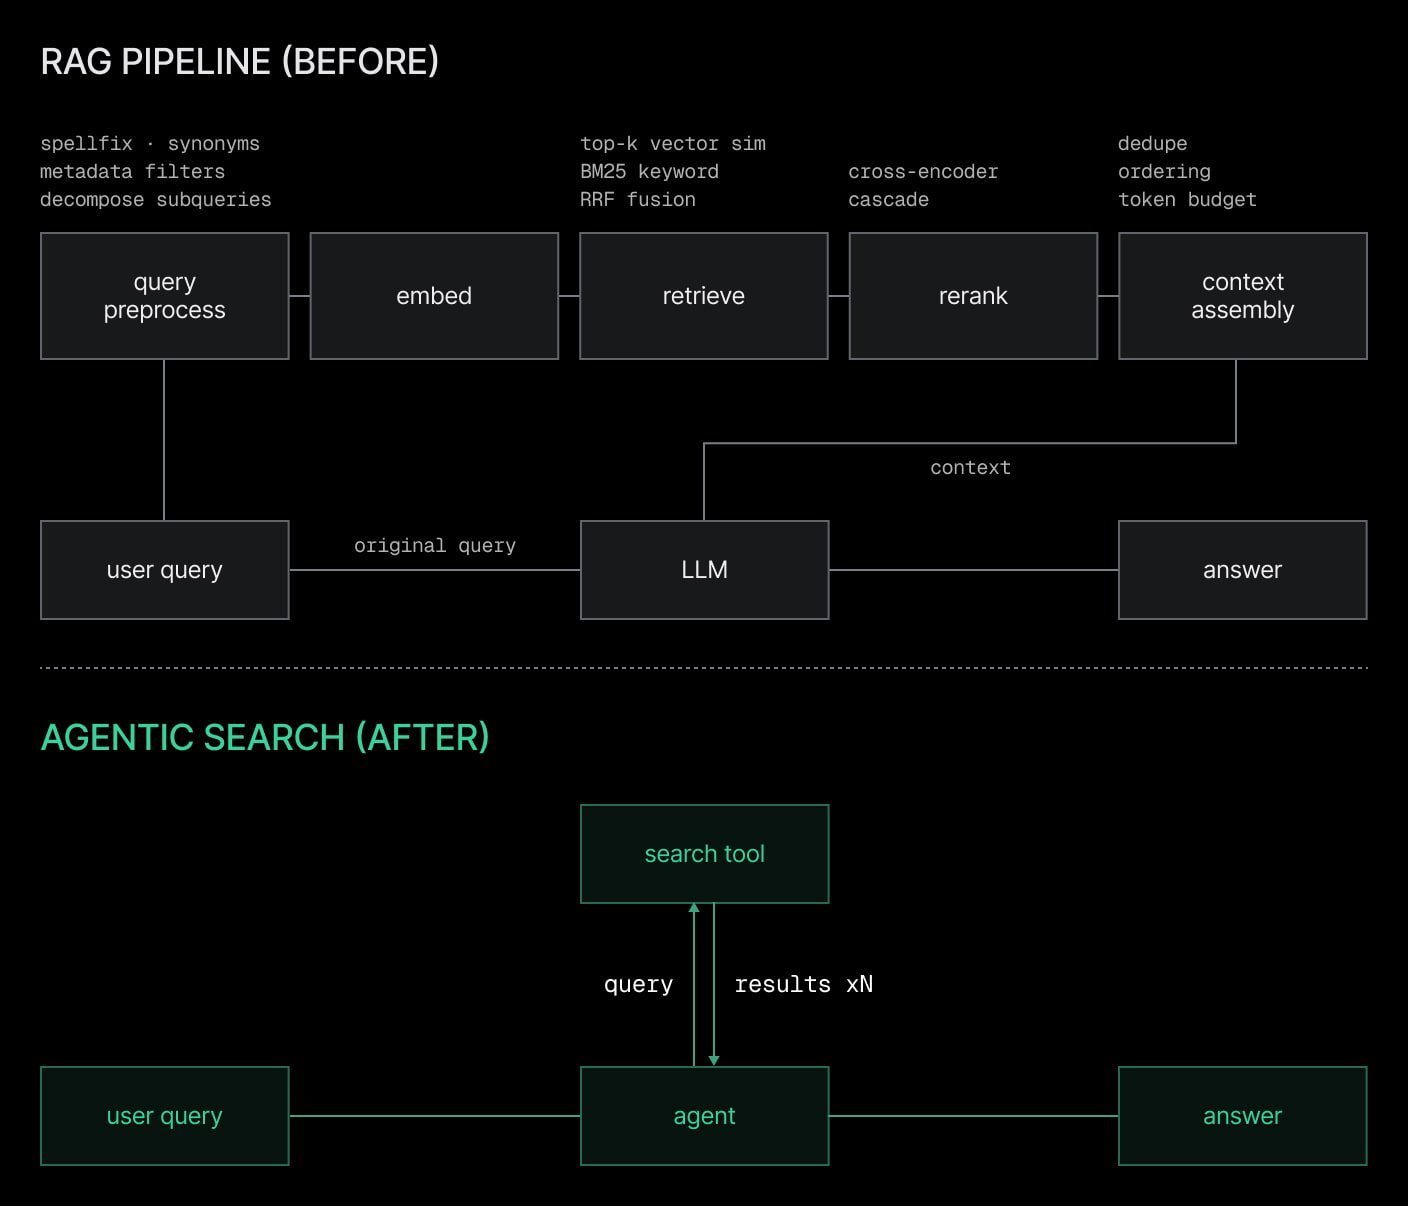
Comparison of a traditional RAG pipeline and an agentic search workflow

具体来说,用 gpt-5.6-sol 处理一个典型的多轮搜索请求需要超过 10 秒,端到端成本约 0.03 美元,使其慢得令人却步且成本高昂。

与此同时,小型开源模型便宜 100 倍。但开箱即用时,它们的能力落后于闭源 API 模型。RL 后训练有助于弥合这一差距。在搜索等特定任务上,经过后训练的开源模型可以匹敌甚至超越前沿模型,而每次请求的成本低几个数量级。

这就是我们构建 Castform 的原因:让开发者无需处理机器学习与 GPU 内部细节,就能对模型进行 RL 后训练。目标是让后训练像提示工程一样易于上手。

How does Castform use Neon?

Castform 的流水线通过 Lakebase Search 针对 Neon 运行:

Your best training data already exists

为了有效地进行 RL 后训练,你需要:

  • 一个任务(例如回答用户的问题)
  • Agent 运行的环境(例如你的语料库的搜索工具)
  • 一个奖励函数(例如答案是否正确?)

三部分就位后,RL 后训练就是一个试错循环:模型给定工具后尝试任务,奖励函数对尝试打分,反馈信号指导模型如何逐步爬升到最优性能。

然而,大多数公司并没有现成的、干净的任务和奖励函数数据集。

企业确实拥有大量专有数据:

  • 内部文档
  • 客户互动
  • 运营数据库

这些数据包含 Agent 所需的知识,但将其转化为有效的训练数据集通常需要大量的数据工程和人工标注。

这导致许多团队基于以下两个原因放弃后训练:

“我们没有训练数据。” “微调太难了,需要我们没有的基础设施。”

Castform 同时解决了这两个问题。它将现有语料库转化为训练任务,然后管理 RL 循环,教会开源模型如何有效地使用这些数据。

使用 Castform,你可以将公司知识库转化为模型:

文档(来自你的数据):通过 Navan 预订的火车行程将由 GitLab 差旅卡支付。火车必须乘坐标准舱,需提前 14 天预订。

Ground truth(从你的数据推断):火车必须乘坐标准舱,需提前 14 天预订。

问题(合成生成):在 Navan 预订火车出行时,关于需要提前多久预订以及应该选择哪种座位级别,有什么规则?

有了生成的问题-答案数据集,Castform 允许你通过指定 Agent 可访问的工具和奖励函数来搭建训练运行框架。

奖励函数指定了你希望模型擅长什么。在我们的案例中,我们希望它能检索到正确的 chunk、引用正确的来源,并提供正确的最终答案。

def run_tool(tool, tool_args):
    """Single tool: hybrid search over Lakebase."""
    if tool == "search":
        query = tool_args["query"]
        bm25 = neon.lakebase_text(query, k)
        vector = neon.lakebase_vector(query, k)
        return rrf_merge(bm25, vector, k)

def reward(trace, ground_truth):
    """Grade a trace against the ground-truth answer."""
    answer = parse_trace(trace)
    retrieval = ...     # did it retrieve the right source
    citation = ...      # did it cite the right chunk
    correctness = ...   # did it land on the right answer
    return retrieval + citation + correctness

在这里查看完整的代码示例。

Observability: Watch the model learn

Castform 让你对 RL 运行有完整的可观测性。你可以监控每一步的奖励爬升,但更重要的是,你可以深入到单个任务/提示中,观察模型在质量上的表现,从而调试诸如工具损坏或奖励黑客等问题。

有关如何监控训练运行的更多细节,你可以在这里查看 Castform 博客。你也可以在这里查看我们的示例训练运行。
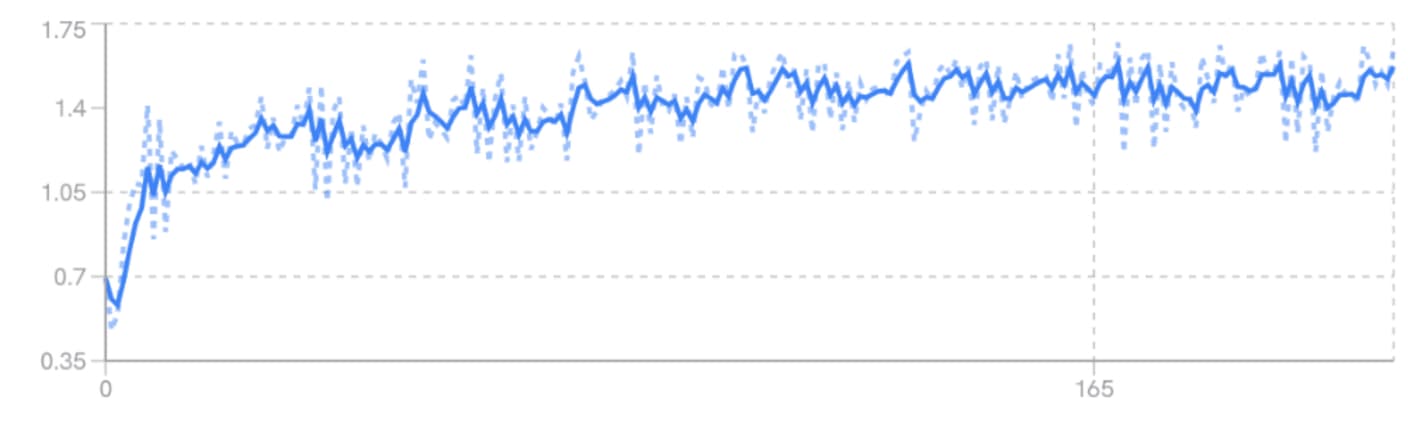
Average reward over training steps

Why Neon "just works"

在训练期间,Agent 反复调用 Lakebase Search,直到获得足够的 context 来回答。在数千个并行 rollout 中,每个可能发出数十次调用,这产生了高度突发的工作负载。
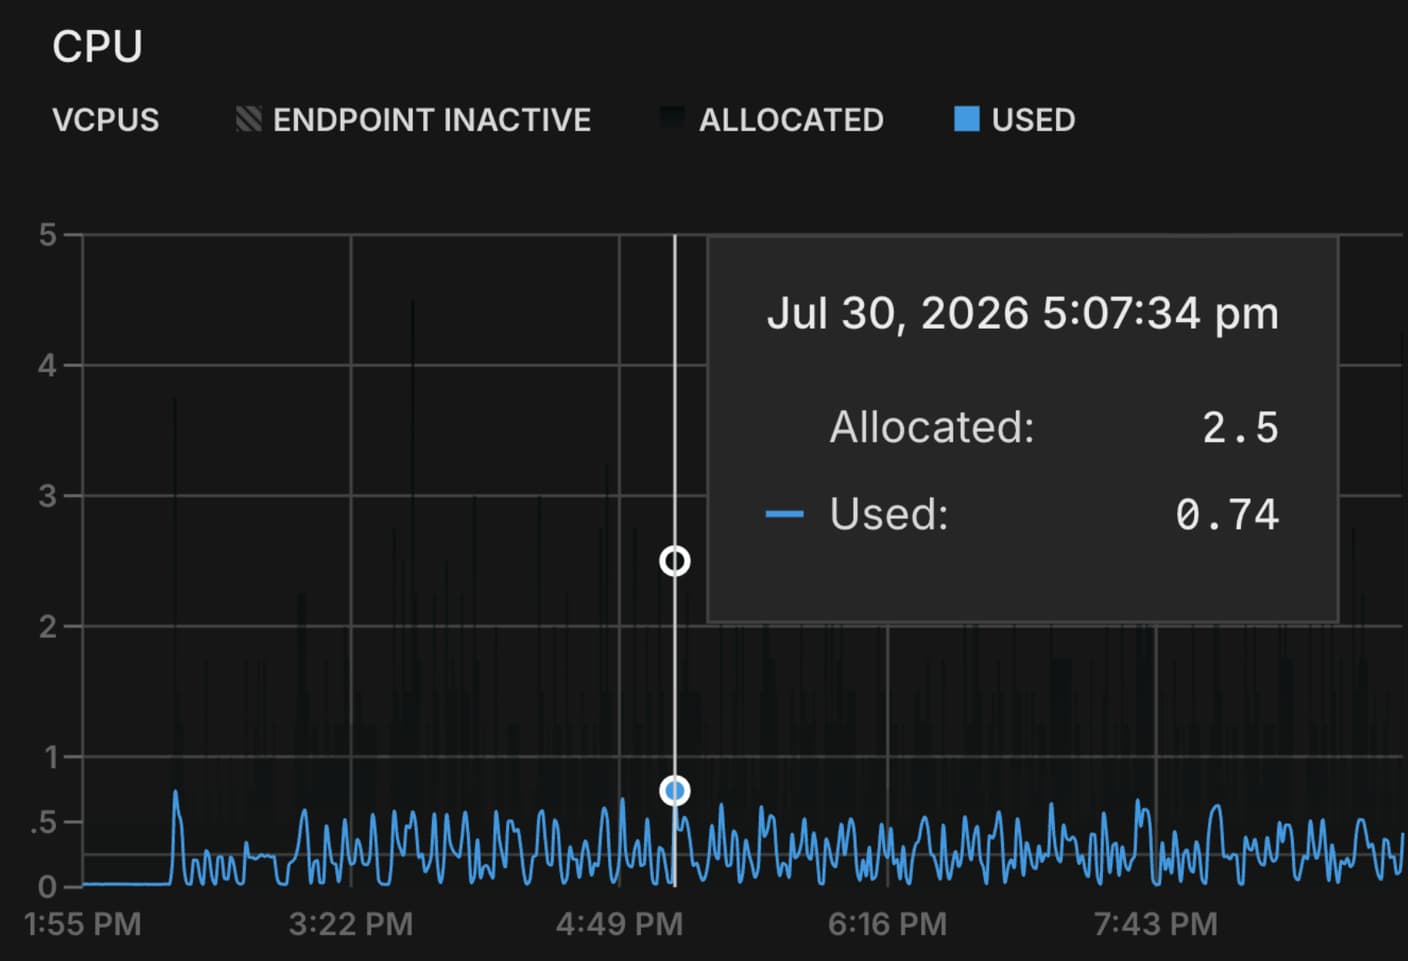
Neon CPU allocation and usage during a Castform training run

Neon 的动态计算扩展吸收了这些峰值,无需 Castform 全天候配置最大容量。训练运行在需求高峰时获得低延迟搜索,而在空闲期计算会缩减。

当 Agent 超越搜索开始修改数据时,这种基础设施变得更加有价值。训练有状态的 Agent 需要能够廉价创建和重置的隔离环境,防止一个 rollout 的操作影响另一个或触碰生产环境。

Neon 分支可以为每个 rollout 提供隔离的数据库状态,而时间旅行查询使得重建和检查 Agent 遇到的状态成为可能。结合自动扩展和缩容至零,这为训练数千个有状态 Agent rollout 开辟了一条道路,而无需维护数千个持续运行的环境。

Castform 让任何开发者都能轻松地将开源模型后训练得比前沿模型更便宜、更快、更好。今天就在 castform.com 后训练你的第一个模型。

Original source

本文由 AI 翻译整理自 Hacker News,原文版权归原作者所有。

阅读英文原文
上一篇
DeepMind CEO与首席科学家同时离职
下一篇
MCP生产运行复盘:14条经验与教训