MKA 用多模态交付任务衡量智能体性价比
谷歌与 Artificial Analysis 推出 MKA,以 200 项专业任务评估智能体处理复杂视觉文件及生成交付成果的能力,并统一工具与运行预算。公布结果中,Gemini 4 Carbon 质量排名第二、平均任务成本约为第一名的六分之一,另有 10 项样例任务公开。
AI 深度解读
AI 能读懂一份文档,不等于能把一项工作交付好。谷歌与 Artificial Analysis 推出的 MKA,试图把评测从文本问答推进到多模态知识工作:给智能体一组文件,要求它经过多步处理,交出演示文稿、报告或电子表格等成果。
据谷歌公布的结果,Gemini 4 Carbon 质量排名第二,平均任务成本约为第一名的六分之一。对程序员来说,更有参考价值的是这套测试如何检查交付物,以及这个成本结论还缺哪些前提。
MKA 要测的是交付能力,不只是读图能力
据 IT之家报道,谷歌于当地时间 11 月 10 日宣布推出 MKA,全称为 Multimodal Knowledge Agent。
它针对的是一类常见落差:不少知识工作测试靠文本就能完成,但实际项目需要同时处理图形、布局和跨文件信息。建筑师要交叉核对蓝图,工程师要分析示意图,最终还要把信息整理成可用的文件。只抽取文字,可能丢掉决定答案的空间关系。
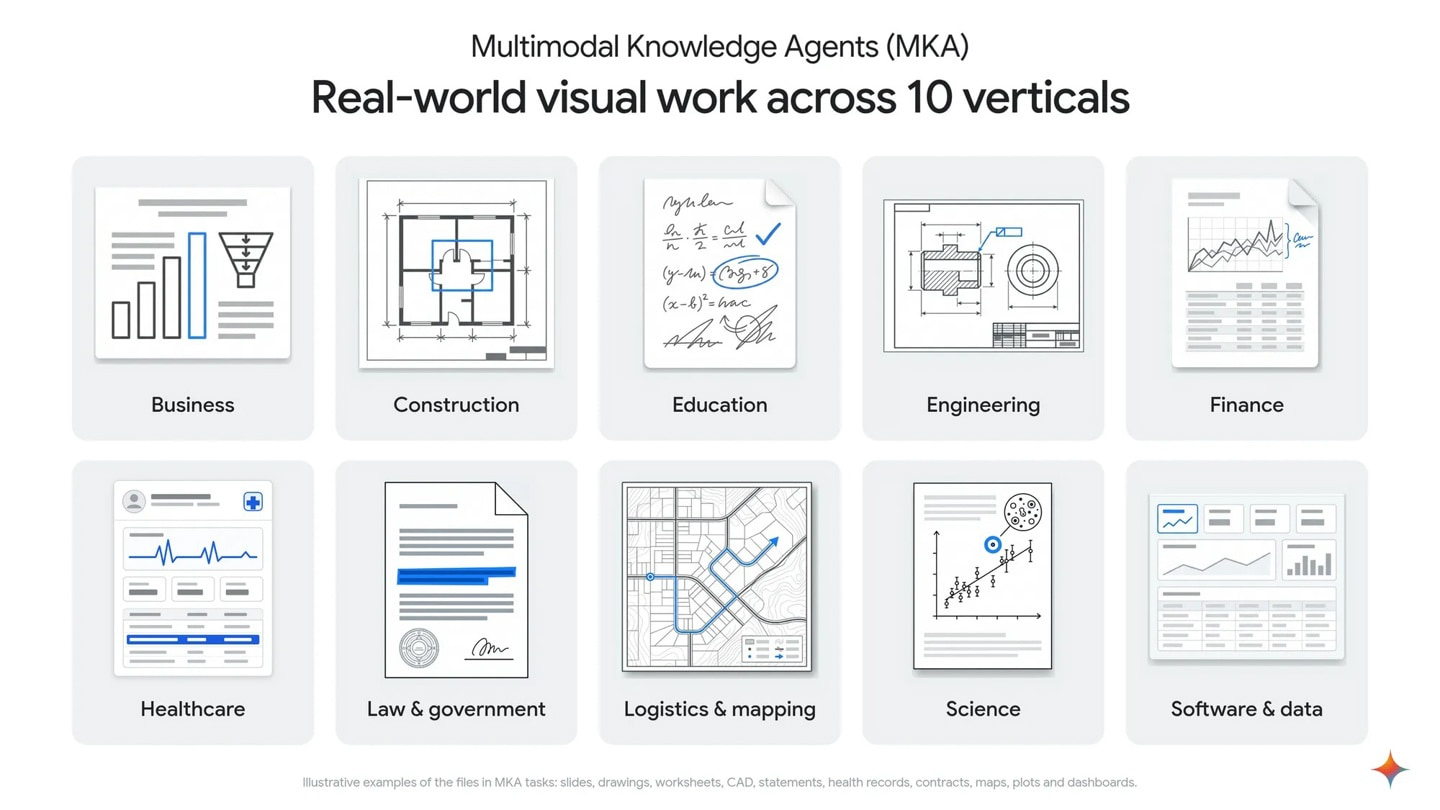
MKA 与来自 10 个行业、83 种职业的专家合作,构建了 200 项任务。覆盖范围包括商业、建筑、教育、工程、金融、医疗、法律与政府、物流与地图、科学、软件与数据。
每项任务都有真实工作提示词和一组多模态输入文件,模拟一个多步骤专业项目。谷歌称,经验丰富的专业人员通常需要花费 3 至 8 小时完成。
MKA 关注的是智能体能否把材料变成合格成果。
每项任务平均配有约 70 项是非判断检查项,事实准确性占 75%,视觉设计占 25%。这让「做得好不好」有了具体落点,但它衡量的是专家预先列出的要求,不能直接等同于客户满意度或实际业务价值。
同一套工具跑模型,再打开文件验收
所有参测模型都运行在同一个开源智能体框架 Stirrup 中,使用相同工具、沙箱环境和交互轮次预算。这样可以减少工具配置差异对结果的干扰。
验收也不只看智能体最后回复了什么。基于非谷歌模型构建的智能体评审系统会打开所有文件、渲染页面、检查电子表格公式,再逐项核对专家评分标准。
这对做自动化交付的开发者很有启发:生成了文件,只是流程走完了;文件能否打开、页面是否正常、公式是否正确,才决定它能不能用。
谷歌表示,领域专家人工评分与自动评审结果的一致率达到 96%。这是支持自动评审可用性的一项证据,但报道没有说明人工复核覆盖了多少输出,也没有解释一致率的具体统计口径,不能把它读成「交付物有 96% 的正确率」。
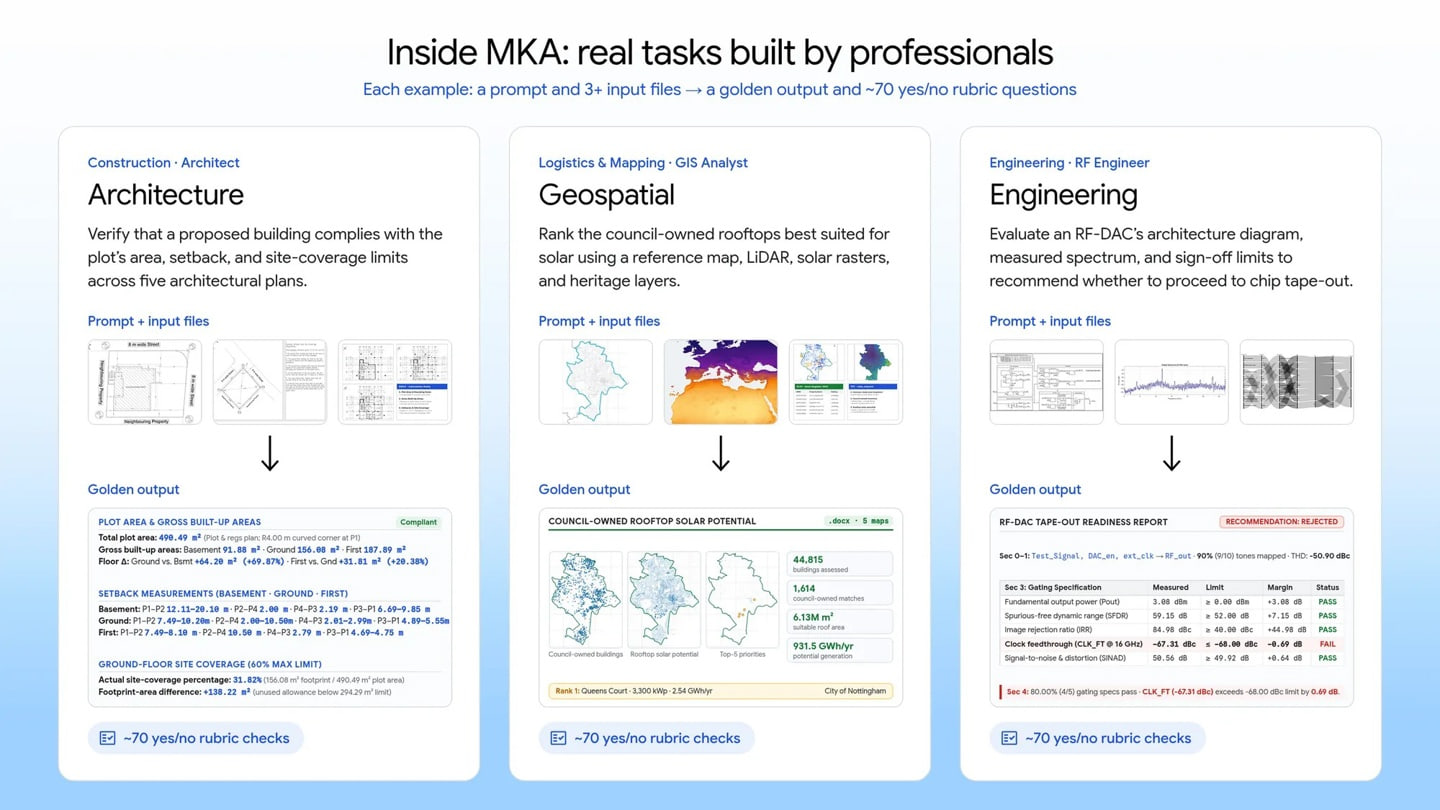
为降低题目泄露并进入训练数据的风险,Artificial Analysis 将 200 项正式任务设为私有,另在 Hugging Face 公开了 10 项任务,供开发者了解格式、评估自己的智能体。私有题有助于保护测试,但也限制了外部完整复核。
第二名的成本只有六分之一,能说明什么
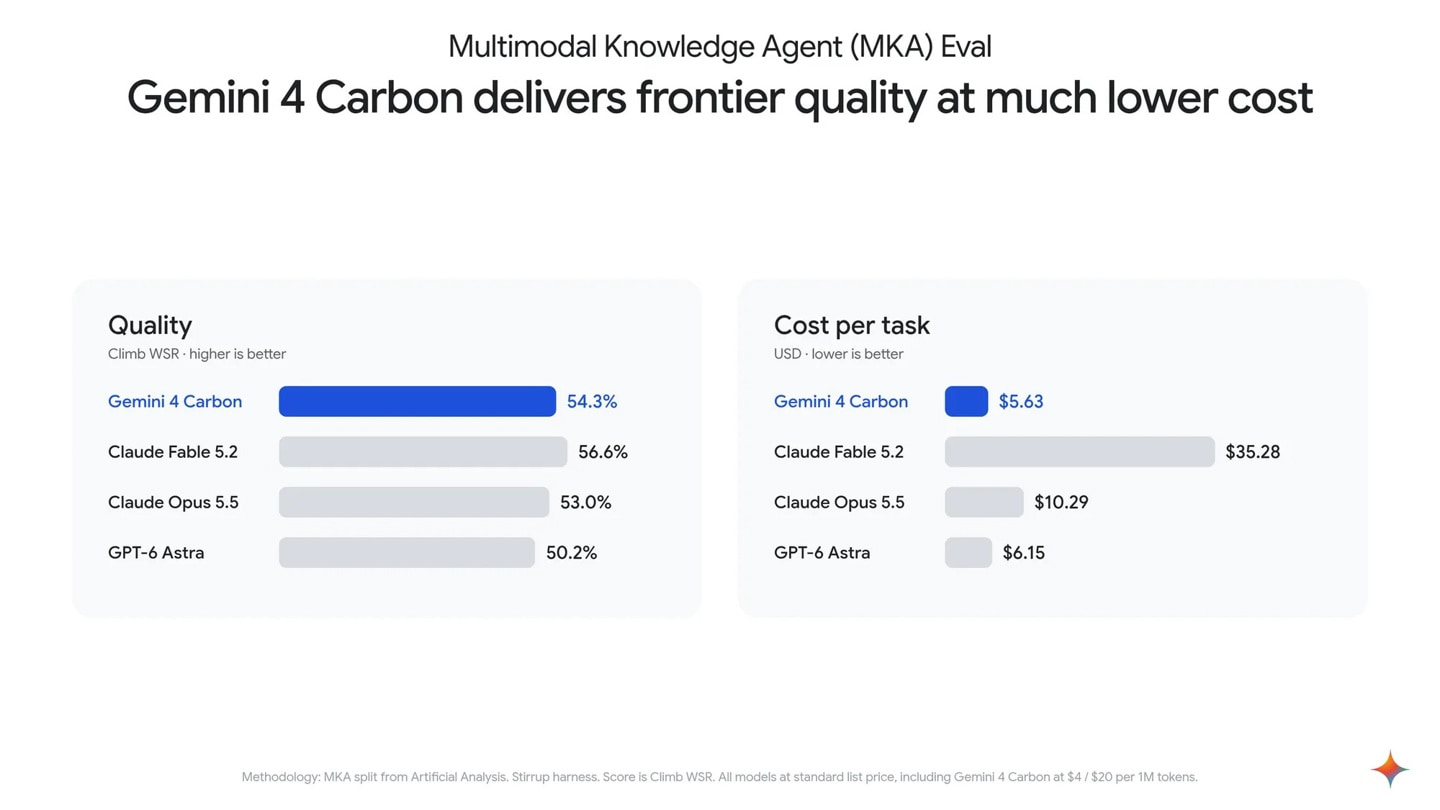
谷歌公布的结果是:Gemini 4 Carbon 在参测模型中质量排名第二,平均任务成本约为第一名的六分之一。
这个结果值得关注,因为实际使用智能体时,质量与成本需要一起算。但报道没有给出第一名的名称、双方具体质量得分、绝对成本,以及各行业任务的成绩分布。第二名与第一名究竟差多少,单靠名次无法判断。
不同模型平均每项任务消耗的交互轮次在 30 至 130 轮之间,也说明同样的任务可能走出很不一样的执行路径。不过,轮次少并不自动代表费用低或耗时短,还要看单轮价格、输入输出规模和工具执行时间。
六分之一是这次评测中的平均成本比例,不能直接当成团队接入后的省钱比例。
报道还称,开发者可以通过 Artificial Analysis 评估模型;Gemini 4 Carbon 已通过 Gemini API 在 Google AI Studio 中提供。这些是报道中的可用性信息,文中没有提供具体调用参数或接入代码。
我的判断
我认同它把验收对象推进到最终文件。相比只检查回答文本,打开文件、渲染页面、核对公式,更接近知识工作真正需要承担的交付责任。
但统一使用 Stirrup,也给结果划定了范围:测到的是模型在这套框架、工具和预算下的表现。换成团队自己的智能体流程,排名与成本都可能变化。
这里的质量与成本结论来自谷歌公布的评测结果,并非一般性的经验判断;不过,原文没有给出足够的对照明细,尚不足以替「性价比更高」作普遍背书。尤其对以前端和全栈为主的团队,跨行业综合第二名,不能直接推出它写业务代码也更好。
能拿来做什么
- 给文档、报告或表格智能体设计验收时,把「文件能打开」「内容可核对」「公式可执行」写进检查项,别只判断最后一条回复是否像完成了任务。
- 比较模型时,同时记录质量、平均任务成本和交互轮次,再结合自己的真实任务判断取舍,避免仅凭总榜名次选型。
- 如果工作流涉及复杂图片与多份文件,可以先用公开的 10 项任务了解 MKA 格式,再建立自己的小型评测集;纯代码补全场景则需要另找对应证据。