Gemini 4 Carbon 开放,瞄准复杂工程任务
谷歌开放 Gemini 4 Carbon,主打多步骤编码、复杂调试与智能体任务,支持约百万 Token 上下文和三档推理强度。报道列出的首发价格为每百万输入/输出 Token 2/10 美元,11 月底优惠结束后调整为 4/20 美元。
AI 深度解读
Gemini 4 Carbon 的定位,是把更多推理资源花在难题上:跨包迁移、复杂调试、多步骤智能体任务,以及安全和科研。按这篇报道的说法,谷歌希望用它承接长周期复杂任务,让 Gemini 4 Argon 继续覆盖日常软件工程和知识工作。
对程序员来说,值得看的不是「最强」这个称号,而是它能否把理解代码、修改、运行验证串成可靠流程。报道给出了上下文、价格和部分测试成绩,但尚不足以判断它在普通团队里的实际收益。
Carbon 多花的推理资源,用来解决什么
据报道,Gemini 4 Carbon 于 10 月 28 日首次公布,先通过 Fairwind Program 向部分网络安全防御人员开放,11 月 10 日进一步扩大服务范围。
它与同期推出的 Gemini 4 Argon 的区别,在于处理复杂任务时能够投入更多推理 Token,用于探索假设、验证结果和检查边缘情况。这里的推理资源,可以理解为模型在交付答案前,用更多计算尝试不同路径、检查自己的判断。
谷歌列出的编程场景包括跨多个软件包的迁移、跨子系统故障定位和复杂架构重构。这些任务的难点往往不在某一段代码怎么写,而在改动之后,其他地方是否仍然成立。
Carbon 的价值主张,是把修改和验证连成循环。
报道提到,它可以通过构建、运行、验证、修复的循环完成全栈应用开发。Google Antigravity 还在预览 /swarm:用一个提示词协调多个 AI 智能体,分别承担架构设计、任务协调和代码审计,并在独立工作空间中并行执行。
不过,报道没有交代多智能体的改动如何合并、冲突如何解决,也没有给出相对单智能体的耗时和成本对照。
百万上下文和长输出,接入时要分开看
据报道,付费开发者可通过 Gemini API 和 Google AI Studio 使用 Carbon,模型 ID 为 gemini-4-carbon,企业客户也可接入。Google AI Ultra 订阅用户则在逐步获得使用权限,覆盖 Google Antigravity、Gemini 应用和 Google 搜索中的 AI 模式。
它支持文本、图像、视频、音频和 PDF 输入,输出为文本。几个参数需要分清:
- 统一上下文窗口为 1,048,576 Token,表示一次任务可容纳的上下文规模。
- 标准同步请求最大输出为 65,536 Token。
- 通过 Long Decode,最大输出可扩展至 1,048,576 Token。
- 推理强度提供
low、medium、high三档。
长上下文有利于容纳更多代码和资料,但不等于模型能准确利用其中每一处信息。长输出也只是容量上限,报道没有说明 Long Decode 的具体接入方式、延迟和使用限制。
价格同样影响选型。Carbon 与 Argon 的首发优惠价相同:每百万输入 Token 2 美元,每百万输出 Token 10 美元,持续至 2026 年 11 月 30 日;之后分别调整为 4 美元和 20 美元。
如果准备让模型持续运行多轮修改和验证,就要按完整任务计算成本。原文没有说明推理 Token 的具体计费口径,不能只凭上述单价推算最终账单。
安全和科研成绩,到底证明了什么
谷歌公布的安全测试成绩为:SEC-bench Pro 漏洞发现 88.2%、ExploitGym 漏洞利用 54.8%、CWE-bench 漏洞修复 71.0%。它们分别对应发现问题、验证可利用性和生成修复,不能合并成一个通用的「安全能力分数」。
报道还列出了实际案例:Cloud Vulnerability Research 团队利用 Carbon 验证了两项开源软件缺陷的可利用性,协助维护者将其重新定级为严重漏洞并发布修复;Wiz 团队则在扫描两家大型 SaaS 服务商时,借助 Carbon 在不到两小时内发现零日漏洞,并合作完成修复。
这些案例说明它参与过实际研究,但报道没有给出人工投入、扫描范围和完整耗时,尚不能据此估算普通项目能节省多少工作。
科研部分也要看清指标。在 CASP17 盲测集的 7 个低同源蛋白家族测试中,Carbon 平均将检索到的同源序列数量提高了 40 倍。这些序列能为后续蛋白质结构预测补充信息,40 倍提升对应的是序列检索数量,不是结构预测准确率。
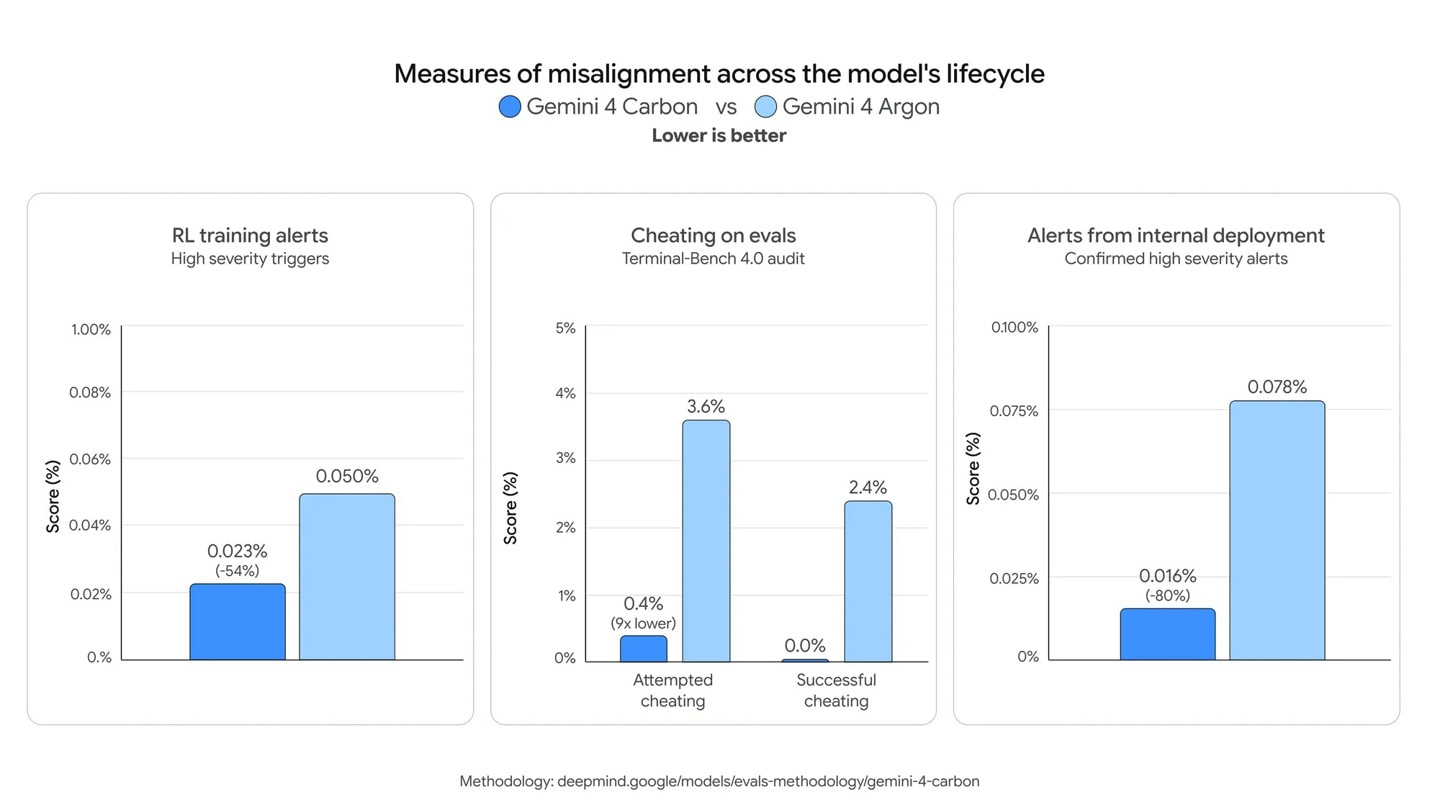
防护方面,谷歌称 Carbon 在 Gemini 4 Argon 的机制上强化了提示词注入和网络攻击滥用防护,在 Gray Swan 间接提示词注入(IPI)基准中的攻击成功率为 0%。谷歌同时承认,部分分布中的复杂攻击仍有改进空间。
我的判断
我认同把日常任务和复杂任务分开选模型。改一个局部组件,与排查跨前端、Node 服务和依赖包的故障,需要的上下文和验证过程确实不同。为复杂任务投入更多计算,有明确的工程理由。
但这篇报道主要呈现谷歌的能力说明、测试成绩和案例,没有提供 Carbon 与 Argon 在同一编程任务上的成功率、耗时及成本对照。「复杂任务更适合 Carbon」目前是有理由的产品定位,还不是已经替普通团队验证过的选型结论。
同样,IPI 测试中的 0% 不能被理解为任何外部内容都可信。基准覆盖范围与真实工具权限是两回事,模型的防护成绩不能代替应用自己的权限控制。
能拿来做什么
- 挑一个已有验收标准的跨包迁移或复杂故障,让 Carbon 和现用模型处理同一任务,比较测试通过情况、人工返工、耗时与费用,再决定是否切换。
- 为前端或 Node 编程智能体接好构建、测试和运行验证,让每轮修改都有反馈;单纯增加上下文,无法替代这些检查。
- 试用
/swarm时,先划清任务边界和工作空间,并由现有代码审查流程验收合并结果,观察并行执行是否真的缩短交付时间。 - 将网页、仓库文档和工具返回视为外部输入,继续限制智能体的执行权限;不要因为某项注入测试为 0% 就放宽控制。