SageMaker 开放免管 GPU 的自定义训练会话
SageMaker AI 的无服务器模型定制新增正式可用的训练会话,允许开发者自行编排后训练循环。开发者可定义损失函数、奖励信号或多轮强化学习流程,GPU 分配、分布式执行和故障恢复由服务承担。
AI 深度解读
AWS 这次给 SageMaker AI 增加的 training sessions,重点是让开发者自己编排模型后训练,同时把 GPU 分配、分布式执行和故障恢复交给平台。你可以决定怎么采样、怎么打分、怎么更新模型,不必先搭一套训练集群。
它值得关注的场景是多轮 Agent 训练:一次工具调用正确,不代表整个任务完成。平台试图降低这类训练的基础设施门槛,但任务环境、奖励设计和效果验证,仍然需要团队自己负责。
自己写训练循环,平台接手哪些工作
原文先提出一个判断:把业务上下文、产品目录或专业词汇用于定制开放权重模型,能够提高任务准确率,并降低运行成本。但文章没有给出统一的对照实验,这更像产品介绍的出发点,不能理解为所有任务都值得微调。
training sessions 已正式可用。它在 SageMaker AI 已有的无服务器模型定制能力上,开放了更底层的控制:开发者可以编写训练循环、自定义损失函数和奖励信号,协调不同训练阶段。
平台负责 GPU 分配、分布式执行、故障恢复和检查点存储。用户不需要选择实例类型、管理集群或编写分布式训练配置。
基础设施可以托管,训练目标仍然要由开发者定义。
支持的技术包括监督微调(SFT)、直接偏好优化(DPO)、可验证奖励强化学习(RLVR)、AI 反馈强化学习(RLAIF),以及多轮强化学习(multi-turn RL)。模型更新可以选择低秩适配(LoRA)或全量微调,也可以通过 continuous customization 串联多种技术。
这些选项解决的问题不同。SFT 让模型学习示例,DPO 利用回答之间的偏好,强化学习则依赖奖励引导行为。选项多,代表可控制的空间更大,也要求团队判断自己的数据究竟能提供哪种训练信号。
多轮 Agent 为什么需要拆开采样、评分和更新
订旅行、分流客服工单、多步研究,都可能经过多轮交互才能判断成败。训练这类 Agent 时,模型生成回复只是其中一步,还要运行工具、观察结果、评分,再更新模型。
这些阶段的计算需求不同。原文指出,如果训练、推理和评分分别放在不同工具或集群上,连接它们就会增加工作量。
training sessions 的分工是:开发者的环境运行训练编排和奖励函数,并连接工具或模拟器;平台中的 sampler 生成回复,trainer 计算梯度并更新权重。
原文用组相对策略优化(GRPO)说明这个过程。它针对同一个提示生成多个回答,根据回答之间的相对表现更新模型:
- 训练循环请求 sampler,为每个提示生成多个回答。
- 本地环境中的奖励函数使用验证器、奖励模型或测试框架评分。
- 分数送回 trainer,
forward_backward()计算梯度,optim_step()更新模型权重。 - 请求 session 用更新后的权重刷新 sampler,再处理下一批。
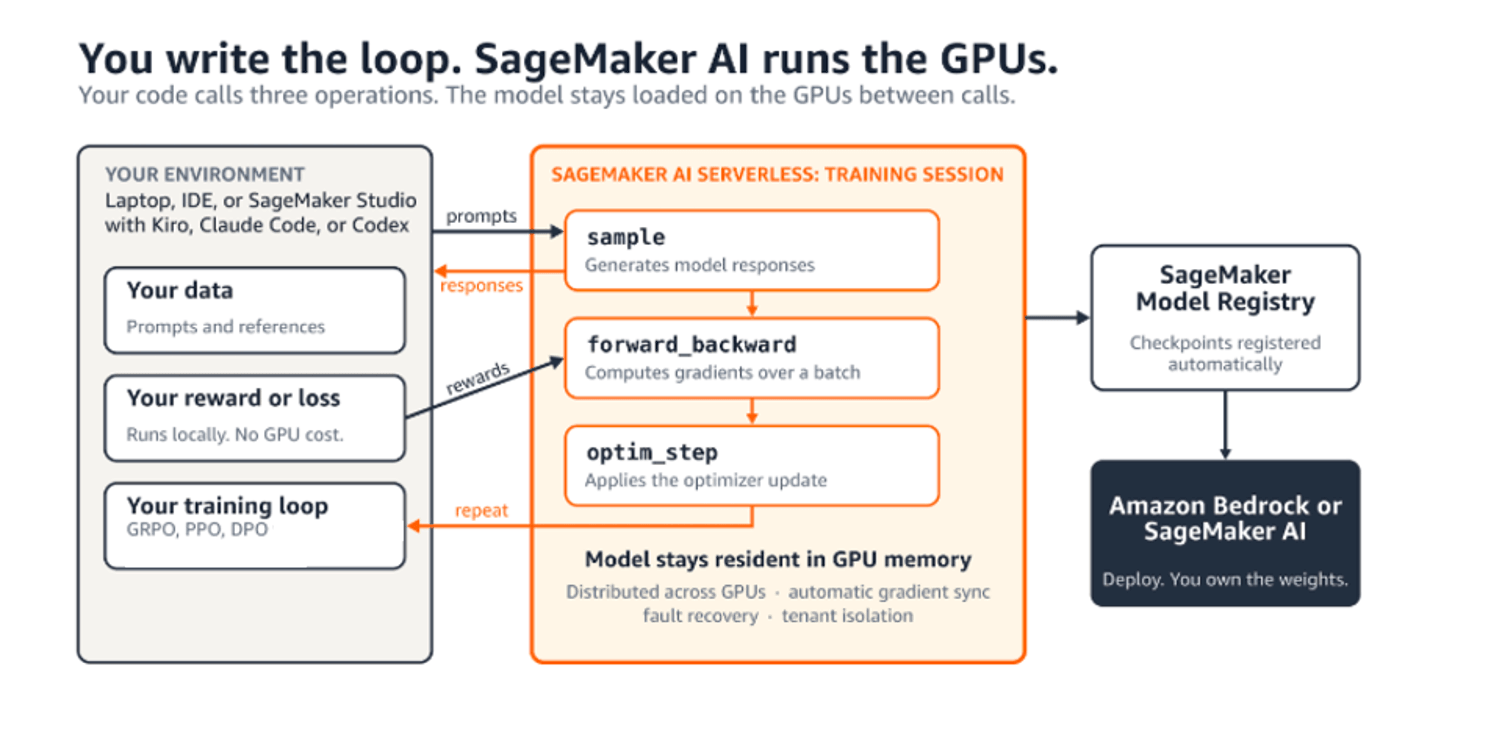
这里最容易漏掉的是最后一步。权重更新之后,还要刷新 sampler,后续采样才能使用更新后的模型。
计费按 SageMaker AI 处理的 token 计算。当奖励函数在用户环境中为一批结果评分时,平台计量暂停,也不需要预留容量。不过,外部工具、评分环境和数据处理是否产生其他费用,原文没有展开,不能把暂停计量理解成整个流程没有成本。
支持哪些模型,数据和检查点放在哪里
原文列出的支持模型是 gpt-oss-20b、gemma-4-31B-it、Qwen3.6-27B 和 Qwen3.8-27B。文章没有列出各模型在不同训练技术下的具体限制。
每个 session 使用用户创建的 AWS Identity and Access Management(IAM)执行角色,可以配置自己的 AWS Key Management Service(AWS KMS)密钥和虚拟私有云(VPC)。数据保留在用户选择的 AWS Region、自己的 Amazon Simple Storage Service(Amazon S3)桶中,检查点也写入那里。
AWS 表示,不会使用用户数据或定制后的权重训练其他模型。部署前可以评估准确性、偏差和安全性;部署后可以应用 guardrails,并通过 Amazon CloudWatch 监控。这些能力有助于接入已有治理流程,但不会自动完成模型验收。
入门有两条路径。在 IDE 中,需要 Linux 或 macOS,以及 Python 3.10 到 3.12,安装 SageMaker Python SDK、克隆 cookbook 后开始开发。在 SageMaker Studio 中,原文称可在 20 秒以内启动开发环境,再打开 notebook、连接编程 Agent,并下载 skills 和 cookbook。
配套 Agent 支持 Kiro、Claude Code、Codex 和 GitHub Copilot,可协助数据准备、技术选择、训练、评估和部署。这里的 20 秒指环境启动,不是完成模型训练。
我的判断
我认为它最有价值的地方,是允许团队保留训练逻辑的控制权,同时减少 GPU 运维工作。对已经有评测集、奖励函数或工具模拟环境的团队,这个分工比较清楚。
但原文的效果证据主要是客户引述。ImagineSoftware 用它构建医疗理赔拒付分流模型,认可底层 API 和训练控制能力;Karini AI 则用 gpt-oss-20b 训练面向 Amazon Neptune 知识图谱的多轮工具调用,并肯定了检查点恢复能力。
这些反馈支持「平台可用于实际项目」,却没有证明准确率提高多少、训练成本降低多少。文章没有公布基线、样本量或训练时长,也没有给出和自建集群的对照数据。有关易用性和恢复可靠性的评价,目前应当视为客户经验。
最难外包的部分,是判断什么行为应该获得奖励。
如果任务只是补充经常变化的业务知识,检索增强生成(RAG)通常值得先比较;如果主要问题是工具参数错误,也可以先调整提示词、参数校验和工作流。只有现有方案在明确评测下持续暴露行为问题,后训练的投入才更容易衡量。原文没有做这些方案之间的比较。
能拿来做什么
- 如果正在做多轮工具调用 Agent,可以先把完整任务整理成可重复运行的评测,记录最终是否完成、工具调用是否正确,再判断是否需要训练。
- 如果希望尝试 GRPO,可以先验证同一提示的多个回答能否被稳定评分。测试框架能给出奖励,不代表奖励足以代表真实任务质量。
- 如果团队已使用 AWS,可以用支持的模型跑一个小规模训练闭环,检查采样、评分、更新和检查点恢复是否满足需求,并核算包含外部评分环境在内的成本。
- 如果只是想让前端或 Node 项目中的 AI 功能了解业务资料,可以先比较提示词、RAG 和工作流调整的效果,再决定是否引入模型后训练。