四个九可用性为何需要自动止损
99.99% 可用性在滚动30天内仅容许约4.3分钟停机,人工接警流程可能耗尽预算。文章提出用多窗口错误预算消耗率告警、自动止损和人工治理改进响应。
AI 深度解读
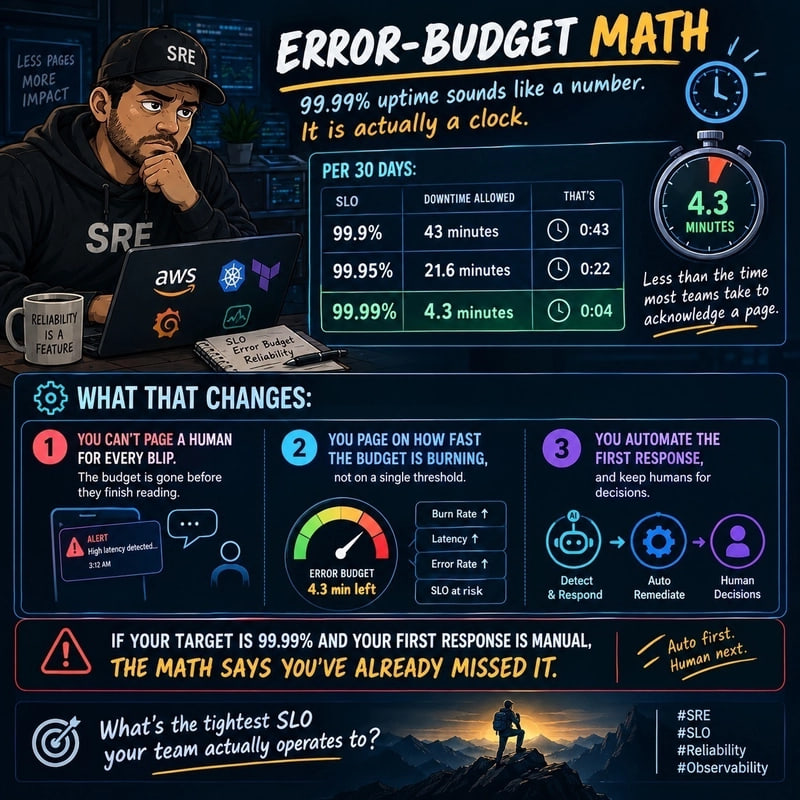
99.99% 可用性听起来很稳,放进滚动 30 天的窗口,却只允许累计停机 4.32 分钟。作者据此提出:如果故障后的第一步还是等值班工程师读告警、连 VPN、手动操作,响应链路就可能吃光预算。
文章给出的调整是:按错误预算的消耗速度告警,让自动化先止损,再由人决定后续处置。这套思路有用,但「四个九必须自动化」的结论,还得结合故障范围、检测延迟和剩余预算来看。
四个九为什么会变成倒计时
先分清两个概念:SLO 是内部服务目标,SLA 是对客户的合同承诺,通常更宽松。原文主要讨论 SLO,结尾才把要求延伸到 SLA。
在滚动 30 天、共 43,200 分钟的窗口内,不同目标对应的停机预算如下:
| SLO | 停机预算 |
|---|---|
| 99.9% | 43.2 分钟 |
| 99.95% | 21.6 分钟 |
| 99.99% | 4.32 分钟 |
差一个小数位,留给响应的时间就可能差一个数量级。
不过,4.32 分钟是整个月的总预算,不是每次故障都能重新领取的额度。窗口内已经发生过故障,剩余时间还会更少;如果只是部分请求失败,也不能直接按全面停机的速度计算。
告警应该看错误增长有多快
作者建议用燃烧率(burn rate)衡量错误预算的消耗速度:
burn_rate = observed_error_ratio / (1 - SLO)
当 SLO 为 99.99% 时,允许的错误比例是 0.0001。燃烧率为 1,表示按当前速度,30 天刚好用完整个预算;燃烧率为 14.4,对应 0.144% 的错误比例,每小时消耗月预算的 2%;全面停机时燃烧率达到 10,000,4.32 分钟就会耗尽预算。
下面这段计算器把错误比例转换成燃烧率,再估算预算耗尽时间:
def burn_rate(error_ratio: float, slo: float) -> float:
    return error_ratio / (1 - slo)

def minutes_to_exhaust(burn: float, window_minutes: int = 43_200) -> float:
    return window_minutes / burn

slo = 0.9999
print(burn_rate(0.00144, slo)) # 14.4
print(minutes_to_exhaust(14.4) / 60) # ~50 hours to empty the month
print(minutes_to_exhaust(10_000)) # 4.32 minutes: total outage
要留意 window_minutes / burn 这一行:它假设预算完整、燃烧率持续不变,没有扣除窗口内已经花掉的预算。
原文引用 Google SRE Workbook 的思路,配对使用长短窗口:长窗口判断问题是否持续,短窗口确认问题此刻仍在发生。
| 动作 | 燃烧率 | 长窗口 | 短窗口 | 消耗预算 |
|---|---|---|---|---|
| 呼叫值班人员 | 14.4 | 1h | 5m | 2% |
| 呼叫值班人员 | 6 | 6h | 30m | 5% |
| 创建工单 | 1 | 3d | 6h | 10% |
这些比例对应各自长窗口内的预算消耗。它们适合表达告警紧迫程度,不能直接当成四个九服务的完整止损方案。
自动化先刹车,人来划定边界
作者给出的最小决策逻辑是:先检查 first_brakes_enabled 开关,再检查 actions_last_hour 是否达到 max_actions。自动化被关闭,或者动作次数用尽,就通知人工接管。
允许执行时,如果 ctx.deployed_within(minutes=30) 成立,就调用 ctx.rollback_last_deploy();否则执行 ctx.shed_load()。完成后用 ctx.record(alarm) 记录,再通过 ctx.page() 通知工程师。熔断也是作者列出的可选动作。
先止损,再让人带着操作记录接手,是这套方案最有价值的顺序调整。
但「最近 30 分钟发布过」只是回滚条件示例,不足以证明发布就是故障原因。自动化也会制造故障,因此作者要求限制影响范围、限制动作频率、保留独立关闭开关,优先选择可逆操作,并通过故障演练验证。
人的工作则前移到规则设计:确定 SLO、燃烧率阈值、自动化权限和触发条件,再通过事后复盘调整边界。
我的判断
我认同作者把响应时间放回预算里计算。只盯错误率是否越线,很容易忽略同样的错误比例对不同 SLO 有完全不同的紧迫程度。
但「收到告警时就已经违约」说得过满。人工是否来得及,取决于剩余预算、故障范围和发现速度。原文没有提供团队实测、恢复耗时,也没有给出人工响应与自动化响应的对照数据。这是一套设计建议,不能当成验证过的收益报告。
监控粒度也是硬约束。作者说 1 分钟指标抓不住 5 秒事件,更准确地理解,应是分钟级指标无法保证及时识别和响应短故障;是否保留这段错误,还取决于采集与聚合方式。
此外,5 分钟短窗口不能自动保证在 4.32 分钟内完成检测和处置。四个九服务需要单独核算检测、评估、执行以及恢复的总耗时。
能拿来做什么
- 给 Node API 或全栈服务设定 SLO 时,同时写出滚动窗口、错误口径和预算分钟数,让团队知道故障究竟能持续多久。
- 检查现有告警能否区分持续故障与瞬时尖峰,参考长短窗口配对设置燃烧率告警,并单独验证全面故障的检测速度。
- 如果发布平台已经支持回滚,先选一个影响范围可控、动作可逆的场景接入自动止损,同时保留次数限制、关闭开关和操作记录。
- 在故障演练中测量从异常出现到止损生效的完整耗时,再判断当前监控与响应链路是否撑得住目标 SLO。